你身体里大约有两万种蛋白质。其中只有不到七百种有获批药物,约占3%;而高达87%的蛋白质既无药物也无强效配体,它们被称为难成药靶点。
它们不是不重要。恰恰相反,它们往往是癌症、自身免疫病、神经退行性疾病的关键开关。但它们缺少一样东西:一个清晰可辨的三维形状。
"如果你试着折叠一个转录因子——那种负责开关基因的蛋白质——你只会得到一盘意大利面。"Talus Bio联合创始人Lindsay Pino说,"你没法在一盘意大利面上做药物发现。"
这就是过去几十年药物研发的困局:要找到能结合某个蛋白质的小分子,你必须先知道这个蛋白质长什么样——它的三维结构里有没有一个足够深的"口袋",能让药物分子像钥匙插进锁孔一样嵌进去。而对大约半数人类蛋白质来说,这道前提根本就不成立。它们的氨基酸链在细胞里东扭西晃,拒绝固定成一个稳定的折叠形态。在纯化出来的一瞬间,结构生物学家的实验手段——用X射线照晶体、超低温冷冻后电镜扫描、磁场共振测原子核——就集体失灵了。
2026年10月,Pino的团队把一款叫Ptarmigan-1的AI模型放上了公开门户。它做了一件让结构生物学家不太舒服的事:彻底绕开蛋白质三维结构。
不建锁,画地图——把筛选变成一次检索
传统虚拟筛选的流程是这样的:取一个蛋白质的三维结构,取一个小分子的化学式,让计算机模拟两者在三维空间里能不能嵌合。一个化合物,一次模拟。一百万个化合物,一百万次模拟。
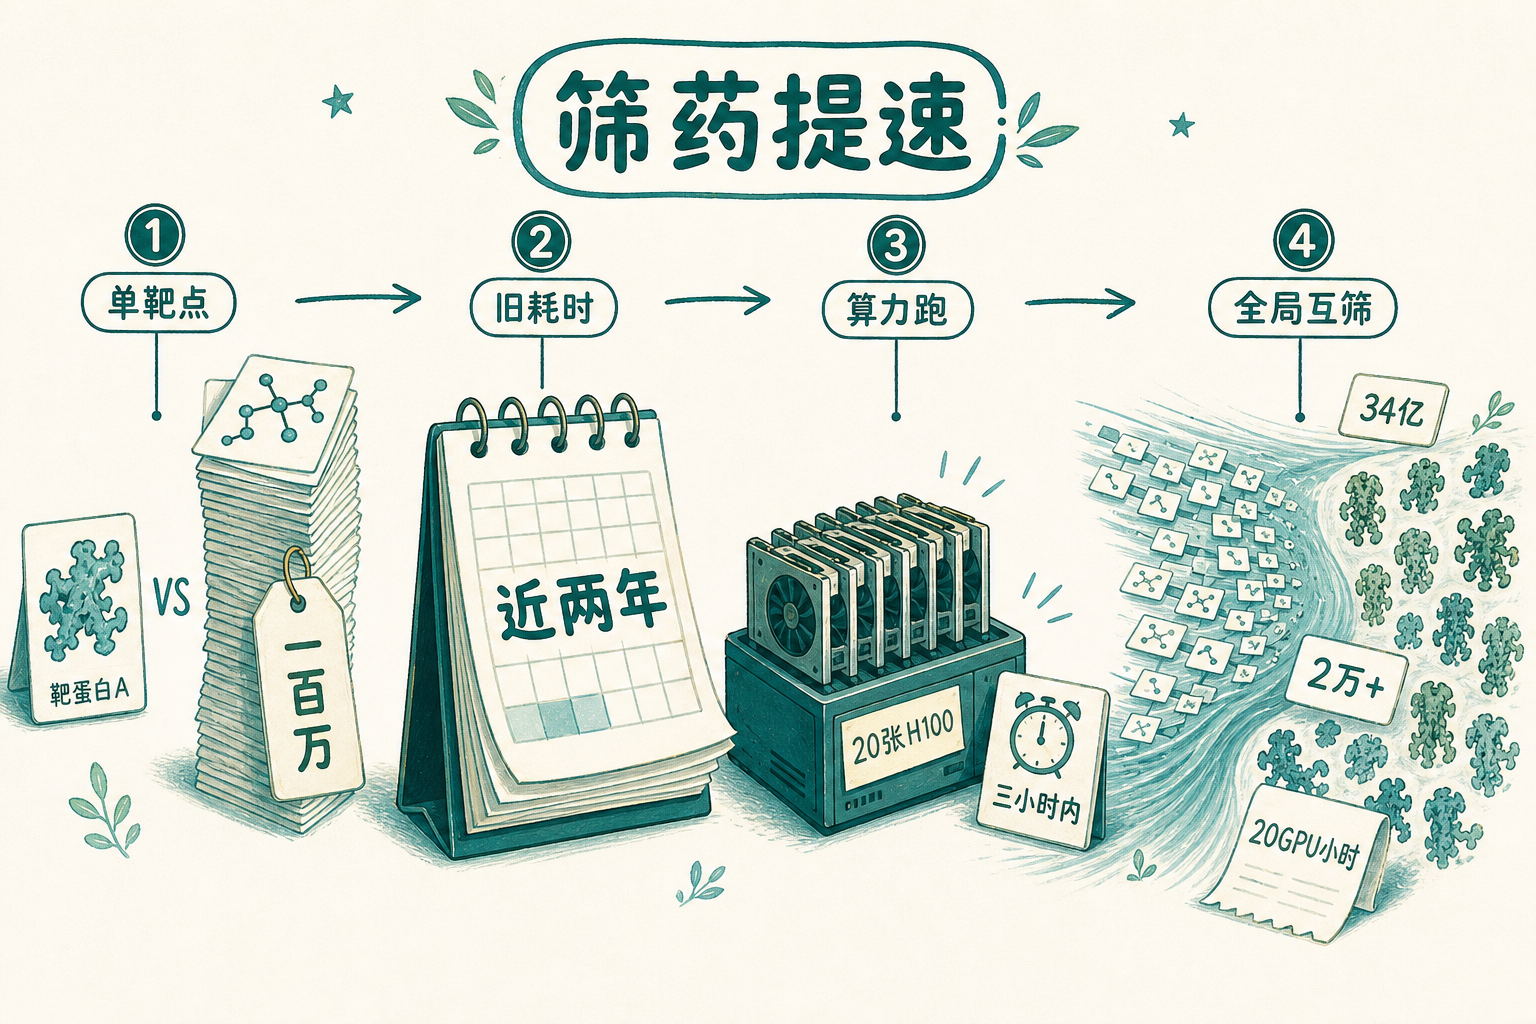
这套流程笨重到了荒谬的程度。即使把最快的开源工具——一个叫Boltz-2的共折叠模型,它能同时预测蛋白质和药物分子各自的三维结构再判断能不能嵌合——搬上英伟达H100显卡,对单个化合物打一次分也要54秒。按这个速度,一个靶点筛一百万种化合物,耗时将近两年。把34亿种化合物筛遍两万种人类蛋白?算力账单会让任何药企的CFO眼前一黑。
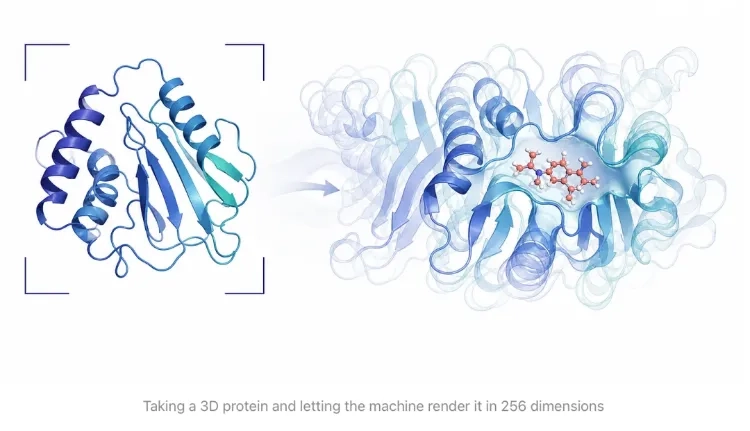
Ptarmigan-1换了一种完全不同的思路。它不模拟三维嵌合。它问的是另一个问题:这个分子和这个蛋白质的每一个残基——也就是构成蛋白质链条的一个个氨基酸单元——在机器更擅长理解的256维空间里,距离有多近?
具体做法分两步。第一步,用两个编码器分别处理输入:一个读蛋白质的氨基酸序列,就像读一串由20种字母组成的超长单词;另一个读化合物的化学式。第二步,两个编码器各自把输入压缩进同一个256维空间,每个残基和每个化合物都变成这片空间里的一个坐标点。训练目标极其直接:真实会结合的分子和残基,在空间里要被拉得很近;不会结合的,要推得很远。
这和十年前自然语言处理领域发生的一场范式转换几乎如出一辙。当年做机器翻译,主流方法是先建句法树——把句子画成一棵显式的语法结构图,再在树上做转换。后来有人发现:根本不必建树,把词嵌进高维向量空间,语法和语义关系就自动编码在几何距离里了。"国王减男人加女人约等于女王"——这个著名的公式背后没有一棵句法树。后来的BERT模型更进一步,在大规模文本上预训练这种嵌入,直接改写了数十项语言任务的最优记录。Ptarmigan-1对药物筛选做的事,本质上是一样的:不建三维锁孔模型,直接把蛋白质和化合物放进同一个空间,让"结合关系"变成"空间邻近度"。
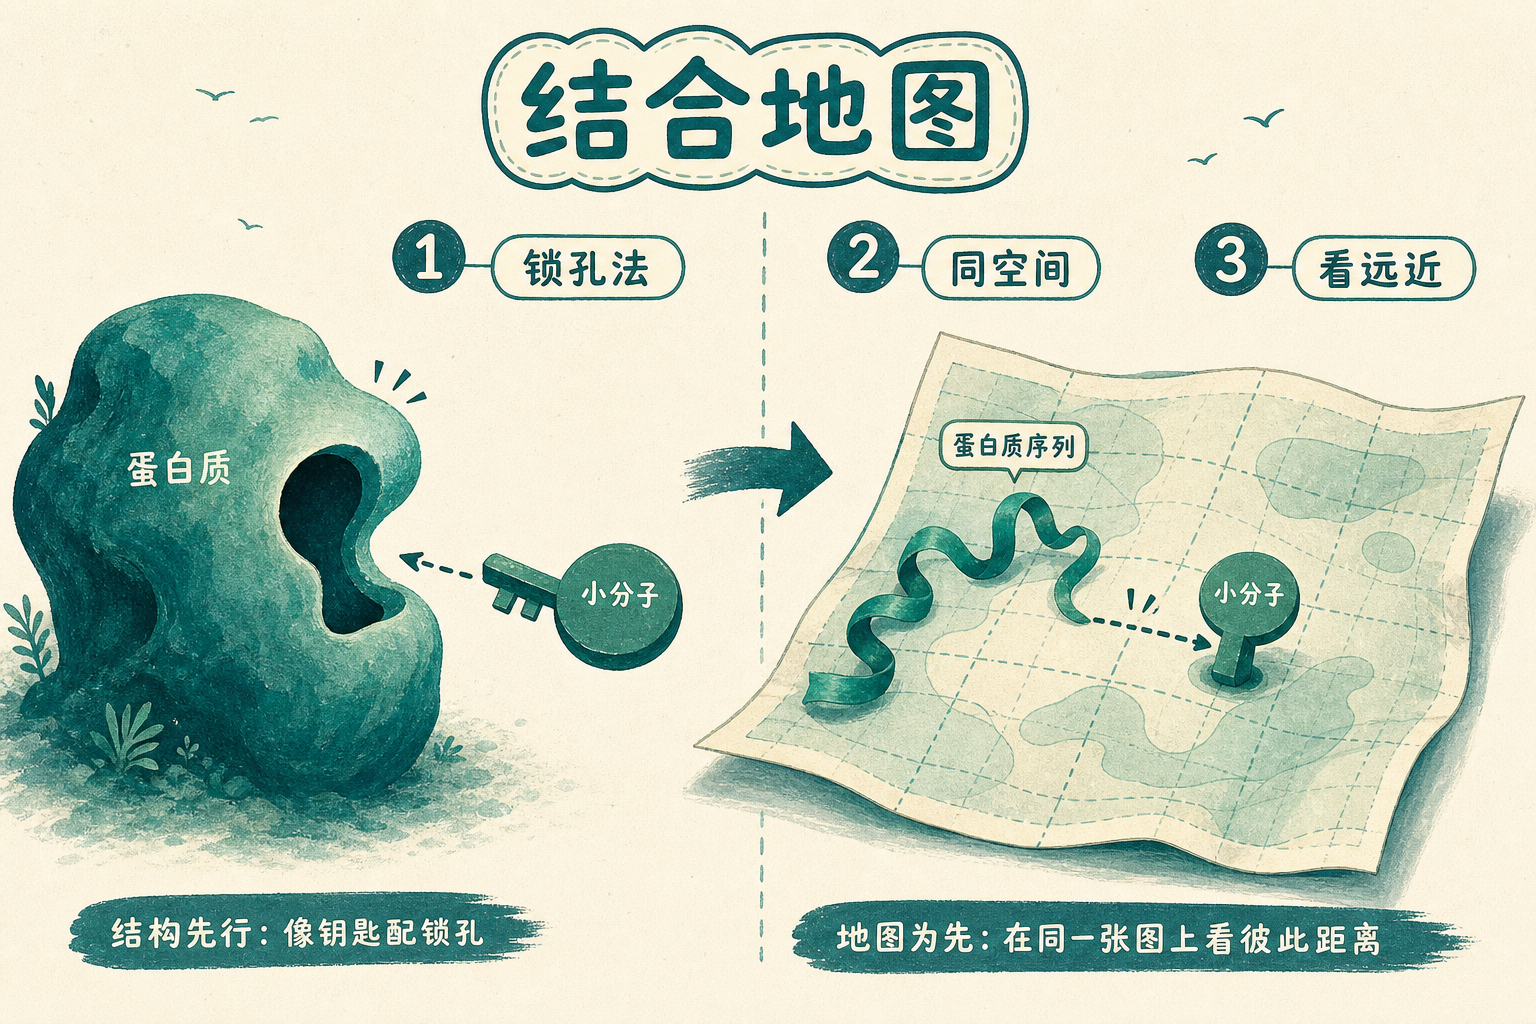
类比一下,传统的结构模拟相当于每次有人想找最近的咖啡店,你都先搭一套街区的三维模型,再让AI在里面走一遍。Ptarmigan-1的做法是把所有咖啡店和所有街区一次性标在一张大地图上。查一次,建立坐标系。之后任何查询,都只是在这张地图上找距离最近的店。
"没人会为每次搜索重新建一遍谷歌地图,"Talus的博客写道,"Ptarmigan-1的地图建一次,反复查。"
这张地图的训练数据也跟传统模型不一样。大多数药物筛选AI吃的是"这个分子有没有活性"的二元标签,训出来的只能做是/否判断。Ptarmigan-1的训练数据大量来自化学蛋白质组学实验——一种在活细胞里直接标记小分子结合到了蛋白质哪个具体氨基酸位置的技术。所以它学到的不仅是"是否结合",更是"结合在哪儿"——把二元分类升级成了空间定位。
正是这个差别,让模型出现了一种训练目标里没有明确写入的行为。团队把KRAS G12C——一个因突变驱动多种癌症的著名靶点——的相关分子按真实研发代际输入模型:从筛选中最早找到的活性分子到后期经过多轮优化的候选药物,模型自动排出了正确的时间顺序。而如果把G12C突变改回正常的、未突变的蛋白序列,预测活性立刻消失。这说明模型捕捉到的是相互作用规律本身,不是死记训练集里的答案。
更直观的验证来自STAT6,一个转录因子。转录因子是"意大利面"的极致代表:纯化出来几乎没有固定形状,传统结构方法根本无从下手。团队做了一次严苛的盲测:把40个已知有效的STAT6抑制剂混入大量结构相似的干扰分子,所有STAT6数据在训练阶段被刻意剔除。结果是,模型以0.94的高分找回活性分子并准确定位了结合残基——而依赖三维结构的基线方法得分仅0.58,跟抛硬币差不多。
快5000倍之后,谁先拿到门票
10毫秒对54秒——单次打分相差约5000倍。这个数字直接改写了药物筛选的经济学。
一个靶点筛一百万化合物,从接近两年压缩到三小时以内。如果上20张H100显卡跑一整天,可以完成34亿种化合物对两万多种人类蛋白的全局互筛,总成本仅20个GPU小时——折算下来,电费和算力加起来大约相当于在云上租几台机器跑一天,比传统方案便宜了几个数量级。同样的任务如果走共折叠路线,算力需求高到"难以落地"——这是Talus预印本里的原话。
但速度不是这个故事里最有意思的部分。传统上,一家药企启动筛选项目之前要做的第一件事是"这个靶点的结构能拿到吗"。X射线晶体学可能需要数月到数年,前提还得是蛋白质愿意结晶。很多有前景的靶点在进入筛选阶段之前就被判了死刑——不是因为没药可治,而是因为结构拿不到。Ptarmigan-1把前置条件从"有没有结构"改写成了"有没有序列"。而序列,在人类基因组计划完成二十多年后的今天,几乎是免费的。
当然,它不会取代结构方法。在药物筛选的标准评测集上,Ptarmigan-1排名第二,仅次于Boltz-2——在折叠良好的经典靶点上,有三维结构可用时,扔了它是浪费。CEO Alex Federation的定位很清楚:先用Ptarmigan-1从几十亿种化合物中做低成本初筛缩圈,再把胜出的候选分子交给结构模型做精细解析。分工,而非替代。
这也是整个AI制药赛道正在发生的变化。Insilico Medicine靠AI端到端设计新分子,2025年刚完成1.1亿美元E轮融资,对外授权累计超21亿美元。Recursion通过大规模细胞图像实验反向推断药物-靶点关系,从赛诺菲和罗氏拿到了数亿美元的里程碑付款。Ptarmigan-1切的是另一个战场——筛选层,瞄准的恰好是AlphaFold(谷歌DeepMind的蛋白质结构预测AI)和Boltz生态的盲区:那40%到50%无法稳定折叠的人类蛋白质。
对正在学生物、化学或药学的人来说,这里有一个很具体的信号:药物发现的瓶颈正在从"能不能拿到结构"前移到"能不能在海量化学空间中做精准检索"。未来几年最活跃的交叉地带,可能不再是结构生物学家的冷冻电镜技巧,而是谁能训练出更好的序列-化学空间映射——蛋白质语言模型和对比学习,恰好是两个正在高速发展的方向。
但这张地图也有盲区
值得冷静地摆出一件事:Ptarmigan-1的所有结果都来自公司自己的预印本。模型权重和代码没有公开——开放访问不等于开源。独立第三方无法复现,更无法验证那些亮眼的数字能否在其他实验室里重现。
还有更根本的挑战。蛋白质不是静态的。即使在有清晰三维结构的蛋白质里,药物结合的过程也常常伴随构象变化——蛋白质在结合瞬间会"变形"来适应药物分子,这叫诱导契合。一个只看序列的模型能不能捕捉到这种动态的"握手"过程?目前没人知道。实际上,就连AlphaFold3在构象变化超过一定幅度时也会失效。这不是结构模型独有的短板,而是整个领域共同面对的前沿问题。
另一个容易被忽略的约束来自训练数据。Ptarmigan-1的训练集里有大量化学蛋白质组学数据——在活细胞里精确标记结合位点,需要精巧的实验设计和昂贵的试剂。模型的"免费"是建立在昂贵数据之上的。它的天花板,最终由训练数据的质量和覆盖范围决定。
而前瞻性验证——用这个模型真的找到一个全新药物,推进到临床前乃至临床阶段——仍然为零。STAT6和KRAS的盲测属于回顾性实验:已经知道答案,只看模型能不能"猜"回来。真正的考验,是从零开始,用这张地图找到一个没人知道会结合的分子,然后在真实细胞里验证它确实有效。
但也许最值得关注的不是Ptarmigan-1本身,而是它撬开的那条缝。几十年来,"不可成药"是一个自我实现的预言:因为拿不到结构,所以不筛;因为不筛,所以永远没药。这个预言的锁,第一次出现了一把能转动的钥匙——不是因为它造出了更精细的锁孔模型,而是因为它终于问了一个不同的问题。
过去找药靠"看得见的锁孔"。现在,锁还没造好,地图已经画出来了。