你打开LinkedIn搜「记者」,心里想的是写深度报道、做采访——结果前几条结果全是法庭记录员。因为旧系统的逻辑很简单:reporter这个词出现在职位描述里,就给你推,不管它指的是「出镜记者」还是「庭审速记员」。它不会读心。
这个看似琐碎的搜索失败背后,是一个在互联网公司里反复重演的技术困局:大模型足够聪明,但太慢太贵;小模型足够快,但不够聪明。 LinkedIn每秒要处理数十万次搜索,每一次都必须在一瞬间返回排序结果。你不可能每次搜职位都去调用一个千亿参数的大模型来帮你挑——那相当于每次开门都叫一辆装甲车。
于是他们做了一个6亿参数的学生模型来扛线上流量。但新问题来了:怎么能让一个小模型拥有大模型的判断力?
答案来自一个看似违反直觉的操作:给它配两个老师,而不是一个。
一个学生,两个老师——而且教的不是同一门课
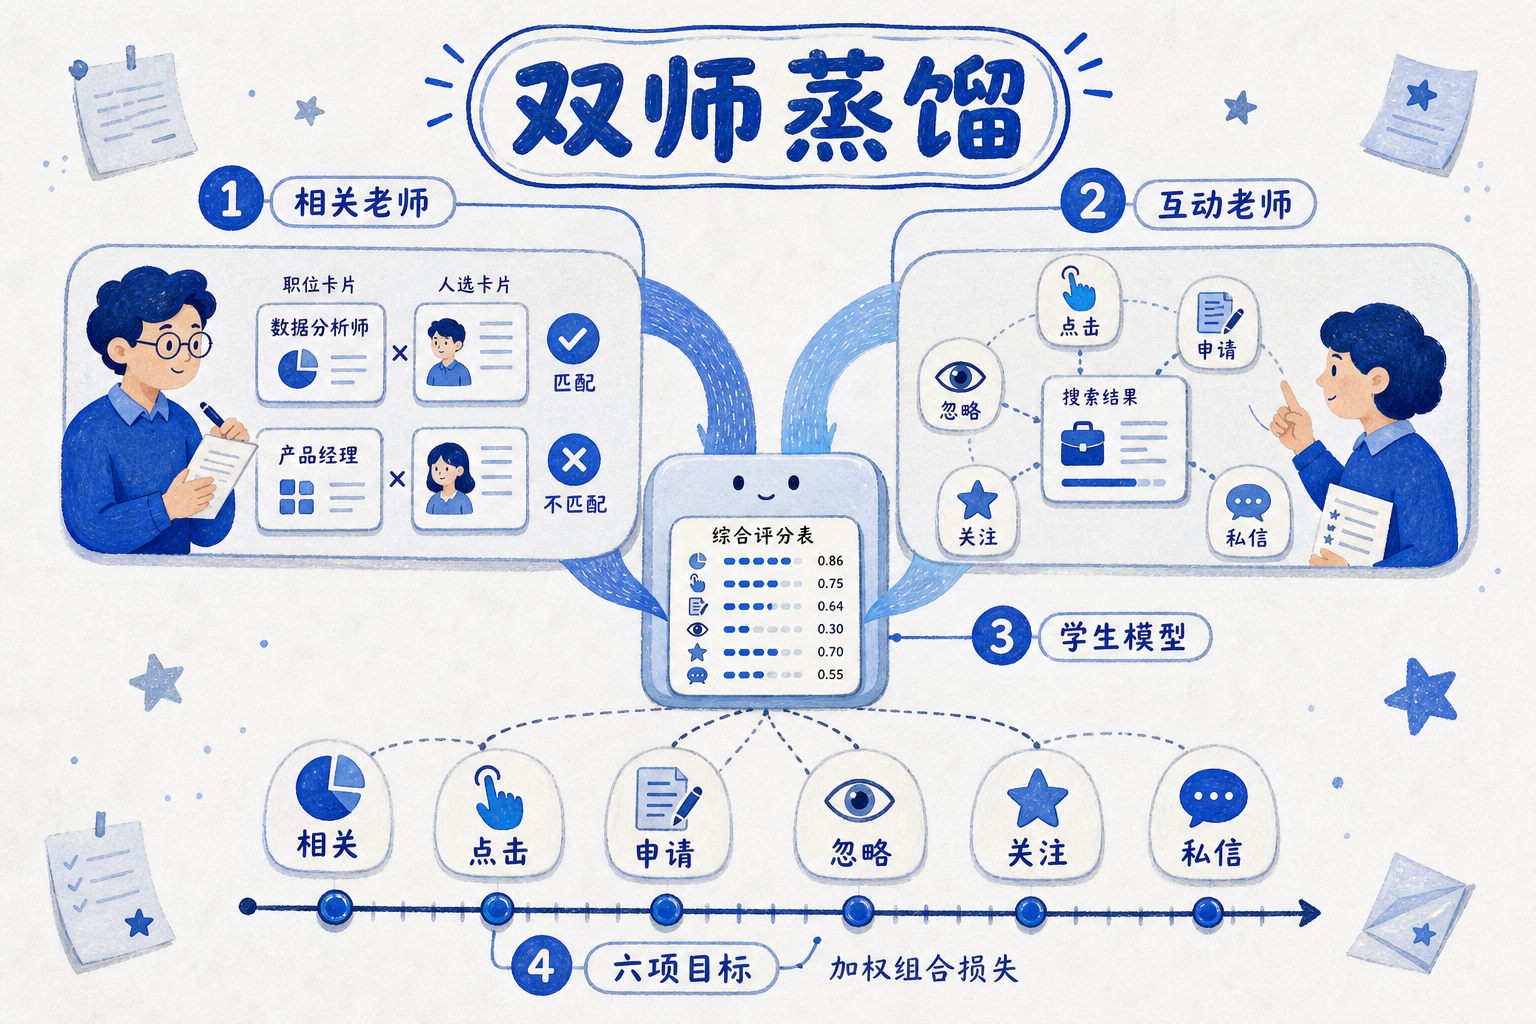
在机器学习里,把大模型的知识灌进小模型,这个技术叫「知识蒸馏」。名字取得很形象——就像把一锅汤煮到浓稠,把水分蒸掉,留下精华。但LinkedIn的做法不一样:他们用了两个老师,各教一门完全不同的课。
第一个老师是「相关性预言模型」,80亿参数。它回答的问题是:这个职位和这个求职者匹不匹配?它会给每对「人-职位」打一个0到4分的相关性评分,还附带理由——「这个人做过三年调查记者,和这个深度报道岗位高度匹配,给4分。」
第二个老师是「互动模型」,17亿参数。它回答的是另一类问题:这个职位推给这个用户,他会不会点?会不会投简历?会不会关注这家公司?它不关心「应不应该匹配」,只关心「用户会不会有反应」。
为什么需要两个老师?
因为相关性好≠用户会行动。一个职位可能非常匹配你的履历,但你刚好不感兴趣——也许薪水太低,也许公司文化不合。反过来,一个职位可能相关性评分不高,但因为标题吸睛、公司知名度高,用户照样会点。两类判断需要两类不同的专业眼光,一个老师教不了。
于是这个6亿参数的学生模型同时接收两路信号:一边模仿相关性老师的评分习惯,一边模仿互动老师的行为判断,用加权后的相似度损失来让学生尽可能逼近老师的判断——衡量的是学生输出的评分分布和老师的评分分布差多远。总损失函数(模型训练时要最小化的「综合扣分」)是六个目标的加权和:1个相关性目标 + 5个互动目标(点击、申请、忽略、关注、私信),各目标的权重经过大量实验调出来。
结果很漂亮:NDCG@10(衡量搜索结果排序质量的指标,越接近1越好)从0.7583飙到0.9432,提升了近四分之一。
难题解决了?才刚开始。
先听课、后背书——真正加速的秘密不在模型里
当你每次训练学生模型都要实时去问两个大老师「这个样本你给几分」的时候,会发生什么?训练卡住了。
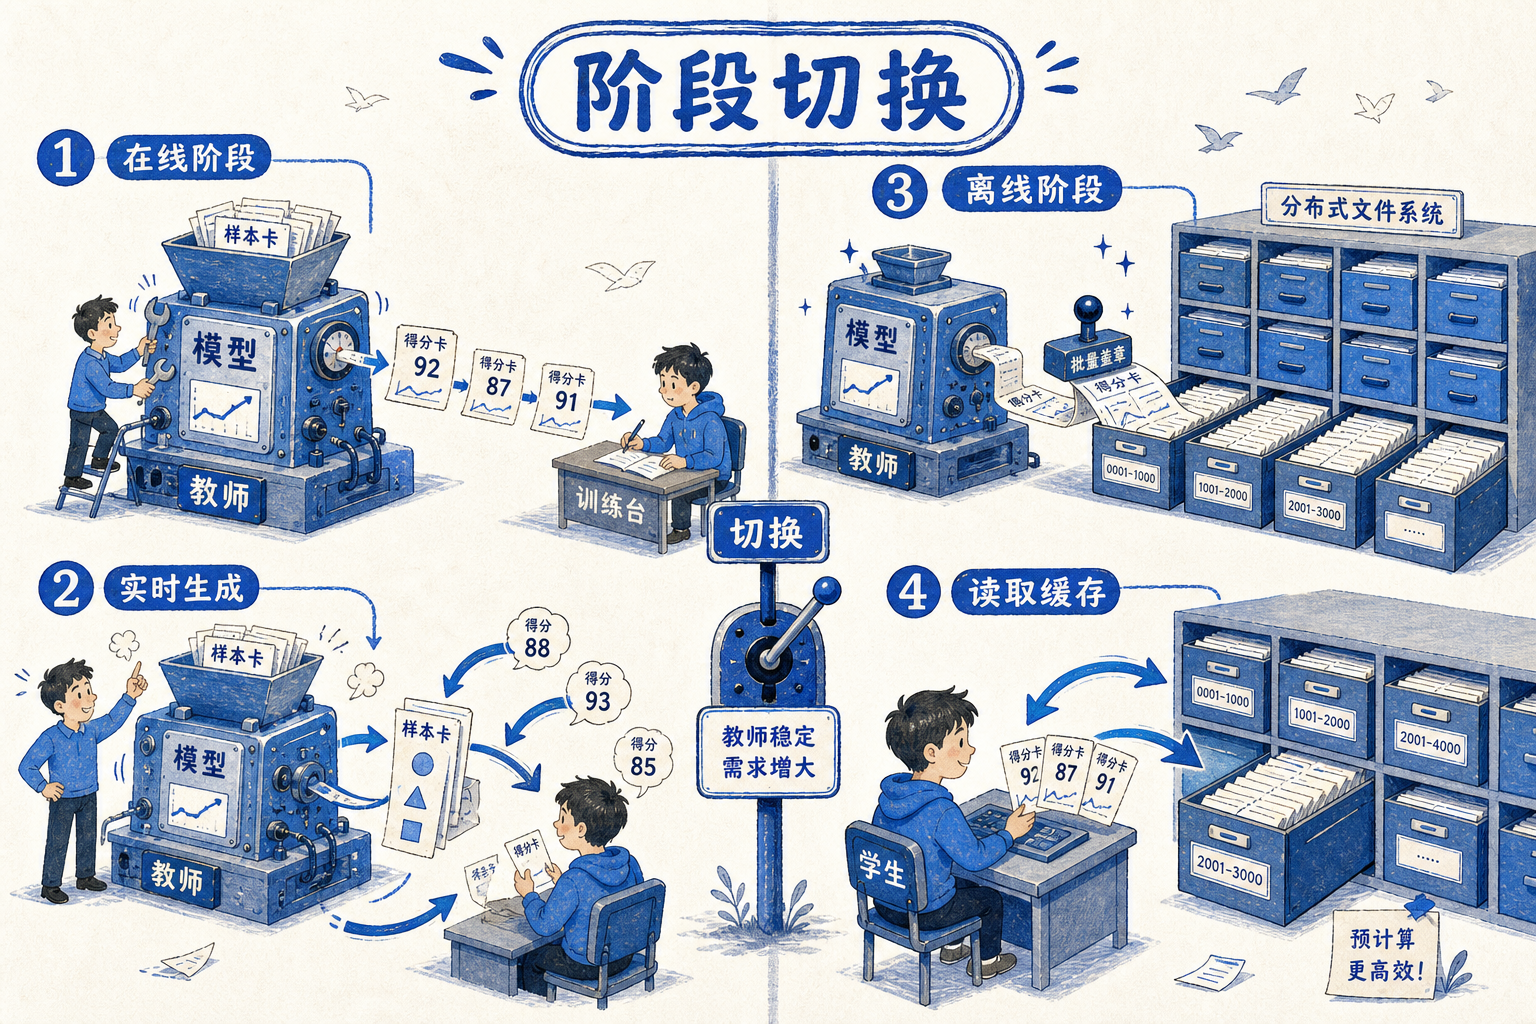
不是比喻——是真的卡住。每一条训练数据都需要向教师模型发起推理请求。两个教师模型都很大(80亿和17亿参数),每次推理都要占GPU、耗时间。对于LinkedIn这种每秒几十万次查询的排序系统,这根本没法推进。工程师们的迭代速度被钉死在「等老师批作业」这个环节上。
LinkedIn的应对方法,拆开来看并不复杂,但执行得很聪明。他们基于开源大模型服务引擎SGLang搭了一套定制框架,允许训练过程中异步向教师模型发请求——不等上一个结果回来,下一个请求已经发出去了。同时,他们在多个节点上分别部署了教师模型的本地副本,把蒸馏速度提升了3倍。
但这还不够快。真正的转折来自一个看似简单的想法的落地:如果老师的答案不会频繁变了,为什么不提前算好存起来?
这就是离线蒸馏。系统预先把教师模型对所有训练样本的输出算好,存到大规模分布式文件系统上。训练时直接读结果,不再实时调用教师模型。在线蒸馏和离线蒸馏不是二选一,而是按阶段切换——当教师模型还在频繁调整时,用在线模式灵活试错;当教师模型趋于稳定、查询量暴增后,切到离线模式,用预计算结果跑训练。
这个模式并不新鲜——你在互联网上每刷一次网页,背后都在跑类似逻辑。
CDN(内容分发网络)最初只能缓存静态图片和样式文件,动态内容(比如你的个性化推荐)必须回源站实时生成。后来工程师们想通了:所谓「动态」不是内容本身不可缓存,而是缓存技术还不够灵活。一些边缘计算方案允许在离用户最近的服务器上跑脚本,把动态生成的结果也缓存起来。同一个模式:先在源头实时生成,输入稳定后切到边缘缓存。
数据库查询计划缓存也一样。数据库收到一条查询,第一次会编译出执行计划并缓存;后续相同的查询文本直接复用,不用重新编译。Chrome浏览器用来跑网页代码的引擎更是把这条路走到了极致——四层编译流水线:先逐行解释执行、顺手收集哪些代码跑得最频繁,只有热点路径才逐步升级到更激进的编译优化,编译结果缓存起来直接复用。
整个逻辑就是:先用廉价、灵活的方式跑着,等看清楚哪里值得花钱,再一次性把最优方案算好存起来。
LinkedIn的在线→离线蒸馏切换,和上面这些案例遵循完全相同的模式。精妙之处不在于发明了新概念,而在于把它搬到了大模型训练循环内部——在训练还在跑的时候,教师服务的热度曲线就决定了什么时候该切缓存。
精度越低越快?FP8在这件事上栽了跟头
蒸馏流水线搭好了,但8倍加速并不全靠它。LinkedIn的工程师做了一件在大模型训练圈子里几乎成为肌肉记忆的事:调精度。
GPU训练模型时,数字的存储精度直接影响速度和内存。传统用32位精度,后来大家发现用16位精度训练几乎不损失质量、速度却翻倍,于是16位成了标配。再后来,行业开始推8位精度(FP8)——理论上内存再减半、速度再翻倍。
LinkedIn团队满怀期待地测了FP8,然后把它关掉了。
FP8在参数量低于80亿的模型上不仅不加速,反而更慢。 原因藏在工程细节里:把数字从16位转成8位再转回来,这个转换本身就要消耗CPU时间。模型太小的时候,真正的矩阵乘法算得飞快,类型转换的开销反而成了瓶颈——就好像你点了一份快餐,结果打包和拆包装的时间比做饭还长。而且小批量时GPU的计算单元根本喂不饱,每次启动计算任务的调度开销压过了一切。
这个结论有独立佐证。一支团队在专门分析小模型训练瓶颈时发现,小模型的瓶颈不在算力,而在通信和计算任务启动——FP8省下来的那点计算量根本打不到痛点上。另一支独立研究团队也观察到了同样现象:FP8引入的额外量化和反量化操作,让它在小批量场景下跑不过16位精度。
那么8倍加速到底怎么来的?是四项优化的叠加,没有哪一项独挑大梁:
LiGer内核——LinkedIn开源的一组GPU计算内核,通过把多个计算步骤合并成一步、把数据切成小块分批次处理,将GPU内存占用砍掉60%,每次训练处理的数据量直接翻倍。多节点数据并行——把训练拆到多台机器上同时跑,最高再快3.5倍。FSDP2——PyTorch第二代完全分片方案,通过更聪明地把模型切碎分散到多块GPU上、提前把下一步要用的数据搬到计算单元旁边,再挤出20%。最后换上H200 GPU集群——H200的内存带宽比上一代H100高了约40%,小模型训练最怕的内存搬运卡顿得到缓解,再提30%。
这几项不是加起来,而是乘起来——每一层优化都在上一层的基础上生效,最终叠出约8倍的总加速。没有魔法,只有耐心地把每一个环节都拧紧一圈。
当你搜「记者」,系统不会再给你法庭书记员的职位
这套系统已经在美国市场全面上线。那它对一个普通求职者意味着什么?
最直接的变化是搜索终于能理解自然语言了。旧关键词系统搜「reporter」会同时匹配出镜记者和法庭记录员,因为两者在英文里是同一个词。新系统读的是语义——它知道你说的是「从事新闻报道工作」,不是「做庭审记录」。LinkedIn的产品副总裁Erran Berger说得很直白:「这个新的搜索体验让用户可以用自己的话描述目标,得到真正反映他们在寻找什么的搜索结果。」
数字上也撑得住:线上部署后,职位搜索的NDCG再涨了7.73%,日活用户增加了1.2%。对求职者来说,这意味着更少的时间在翻不相关的列表上打转;对LinkedIn来说,日活涨1.2%在它十亿用户的基本盘上是一笔可观的增量。
但这套方案也有它不说但你应该知道的事。
首先,一个6亿参数的学生模型不可能完美复现两个大老师的全部判断力。这不是工程问题,而是信息论上的硬约束——学生和老师之间的容量差距客观存在。研究早已表明,老师越大不一定教得越好:当学生容量远小于老师时,学生根本模仿不了老师的完整判断分布,在某些边界场景上会出错。LinkedIn通过联合优化多个目标来对冲这个风险,但长尾搜索、冷门职位的匹配质量仍然是一个开放问题。
其次,优化点击和申请这些互动指标,本身有微妙的偏向——系统可能倾向于推那些「看起来诱人」但未必最适合你的职位。LinkedIn在论文里明确意识到了这一点,所以用相关性教师的评分来平衡互动教师的「吸睛」倾向。但这个平衡是调参调出来的,不是理论保证的。
放眼行业,Pinterest在2026年6月发表了类似路线:用多节点训练把大教师模型训出来,再蒸馏到小模型里做首页推荐排序,把实验周期显著缩短。更前沿的方向上,业界已经在用十个以上的专业教师模型,对学生的每一次预测做逐词逐句的精细监督——LinkedIn的两个教师方案在工业排序场景里够用,但教师模型池的规模和精密程度还在快速进化。
归根到底,这件事的启示不在某个单一技术上。大模型负责理解世界,小模型负责服务世界——而中间那条把知识从前者灌进后者的流水线,才是真正决定谁能跑赢的护城河。**蒸馏不是一道算法题,是一道工程题。 **