一个300个氨基酸的蛋白质,换掉任意一个位置的组合数就超过10³⁸⁰种——比宇宙中的原子还多。传统的蛋白质定向进化就在这片汪洋里撒网——随机突变、反复筛选,几万次实验后也许摸到一个好用的。
2026年9月,河南农业大学和莫纳什大学联合团队给出了一条截然不同的路。一个叫unZipro的AI——可以理解为"零样本蛋白质进化导航器"——从未见过目标蛋白的实验数据,只需提名约10个候选突变,就能以平均61%的成功率找到让蛋白变强的那个。在基因编辑工具上,它找到的一个突变让编辑效率飙升27.9倍。
好比搬到一个新城市,GPS只看了一眼地图,就告诉你哪条路好走——你甚至不用亲自开车绕一圈。
定向进化的老路子:为什么"筛"字是最贵的那个字?
在unZipro之前,想让一个蛋白变强——编辑更准、催化更快、抗病更稳——大致只有两条路。
一条是"理性设计":你得把这个蛋白的工作原理摸透,然后像修表匠一样凭经验去换零件。问题是蛋白不是表。一个氨基酸换了,它邻居的邻居可能就悄悄变了姿势,整个催化口袋的电场也可能翻天。理性设计在简单蛋白上能碰对,但对大多数蛋白——尤其像Cas9这种超过1300个氨基酸的大块头——你猜不准。
另一条是"定向进化":在实验室里模仿自然选择——随机引入大量突变,建一个覆盖成千上万个变体的库,然后像筛米一样筛出跑得更快的几粒。2018年,定向进化的发明者弗朗西斯·阿诺德拿了诺贝尔化学奖,理由很直白:这种方法已经改造了从洗衣粉酶到抗癌药的数百种蛋白。
但"筛"字是定向进化最贵的那个字。一轮就要造几千个变体,挨个表达、纯化、测活。对微生物蛋白——大肠杆菌里一天能长好几代——还好说。对植物蛋白?一株水稻从转化到收获要小半年,你不可能种十万株、一株一株筛。所以植物蛋白的定向进化,长期卡在"理论上能做、实际上做不动"。
unZipro要答的就是这道题:能不能把"筛几千个"降到"筛十个左右",还不牺牲成功率?
AI导航器怎么做到的:不看答案就能猜对题?
unZipro的核心思路是:不直接预测"哪个突变让蛋白变强",而是先学一个更基本的问题——给定三维骨架,什么样的氨基酸序列最应该出现在上面?
这叫逆折叠。正问题是:给定氨基酸序列,预测它怎么折叠成三维结构——AlphaFold干的就是这个。逆问题反过来:给定三维结构,反推最合理的氨基酸序列。unZipro用24,501个已知蛋白质结构训练了一个图神经网络——把氨基酸想象成社交网络里的节点,空间上挨得近的就拉一条边。网络学的就是:在这样一个三维邻居关系里,每个位置最"自然"的氨基酸是谁。
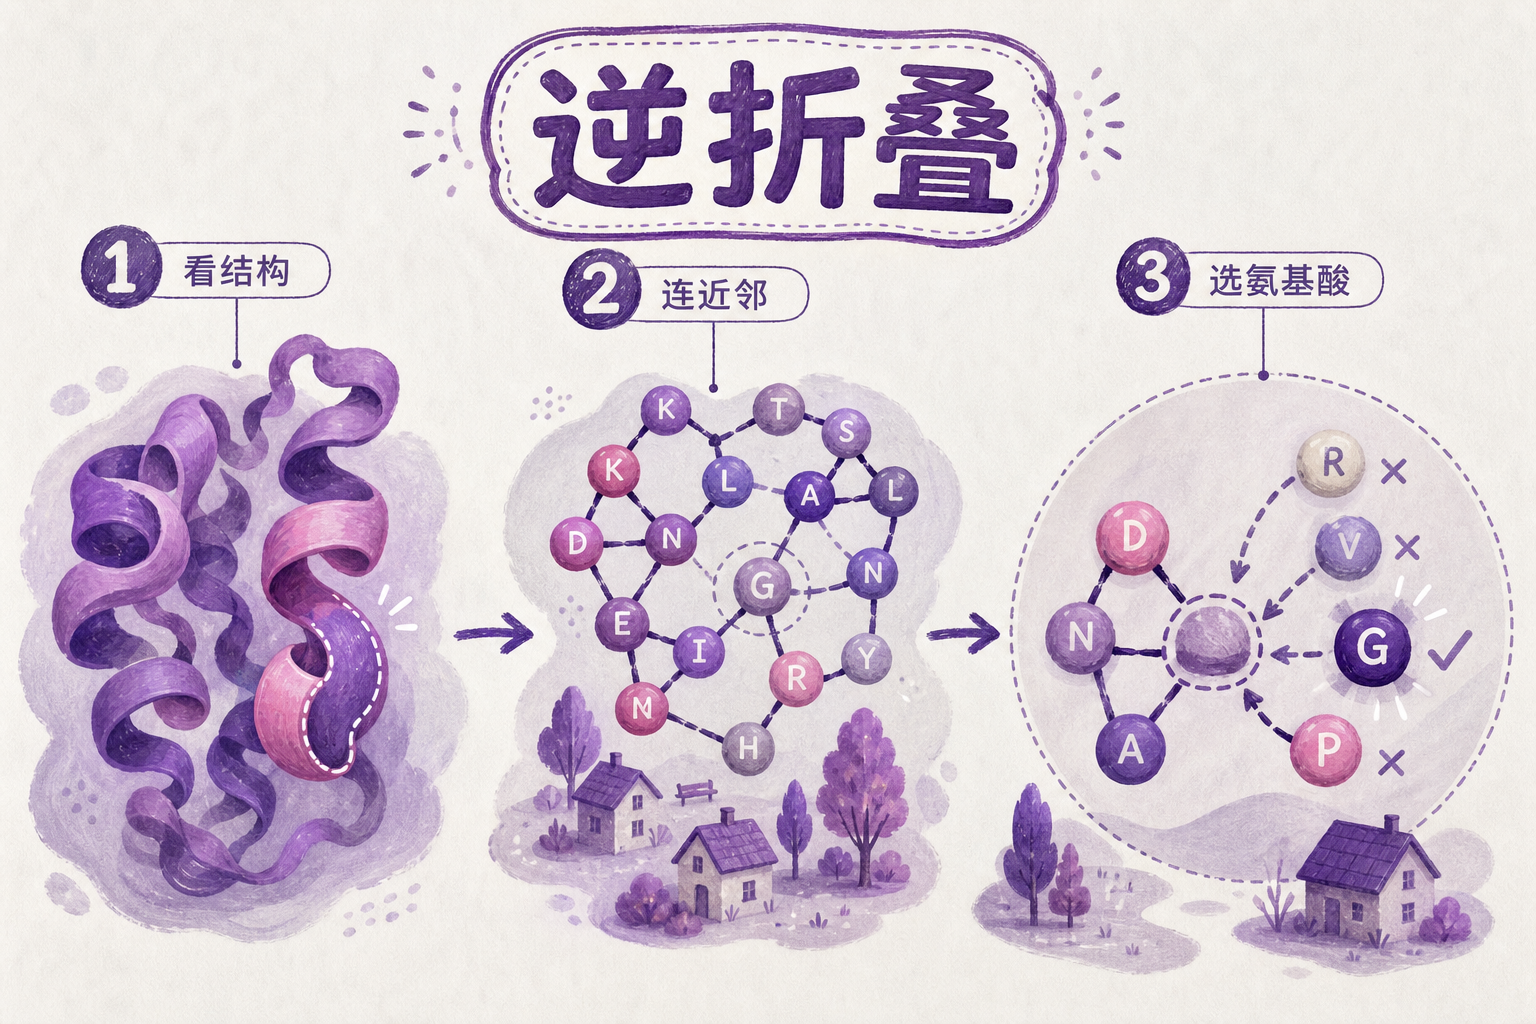
训练完之后,网络能把天然蛋白的氨基酸序列猜对47.5%。数字不高,但蛋白序列本来就不唯一——很多位置换成别的氨基酸也能正常折叠。关键的比较是:它比同类方法高出一截,用的训练数据还更少。
但光有通用导航图还不够。不同蛋白家族有各自的"本地交通规则"——同一个三维骨架,在细菌里和在人里,最优的氨基酸选择可能截然不同。unZipro的第二步叫元学习——可以理解为"让AI学会怎么快速适应一个新领域":先让模型在100种不同蛋白家族上学会"面对陌生家族时怎么调整自己",然后面对目标蛋白时,只需搜一下它有哪些结构相近的"亲戚",就能把通用导航图微调成家族专属版。
最后一步才轮到突变预测:把目标蛋白的三维结构喂给微调后的模型,它会输出每个位置20种氨基酸各自的"出现概率"。如果某个突变让概率明显上升——说明"自然界觉得这个氨基酸更该出现在这里"——那它大概率就是有益的。unZipro只需把概率最高的那10个左右候选挑出来,交给实验去验证。
在ProteinGym——含217组实验、186种蛋白、约246万个突变的标准测试集上——unZipro的预测相关性比微调前提升了12.4%。在零样本设定下,这意味着没摸过目标蛋白数据时,预测就有了实打实的跃升。更值得注意的是,在识别最稀有的极端有益突变上,抑癌蛋白p53提升了50%,冠状病毒Spike蛋白提升了46%。
但数值提升只是纸上成绩。真正的考验是:放到真实实验里,这套导航到底靠不靠谱?
从基因剪刀到水稻:实战成绩单
研究团队选了九种蛋白来"验货",覆盖病毒、细菌、动物和植物。每一道都在问同一个问题:AI提名的十几个候选里,有几个真的变强了?
在基因编辑工具上,答案相当漂亮。对腺嘌呤碱基编辑器中的关键脱氨酶TadA8e——负责改写DNA上的特定碱基——unZipro从6个候选里命中4个(成功率66.6%),T83N变体在小麦里的编辑效率提升1.5到2.7倍,全基因组脱靶(切错地方的频率)也显著下降。分子动力学模拟——用计算机逐帧追踪原子运动——揭示:T83N在催化中心多形成了一个氢键,像多安了一颗螺丝,让蛋白抓住DNA的手更稳了。
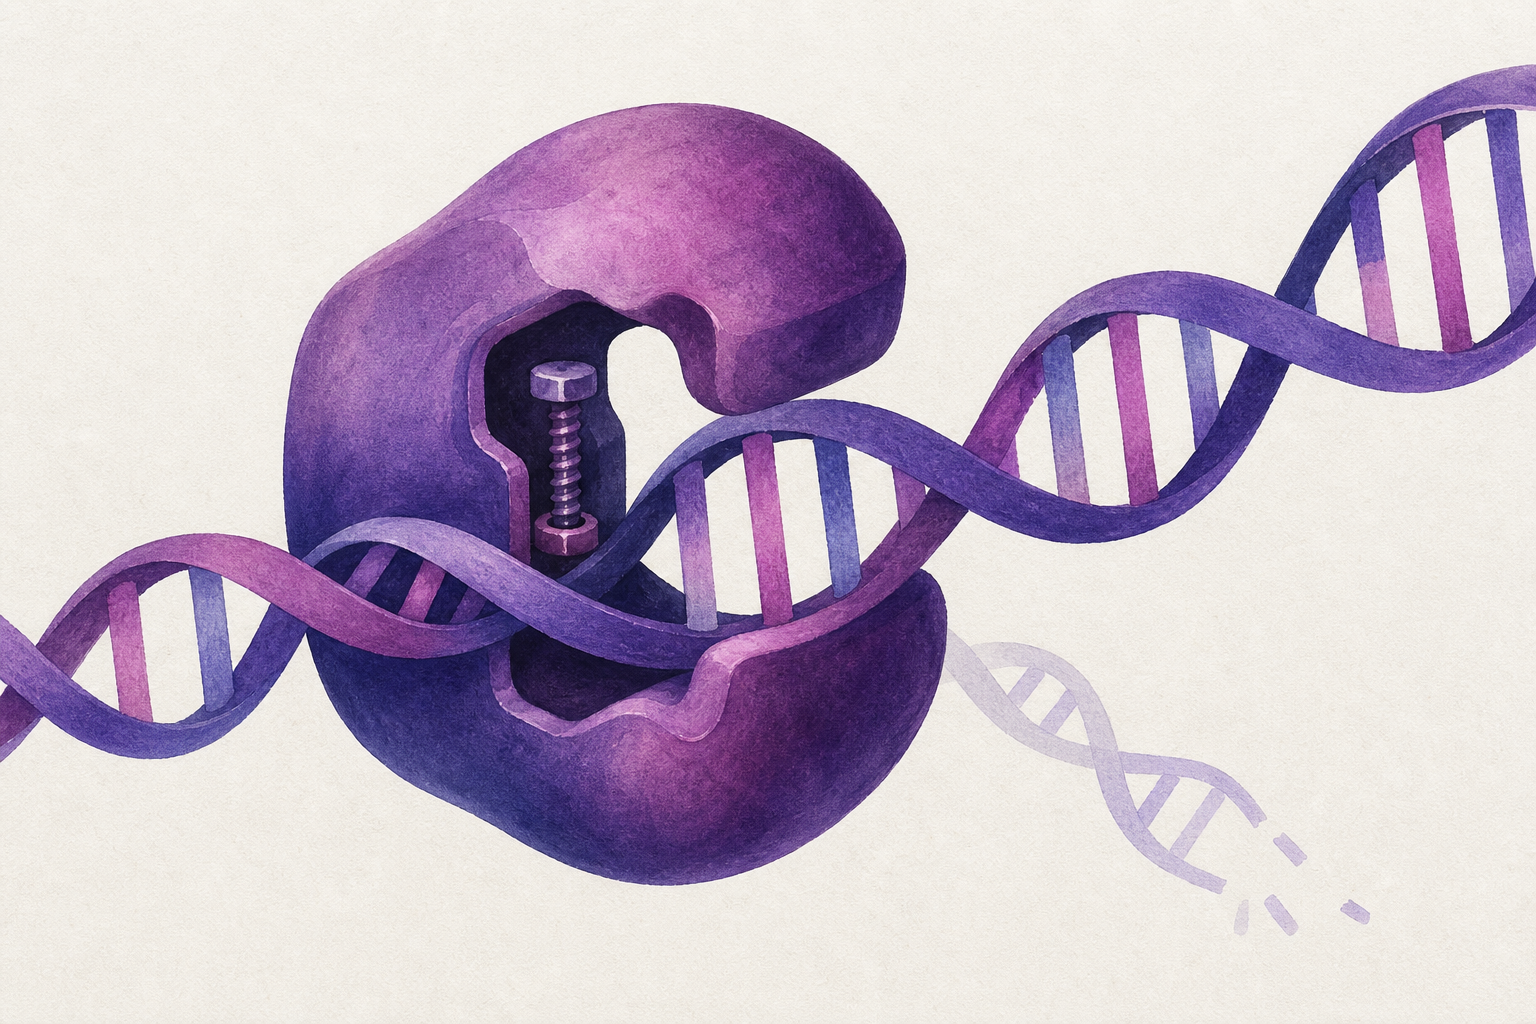
对Cas9,D1180G突变让小麦编辑效率最高提升12.8倍。对更小巧的DNA剪刀CasΦ2,团队同时优化了它和配合它的T5外切酶(从DNA末端开始剪的酶),组合后编辑效率最高提升27.9倍,T0转基因小麦编辑率从10.3%跳到40.0%。
引导编辑器的改造更有意思:它含有一个逆转录酶——能把RNA信息抄回DNA——在不同阶段切换不同三维形状。团队用两种形状的结构分别跑unZipro,交叉匹配候选后找到双突变R253K/T246H,在多个小麦位点超过此前最强版本,T0编辑率达90%。
到这里,规律浮现了:四个案例的有益突变全落在蛋白最关键的功能界面上——催化中心、PAM识别域(Cas9抓住DNA的"门把手")、核酸结合界面。AI导航最擅长的,不像在指"路边哪家店好吃",更像在标"市中心哪个路口最容易堵"。
但基因编辑工具是"明星蛋白",已有大量进化信息和结构数据。团队更想知道的——也是更难的——是:对那些没被充分研究过的植物功能蛋白,这套导航还管用吗?
答案是管用,但成功率有明显波动。萤火虫荧光素酶仅7个候选就捞出4个增强变体,最佳突变M164I活性是野生型的4.1倍。水稻转录因子(控制基因开关的蛋白)OsPHR2和OsNAC3用AlphaFold预测结构——没有实验解析的结构——成功率分别是50%和70%,转录激活能力提升3.6到4.7倍。大麦甲硫氨酸合酶HvMS1——参与合成含硫氨基酸,也与抗病毒防御有关——从11个候选筛出5个抗病毒增强变体,对RNA和DNA病毒都有效,且增强来自活性提升而非表达量增加。
九类蛋白,每类验证约10个候选,平均成功率61%,最高100%。这个数字的意义不在于"AI全对了",而在于它把定向进化的实验门槛从"筛几千个"拉到了"筛十几个"——对植物蛋白来说,这可能是从"做不了"到"做得起"的距离。
导航的短板:当突变必须打组合拳
到这里,你可能觉得unZipro已经把定向进化从一个"体力活"变成了一个"脑力活"。但读完论文就会发现,作者的诚实远大于乐观。
讨论部分最坦率的一句局限是:unZipro"目前依赖静态结构表征,未显式考虑蛋白在不同形状间来回扭动的过程(构象动力学)和高阶上位效应"。"上位效应"是蛋白质工程里最头疼的词——两个各自有益的单突变放在一起,效果不是1+1,可能是0.5,可能是-2,也可能什么都没发生。有分析指出,约三到五成突变对存在显著上位效应;如果把8个各自有益的单突变组合起来,所有对兼容的概率仅有约3%。
这正是unZipro在引导编辑器改造中绕道走的原因:它无法端到端预测双突变协同,只能分形状预测单点突变,再人工结合进化约束推测组合效应。当前导航在"单岔路口"指得很准,遇到"多岔立交桥",还得人类司机自己判断匝道。
更大的背景是,AI蛋白质设计领域正经历一场关于零样本预测可靠性的辩论。有系统性评估显示:零样本方法在新功能任务上系统性失败——中位数相关性仅0.3到0.5,大致相当于猜对方向的概率只比抛硬币好一点点。另一项分析更尖锐:当按位点分层划分训练和测试集时,几乎所有蛋白质语言模型——用训练大语言模型类似方法在海量蛋白序列上练出来的AI——都崩盘了,一个仅记"位点平均效应"的朴素模型反而赢了。
这跟药物发现过去十年走过的路几乎一模一样——虚拟筛选把先导化合物发现的成本砍掉了90%以上,靠的正是"计算先筛、实验后验"的逻辑,但它同样在全新靶点和全新化学空间前屡屡失效。这不是AI的失败,而是一道更根本的边界:计算模型擅长在"已知的大陆"上画精确地图,但"发现新大陆"是另一个量级的挑战。
unZipro的意义或许不是"取代了定向进化",而是为它挂上了一个导航仪——让前者在无需大规模筛选的地方少走弯路,同时在真正需要组合创新的地方,把有限的实验资源集中到AI算不准的那几个路口上。
对农业育种研究者来说,unZipro给的不是万能答案,而是一张可承受的入场券。以前优化一个水稻转录因子需要建上千个转基因株系——转化和筛选就耗掉一个博士生整个学程。 现在实验台上只需验证6到11个候选,剩下的交给AI在服务器跑几个小时。当定向进化的成本从"核心竞争力"降为一段可复用的计算脚本,受益最大的不是手握高通量平台的大团队,而是只有培养箱和移液枪的普通实验室。
过去,蛋白质进化靠的是"大量制造、严酷筛选"——像在沙漠里淘金。现在,AI先画了一张矿脉分布图。地图不等于金子,但它告诉了你该往哪挖。