你对机器人说:"把杯子在两个盘子之间来回三次。"第一次,完美。第二次,手臂挡住了它的视线。第三次,它停住了——它不记得自己做了几次,杯子在哪,下一步该继续还是重来。
这不是虚构。斯坦福大学最新的实验里,一台没有专门记忆模块的机器人面对这类多步任务,58次尝试只成功了5次。而同一台机械臂装上一个叫ECoMEM(显式概念记忆)的记忆系统后,79次尝试成功了68次——从8.6%到86.1%。
这里藏着一个反直觉的事实:机器人不是"看得不够多",而是看得越多,忘得越乱。它面前的每一帧画面都存着,但没有一帧告诉它"这是第二趟"。
为什么"看过"不等于"记得"
机器人控制里,"记忆"至少包含四种完全不同的需求。
一是计数:同一个动作重复了几次。画面完全相同的第三次按钮和第一次按钮,需要机器人做出不同的反应——前者继续,后者停止。二是遮挡后的持续跟踪:杯子消失再出现,还是不是同一个杯子?三是回指过去的交互:刚才被放到了哪、哪一次操作成功了?四是模仿演示:看过一段动作序列后,按同样逻辑再做一遍。
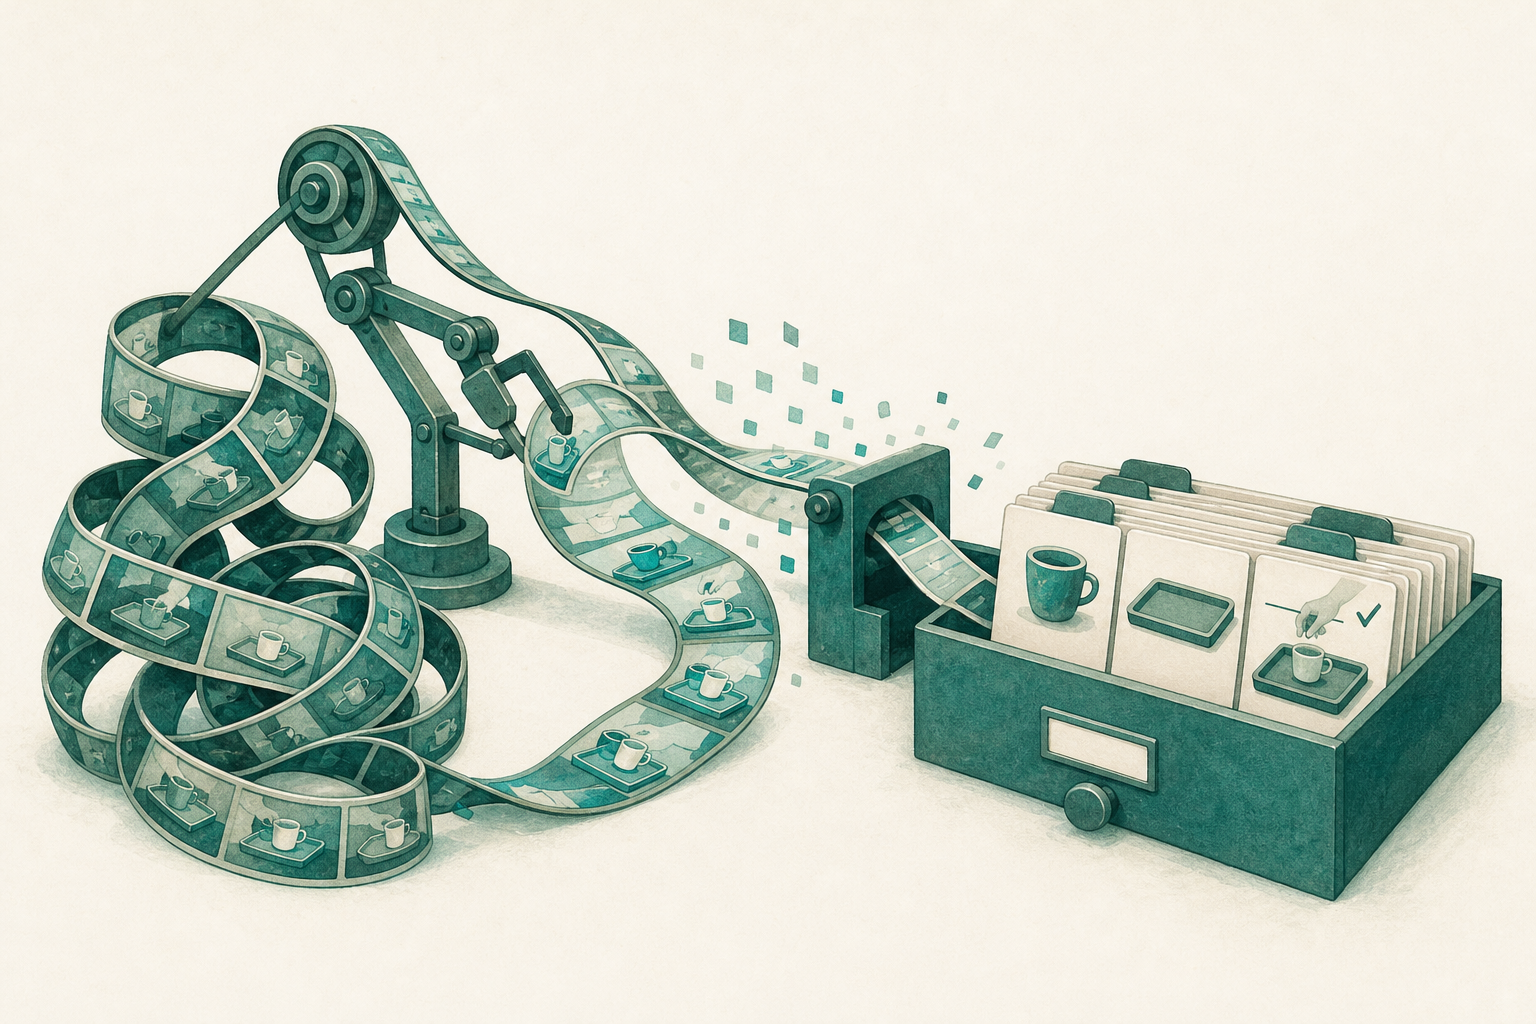
传统做法直截了当:把所有历史帧一股脑塞进机器人的控制模型。这个模型用画面和语言指令直接输出机械臂动作。看起来合理——历史越长,信息越多,决策越准。对吧?
完全不对。
语言模型有个著名弱点叫"中间失忆症"——读超长文本时,开头和结尾的信息记得住,中间段落像掉进黑洞。放到机器人领域更糟:后来的实验发现,一个靠历史帧做决策的策略,在真实运行中状态预测准确率从86%暴跌到18%,成功率从56%跌到19%。更荒诞的是:全塞历史帧的策略在真实任务上只有12.8%,还不如只看当前一帧的14.4%——历史非但没帮上忙,还拖着模型一起下沉。
为什么?因为历史帧是原始数据,不是整理过的事实。模型要同时做两件毫不相干的事:从一团像素里猜"发生过什么",再根据猜出来的东西决定"下一步怎么动"。这两件事搅在一起的结果,就是模型在计数时漏掉一次重复、在物体被遮挡后认不出它回来、在第三次循环时把目标数量搞混。
人类不会犯这种错。你不需要把过去一分钟的视频回放才知道自己往返了几次——大脑自动把经历压缩成了几条事实:"已经两次""杯子在右边""刚才那次不算,没抓住。"斯坦福ECoMEM想要复制的,正是这个中间层。
一个写事实,一个用事实
ECoMEM的核心设计,是把"记住什么"和"怎么用记忆"拆成两个独立角色。
第一个角色叫Writer——记忆记录员。它不存画面,存事实。每一条事实是一张便签,上面写着几样东西:哪个物体、它和谁有空间关系(在右盘里)、刚发生了什么事件(完成一次往返)、当前进度是多少(2/3)。Writer从相机画面和机械臂自身状态中抽取这些信息,新证据与旧记录一致就合并,出现矛盾就用更新的证据覆盖。
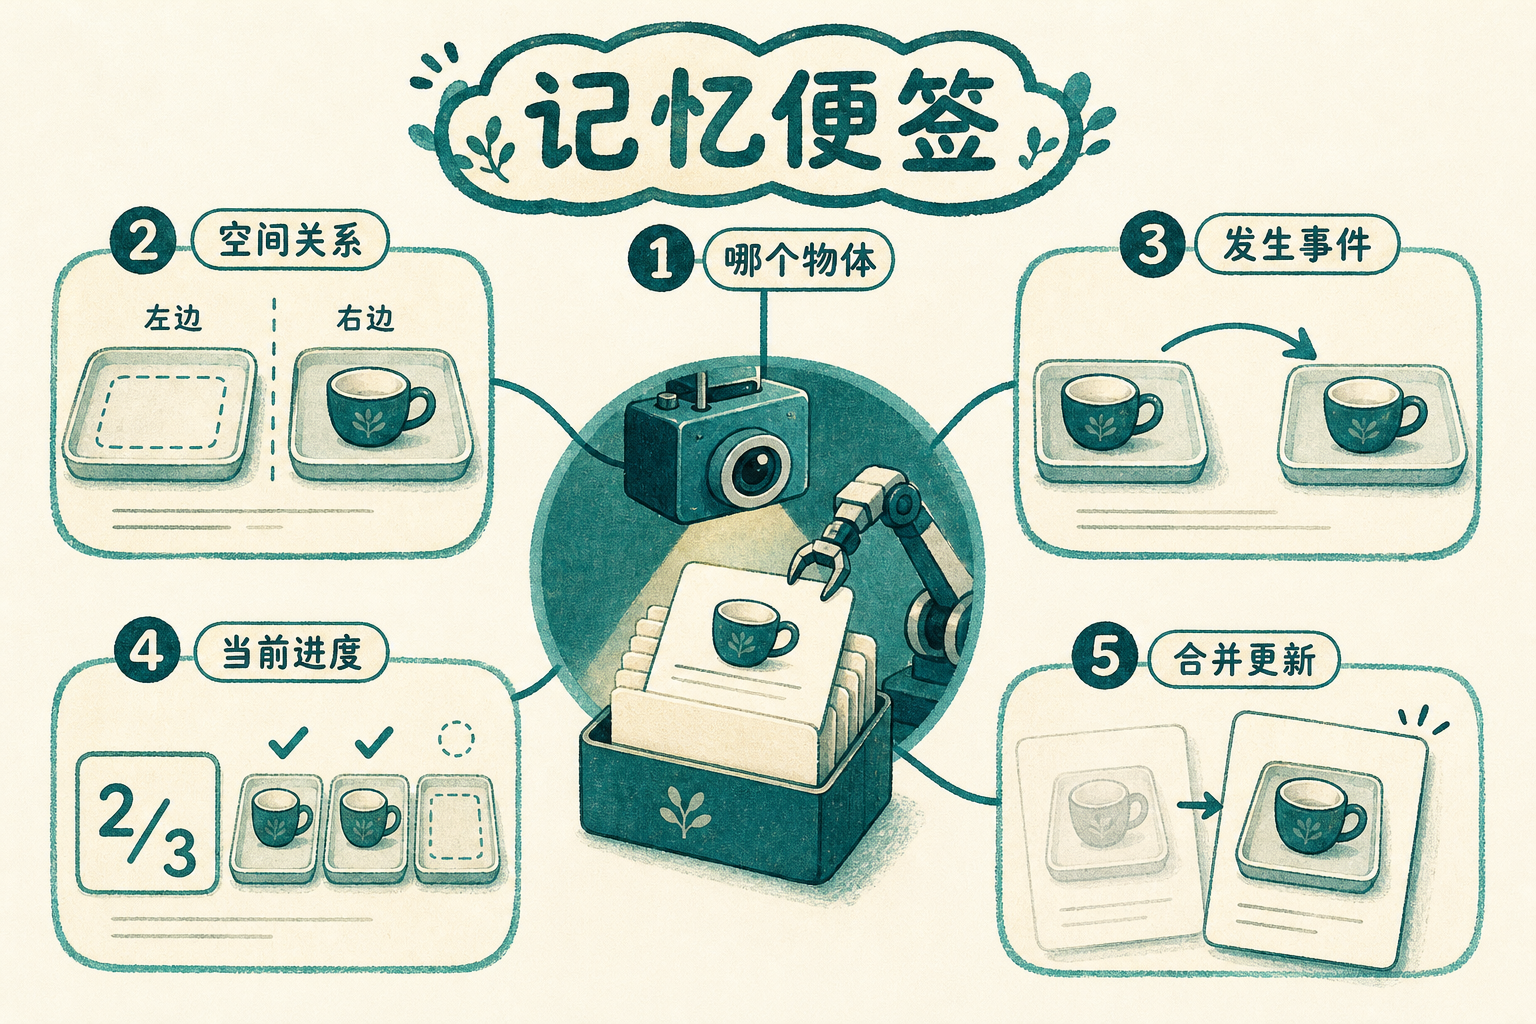
第二个角色叫Reader——记忆读取器。它不判定事实,只负责把Writer写好的便签翻译成控制策略能用的信号。Reader从记忆库里挑出和当前任务相关的那几张便签——往返任务需要计数器,遮挡任务需要最后位置,模仿任务需要事件顺序——把它们编码后,和当前画面、任务指令一起送入动作模型,由后者决定机械臂下一步怎么动。
这个分工带来一个巨大的工程好处:机器人犯错时,你可以追查到底是哪一层出了问题。是视觉识别没看清?是Writer把事件记错了?还是Reader读对了记忆但动作模型没执行好?传统方案把所有信息压进一个不可拆分的数字串——错了就错了,你甚至不知道从哪查起。
论文把概念分成四类。实体与空间回答"谁在哪";状态与属性回答"它正抓着什么、容器里有没有东西";事件与进度回答"已完成几次、还差几次";时间与关系回答"这些事件的先后顺序"。每一类破除一种歧义,四类合在一起才够支撑多步决策。
这里有一条不能省的因果链:视觉画面提供物体位置和动作线索,机械臂状态提供夹爪是否闭合、力度是否足够等补充证据,Writer把两类证据合在一起才判定一次往返是否真正完成——不是"看起来像完成了"就算。所以空抓不会误加计数,物体被手臂挡住时也不会报"丢了"。
用数据库来类比会很直观:Writer就像数据库里的写入操作,把原始感官数据变成结构化记录;Reader就像查询操作,按任务条件取出相关行;概念库是表结构,定义了每条记录有哪些字段。这不是一卷录像带,而是一个小型数据库——可查询、可检查、可逐条修改。
但这恰恰可以追溯到1970年。当时程序员存取数据要靠"知道文件在磁盘上的物理排列顺序"——和机器人把历史帧当记忆一样,应用逻辑与存储方式死死绑定。计算机科学家埃德加·科德在那年提出关系模型,用表和查询把数据与程序解耦,催生了我们今天用的数据库查询语言和整个产业。ECoMEM对机器人记忆做的事,和科德对数据管理做的事,遵循了同一条逻辑:把"信息是什么"和"信息怎么用"分开。
一条数字最能说明这种设计的分量。论文做了对照实验:把空间概念拿掉,成功率从84%跌到18%;把进度概念拿掉,从62%跌到14%;把时间概念拿掉,从60%跌到12%。如果把所有概念不加筛选全塞进去,某项任务的成功率反而从84%掉到42%,初始化还慢了十几倍。记忆越多不一定越聪明——关键是记得对、取得上。
谁在等一台真正"记得住"的机器人
如果你觉得"往返三次杯子"是个玩具任务,想一想这些场景。
仓储机器人需要记住哪些货架已经清点、哪批订单已完成,而不是每次经过同一排货架都当成第一次。实验室机器人需要记住样本A已经被移到了离心机3号位、步骤2已完成,而不是对着同一排试管重新开始。家庭机器人需要记住你十分钟前说"把蓝色杯子放回左边",而不是二十分钟后又把杯子拿回来。
这三种场景的记忆需求并不一样。仓储目前靠外部管理系统承担了大部分记忆,机器人基本是短程执行。实验室早已把"样本ID加全流程状态加审计追踪"做成合规标配——任何一步操作都能被审计,这正是监管机构批准自动化实验室的前提。家庭是最野生的场景:物体被人随手移动、指令临时改变、任务被意外打断。
目前最接近商用家庭机器人的人形机器人Figure 03,在2025年发布的"记忆"功能更像一个隐式的数字串——把高层意图压缩成一团不可拆分的数字,你看不到它到底"认为"杯子在哪、做到第几步。ECoMEM走的是另一条路:每一条记忆都带证据来源、更新时间、是否被确认,空铲不会误算成一次有效倾倒。形态上,它已经接近工业审计记录。
但"可检查"不等于"不会错"。恰恰相反——显式记忆把所有的风险都搬到了明处。
最危险的,是它"以为自己记住了"
ECoMEM最深的悖论在这里:Writer一旦写错一条记录,Reader和动作模型全部基于错误前提运转,整条动作链跑偏——而且跑得又快又确信。
论文自己做了测试:用一个通用视觉语言模型直接从视频里抽取概念,局部状态准确率96%到100%,但一到需要理解事件先后顺序的时间推理,准确率直接跌到5.9%到11.8%。Writer用的是专门设计的一整套抽取流程,才把时序准确率拉到88%到100%。但如果你换一个机械臂平台、换一批陌生物体、换一个更杂乱的背景,Writer还能不能维持这个准确率?论文没测。
还有几个更实际的缺口。记忆新鲜度——现实中的物体会被人移动,昨天看到的状态今天已经过时。如果记忆只增不减,旧事实会从帮助变成干扰。失败后的恢复——如果两条记录互相矛盾(视觉说杯子在右边,历史说最后一次转移失败),机器人应该停下重看、询问人类,还是选风险更低的动作?ECoMEM提供了"可以检查的对象",但恢复策略本身还没设计。跨平台迁移——同一个"杯子""容器""完成一次转移"的概念,能不能从斯坦福那台有七个关节的机械臂搬到另一台完全不同型号的机器人上?目前只在一台机器上验证过。
还有一个更微妙的信号来自模拟基准测试。ECoMEM在16项任务中15项领先,唯独在一项依赖瞬时高亮的任务上输给了靠检索关键帧来记忆的方法——因为高亮标记直接存在画面里,比抽象成概念更快。没有一种记忆方式通吃所有任务。
论文里最有警示意义的是一个叫插销的任务:把棍子插进孔里,需要记忆告诉策略从哪一侧插入、对准哪个端点。ECoMEM这项只拿了40.67%。论文承认,记忆提供了插入侧和端点信息,但手上该往哪个方向多拧两度,仍然需要策略自己一点一点学——显式记忆擅长告诉你"该做什么",不擅长告诉机械臂"力往哪使"。
所以ECoMEM最值得带走的,不是一个叫"概念记忆"的模块名字,而是一条判断标准:当机器人要跨越多个时间点完成任务时,它记住的东西能不能被单独读出来、检查出来、修正过来。对需要长期运行的仓储、实验室和家庭场景,这个能力比"模型可能在长上下文里自己记住了"要重要得多。
数据库从1970年的论文变成今天每秒钟处理数百万次查询的基础设施,走了五十年。机器人记忆可能也需要这么久——但至少,ECoMEM把问题从"它记住了没有"推进到了"它记住了哪条事实、依据是什么"。记得对不等于做得对——但你现在终于知道它到底记了什么。