想象你站在一座大坝上,盯着水位计。今天水位涨了半米——你自然以为上游下了暴雨。但如果上游根本没下雨,只是有人把支流上一座隐蔽水库的闸门打开了,让存水涌进了主坝——你的水位计读数一样会涨。
三十多年来,量子物理学家一直在犯类似的"误读"。当他们研究一团量子多体系统——比如一排彼此推搡的微观磁针——的纠缠如何随时间增长时,标准做法是把系统初始化成"零纠缠"态(即所谓直积态,每个自旋各自独立、彼此毫无关联),然后盯着一个叫"半链纠缠熵"的量。它测量的是穿过系统正中央截面的纠缠"水位"。只要读数涨了,默认解释就是:系统在无中生有地制造新纠缠。
中国科学院物理研究所的张春悦、李自翔、张士欣在《物理评论快报》上发表的论文,把这个默认解释推翻了。他们证明:在某些量子系统中,纠缠的增长主要不是靠"造",而是靠"搬"——把藏在系统深处的旧纠缠重新分配到被测截面上来。
纠缠从零开始增长——这个图像漏掉了什么?
先退一步。量子纠缠的意思是:两个粒子一旦纠缠,就不再是两个独立个体——测量其中一个,另一个的状态瞬间确定,无论相隔多远。而"纠缠熵"则是度量一团粒子内部纠缠总量的数字标尺:纠缠越多,熵越大。
以一维自旋链为例——你可以把它想象成一串珠子,每颗珠子可以朝上或朝下,相邻珠子之间有微弱的量子关联。把这条链从正中间切成左右两半,"半链纠缠熵"衡量的就是有多少对纠缠跨过了这个截面。每跨过一对,计数器加一;没跨过的——不管左右两半内部纠缠得多热闹——都不计数。这就像那座大坝的水位计:只测流经闸口的水,不测支流上游水库里存了多少水。
这个工具极其有效。过去几十年的研究用它画出了一幅清晰的动力学地图。在"热化系统"中——好比一杯热水最终凉到室温,量子系统也会趋近平衡——纠缠从零开始线性增长,火箭般直冲上限。而在一种叫"多体局域化"(简称MBL)的奇特系统中,情况截然不同:强无序环境像一堵堵墙,把粒子困在各自的位置,纠缠增长极其缓慢,只按对数曲线爬升——从1到10和从10到100花的时间差不多。
但所有这一切都基于同一个前提:系统从"零纠缠"的直积态出发。可真实世界里的量子系统,很少是从零开始的——它们总有预存的纠缠。一旦系统里已经有纠缠了,半链纠缠熵的读数增长,到底有多少是"新造的"、多少是"旧纠缠被搬运过来的"?
张春悦团队的设计直击要害。他们先让系统在一个热化环境中跑一段时间,积累一定程度的初始纠缠,再切换到MBL环境下继续演化,然后观测"纠缠增量"——即饱和值减去初始值——随初始纠缠的变化。
直觉告诉我们:初始纠缠越多,留给后续增长的空间就越小。水杯半满,能装的新水自然少了。热化系统、自由费米子模型(一种粒子之间互不干扰的简化量子系统)、大部分随机量子线路(每一步随机选取量子门操作的简化模型),确实都遵循这个规律:纠缠增量随初始纠缠单调递减。
MBL不是。
MBL的曲线先升后降。初始纠缠极低时,增量微乎其微——没东西可搬。初始纠缠极高时,增量也小——能搬的空间不够了。但在某个中间值——大约对应半链纠缠熵1.34比特——增量达到峰值。只有"不多不少"的初态,才能激发出最大的纠缠增长。
"造"与"搬":纠缠增长原来有两条完全不同的路
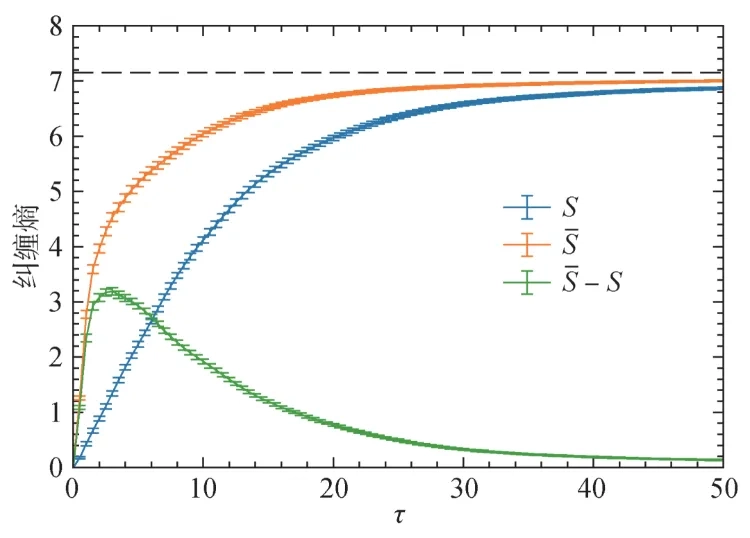
要解开这个谜,团队引入了一把理论手术刀:二分平均纠缠熵(BAEE)。它不再只盯着正中央那一个截面,而是把系统所有可能的等分切法——对一条仅16个自旋的链,不同切法就多达数千种,一个截面漏掉的信息量由此可见——的纠缠熵全部算出来,取平均。
如果半链纠缠熵是"大坝水位计",那BAEE就是"全流域总蓄水量"。这个区分是一切的关键。
团队在一种叫"随机SWAP线路"的特殊操作下验证了这一点。SWAP门只交换相邻自旋的量子态,不产生任何新纠缠——就像把两杯水倒来倒去,总水量不变。在这种纯"搬运"动力学下,BAEE严格守恒:全流域总蓄水量纹丝不动。但你盯着的那个大坝水位却可能起起落落——因为水在内部水库之间重新分配了。
换句话说,半链纠缠熵在纯搬运下的任何变化,都只能来自纠缠的重新分布,不可能来自新纠缠的产生。
团队把MBL的曲线叠加上去——惊人地吻合。MBL的纠缠增量曲线与随机SWAP线路的曲线在定量上几乎重合。这意味着,尽管MBL背后支配系统演化的能量规则(物理学家称之为哈密顿量)极其复杂,它在纠缠增长这件事上的表现,本质上就是一个搬运工:不生产新纠缠,只重新分配旧纠缠。
那些"旧纠缠"藏在哪里?藏在子系统内部——左右两半链各自的"支流水库"里。初态制备时,热化过程在每半链内部快速编织了大量短程纠缠——这些纠缠不跨过中心截面,半链纠缠熵完全看不到它们。但它们就在那里,蓄水量等于BAEE减去半链纠缠熵的差值。团队称之为"隐藏纠缠蓄水池"。
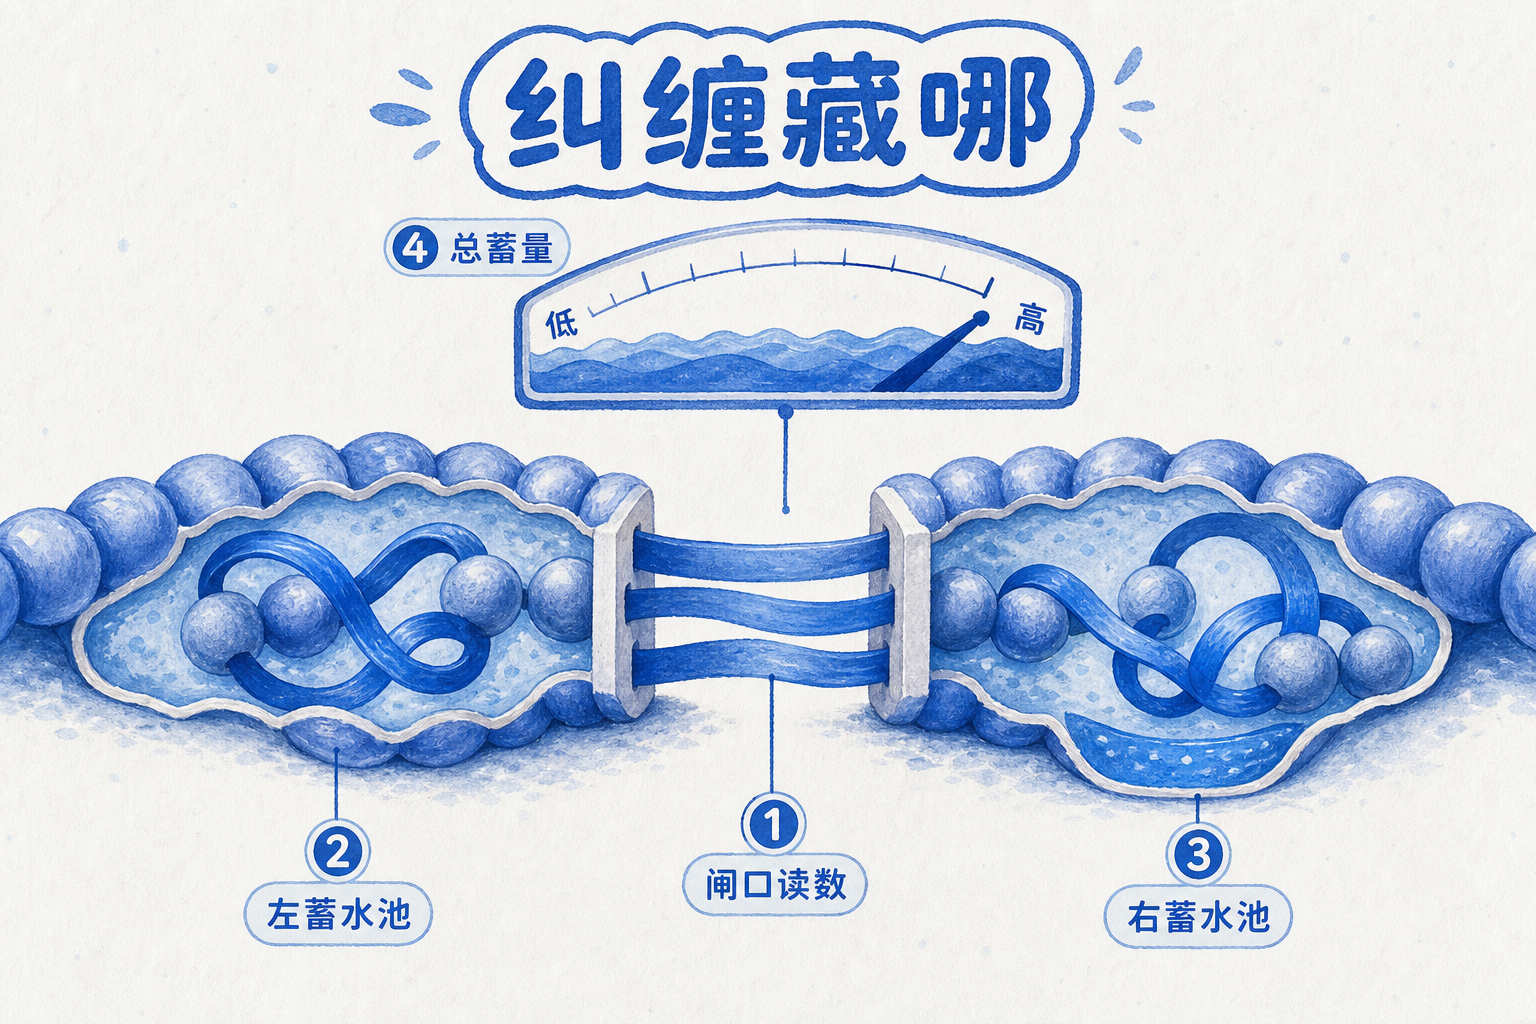
定量的证据严丝合缝:MBL纠缠增量达到峰值时,对应的初始纠缠大小,恰好也是蓄水池最大的时刻。蓄水池越大,MBL这个搬运工能调度的原料就越充裕,大坝水位计的涨幅就越大。
基于此,团队将纷繁复杂的量子动力学统一划分为三大类——这不是对原有理论的修修补补,而是一次重新分类。
第一类,移动主导型:以MBL和纯SWAP线路为代表。主要行为是重新分配现有纠缠,纠缠增量曲线非单调——先升后降。
第二类,构建—移动混合型:以热化系统和自由费米子为代表。既能无中生有造纠缠,也能搬运,纠缠增量单调递减——从零纠缠出发时增量最大。
第三类,纠缠惰性型:以安德森局域化为代表——在这种系统中,粒子被无序环境牢牢钉在各自的位置,连搬运都做不到。既造不了、也搬不动,纠缠增量始终近乎零。
量子芯片上,纠缠的"仓库管理术"刚刚起步
这个框架不只是一张基础物理学的新地图——它直接触及量子计算的实际痛点。
今天的量子处理器——所谓"含噪声中等规模量子设备"——上面纠缠是一把双刃剑。要执行量子算法,你得让大量量子比特彼此纠缠:这是"构建"。但构建纠缠的门操作同时也会把单个比特的错误迅速传播到整个芯片,严重时可能抹平量子计算机对经典计算机的全部优势。
这正是"保护—操作两难":你需要纠缠来做计算,又怕纠缠让错误失控。
"构建—移动"框架为此提供了一个新视角。MBL那种移动主导型动力学——纠缠增长被压制到对数级别、错误扩散极其缓慢——天然适合充当量子存储的"保护区"。而量子编译器(负责把量子算法映射到芯片实际连线的软件)里无处不在的SWAP路由操作——芯片上只有近邻量子比特能直接交互,远距离操作必须靠一连串SWAP门把量子态搬运过去——本质上就是在调用隐藏纠缠蓄水池:不产生新纠缠,只重新分配。
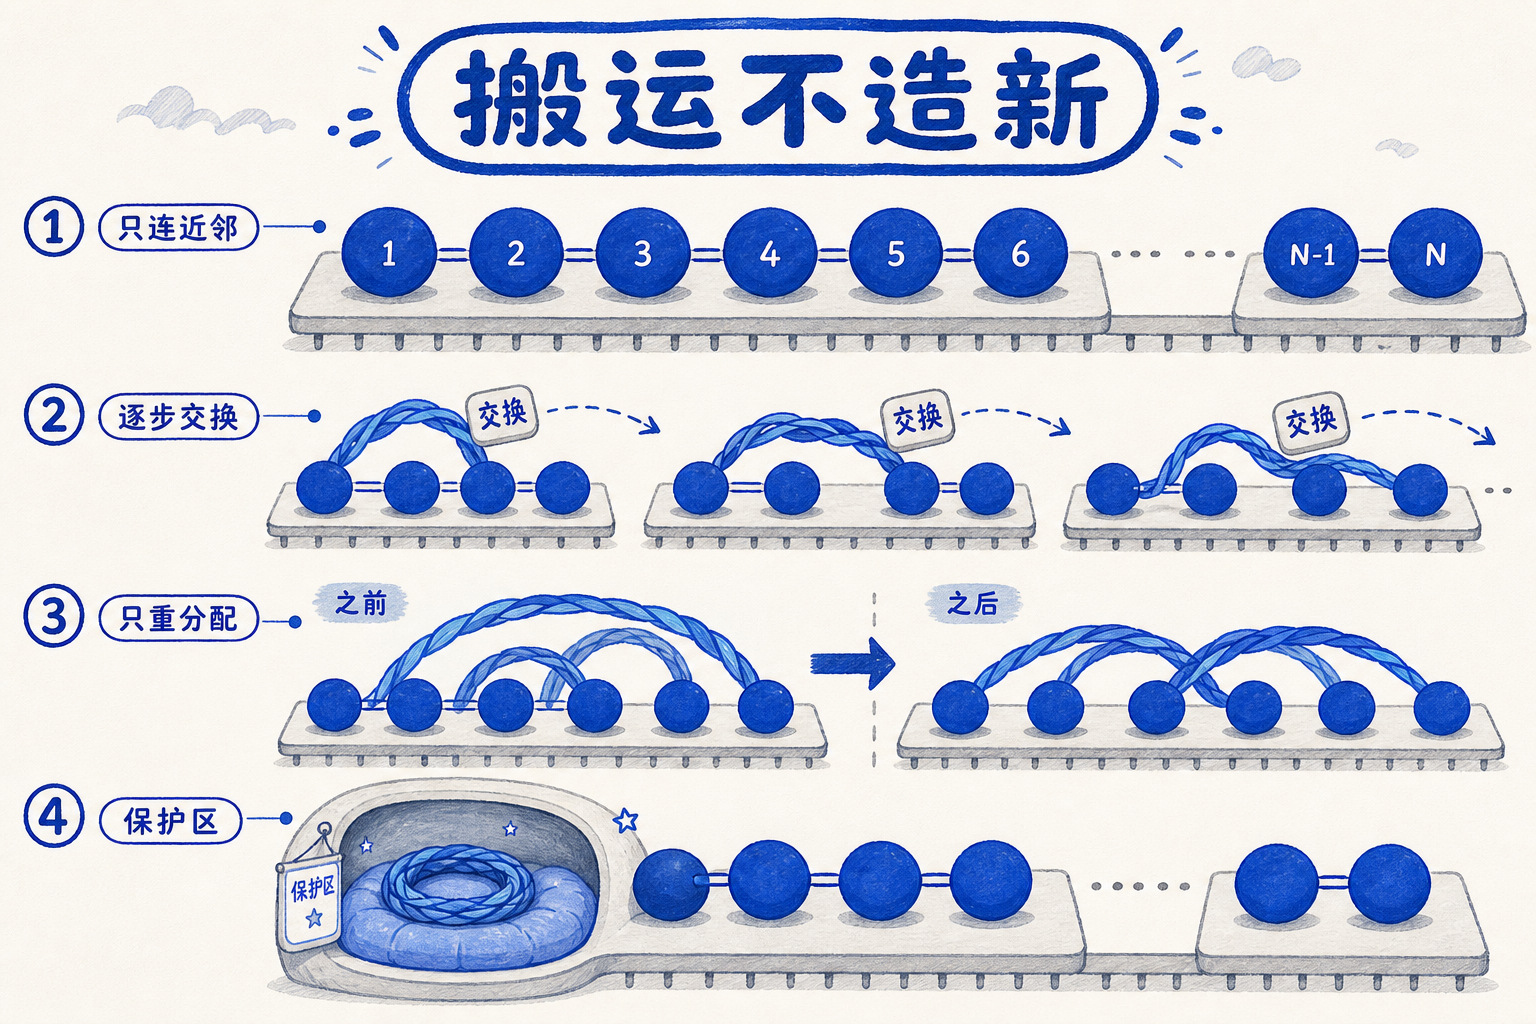
这意味着量子编译器的优化逻辑可能需要重写:优化SWAP路由时,只看固定截面上的纠缠熵变化是不够的,子系统内部的纠缠结构同样在付出代价。BAEE这个全局度量,或许能成为编译器的新"仪表盘"。
更深远的是,团队在后续工作中发现,不同的量子动力学演化会在纠缠的空间分布上留下不同的"几何指纹"。一个真正运行哈密顿量的量子模拟器,会在纠缠结构里留下独特的空间模式;而经典随机线路则把这些指纹抹得干干净净。这意味着,未来你只要去测一个声称是"量子模拟器"的设备,看它的纠缠结构是否携带这种指纹——就能甄别它是在认真做量子模拟,还是在用经典线路冒充。
当然,这些应用目前仍停留在理论构想阶段。但方向已经很清楚:纠缠不止是"有多少"的问题,更是"分布在哪"的问题。
出了这条一维链,这个漂亮框架还站得住吗?
所有漂亮的分类都有一个共同的脆弱之处:边界条件。
"构建—移动"框架建立在一维、短程相互作用的量子自旋链上——这恰好是理论物理学家最擅长精确处理的模型,也恰好是离真实世界最远的简化。一旦走出这个舒适区,地基就开始松动。
首先是维度。二维和三维系统中,连接不同二分方式的SWAP图拓扑完全不同,纯移动下BAEE是否仍然守恒,目前没有证明。更致命的是,MBL本身在二维以上能否稳定存在,在学术界至今是悬案——有论证认为高维系统中某些罕见但致命的"热点区域"会像多米诺骨牌一样逐片摧毁局域化,系统最终还是会热化。如果MBL在高维不存在,"移动主导型"分类就失去了核心案例。
其次是作用范围。当自旋之间的相互作用衰减得足够慢时,"构建"和"移动"会变得不可分割——同一个物理过程既在制造新纠缠又在重新分配旧纠缠,就像一场暴雨同时在下雨和开闸。团队的三分法分类在这种系统中需要被重构。
最后是开放系统——也就是跟外界环境有能量或粒子交换的真实量子系统。一旦耦合了耗散环境,纠缠熵里就混入了经典随机性,"纯态纠缠熵"的概念本身失效,BAEE的定义也随之崩塌。在这个领域,框架完全不适用。
但认识到这些局限,恰恰是框架的价值所在。它第一次把"纠缠在哪"的问题放在了和"纠缠有多少"同等重要的位置——而这个问题,对理解量子信息如何在复杂系统中流动,可能比纠缠总量本身更关键。
张春悦团队最重要的贡献,或许不是那三个分类标签,而是迫使我们换了一副眼镜来看量子纠缠:不再只盯着一个截面上的水位,而是去追问全流域的水究竟藏在哪里、正往哪里流。对正在设计下一代量子芯片的工程师而言,这意味着纠缠不再只是一个需要"攒够"的资源——它是一张需要被"排布"的地图。
过去我们问的是"纠缠增长了多少",现在该问的是——增长的,真的是新的吗?