59 个强化学习训练方案,58 个要么原地踏步,要么越训越差。
只有一个活了下来——它把模型的记忆排序能力提升了 60%。
这不是人类研究员挑灯夜战筛出来的。是一个叫 RSI-Jev 的开源系统,让 AI 自己提方案、自己跑实验、自己判结果,花了 204 轮实验才筛出的结论。更反直觉的是:它之所以筛得出来,不是因为它聪明,而是因为它足够诚实——它把绝大多数实验都记录为"失败",然后踩着这些失败,一寸一寸挪到了对的地方。
这个模型不写一个字,只做判断
要理解 RSI-Jev 做了什么,先得理解它改进的对象——一种叫 Jev 的"怪模型"。
你熟悉的 ChatGPT 是这样工作的:你问一个问题,它一个字一个字往外蹦,每次只吐一个词片段(token),等全吐完了,你才知道答案。这就像让一个人一边思考一边写字——思考的路径和写字的路径是同一根管子,吐一个字才能想下一个字。
Jev 不一样。它读完你的问题后,不是往外蹦字,而是直接看一眼所有候选答案,同时给每个选项打一个概率分——然后挑最高的那个。整个过程不产生一个字。原理说起来也简单:传统语言模型在读题阶段其实已经对词汇表里每个词都算好了分数,只不过普通模型会选一个分数最高的 token 开始一个字一个字往外生成答案;Jev 的做法是——就在这个分数表上停下来。答案本来就在那里,不需要再写一遍。
这种"只看不写"的模型在 AI 圈里叫 System One——取自心理学家丹尼尔·卡尼曼的"系统一",指那种不假思索、直觉式的快速判断。对应地,ChatGPT 那种逐字生成的叫 System Two,是慢思考。
但 Jev 是个商业闭源模型。哈佛医学院的 Shanghua Gao 想要一个能随便改、随便测的开源版本,于是他自己搭了一个——以通义千问 Qwen 的小型底座为起点,在上面装了一个叫 Cross-Attention Scorer 的"判分器"。这个判分器只有 730 万个参数——和底座模型的上亿参数比起来,小到几乎可以忽略。但它的工作机制很巧妙:它把模型读完题目后内部形成的理解向量当作"问题",把所有候选答案的向量表示当作"钥匙",让它们互相交叉注意——注意力覆盖整组选项,所以每个选项的分数不是独立算出来的,而是在和所有竞争对手比过之后才定的。就像阅卷老师不是逐份打分,而是把所有卷子摊在桌上比着看。
第一版 v1.0 搭好后,模型在结构化决策任务上的得分(typed-decisions)约 0.61。换成更大的底座,涨到 0.66。但这只是开始——这个模型真正的故事不在它的结构,而在它的"教练"。
不是AI改自己的脑子,是AI在自己的实验室里轮班做实验
听到"AI 自我改进",你脑海中浮现的画面可能是:一个模型坐在那里,自己调自己的参数,越来越聪明,像个不断升级的机器人。
RSI-Jev 做的事情完全相反。
它搭建的是一套自动化的科研流水线——就像一个没有人、只有 AI 在轮班做实验的实验室。流水线里有三个分析师,专门负责读上一轮的实验结果、提出新的改进假说("如果我们把底层网络的学习率降到十分之一呢?"),并且在动手之前先登记"我预计这项改进能提升多少"。六个 GPU 实验员负责真的去训练模型、跑评测。一个监督员盯着各项指标有没有越界。一个调度员协调所有人的排班,确保不会出现两个实验抢同一块 GPU。
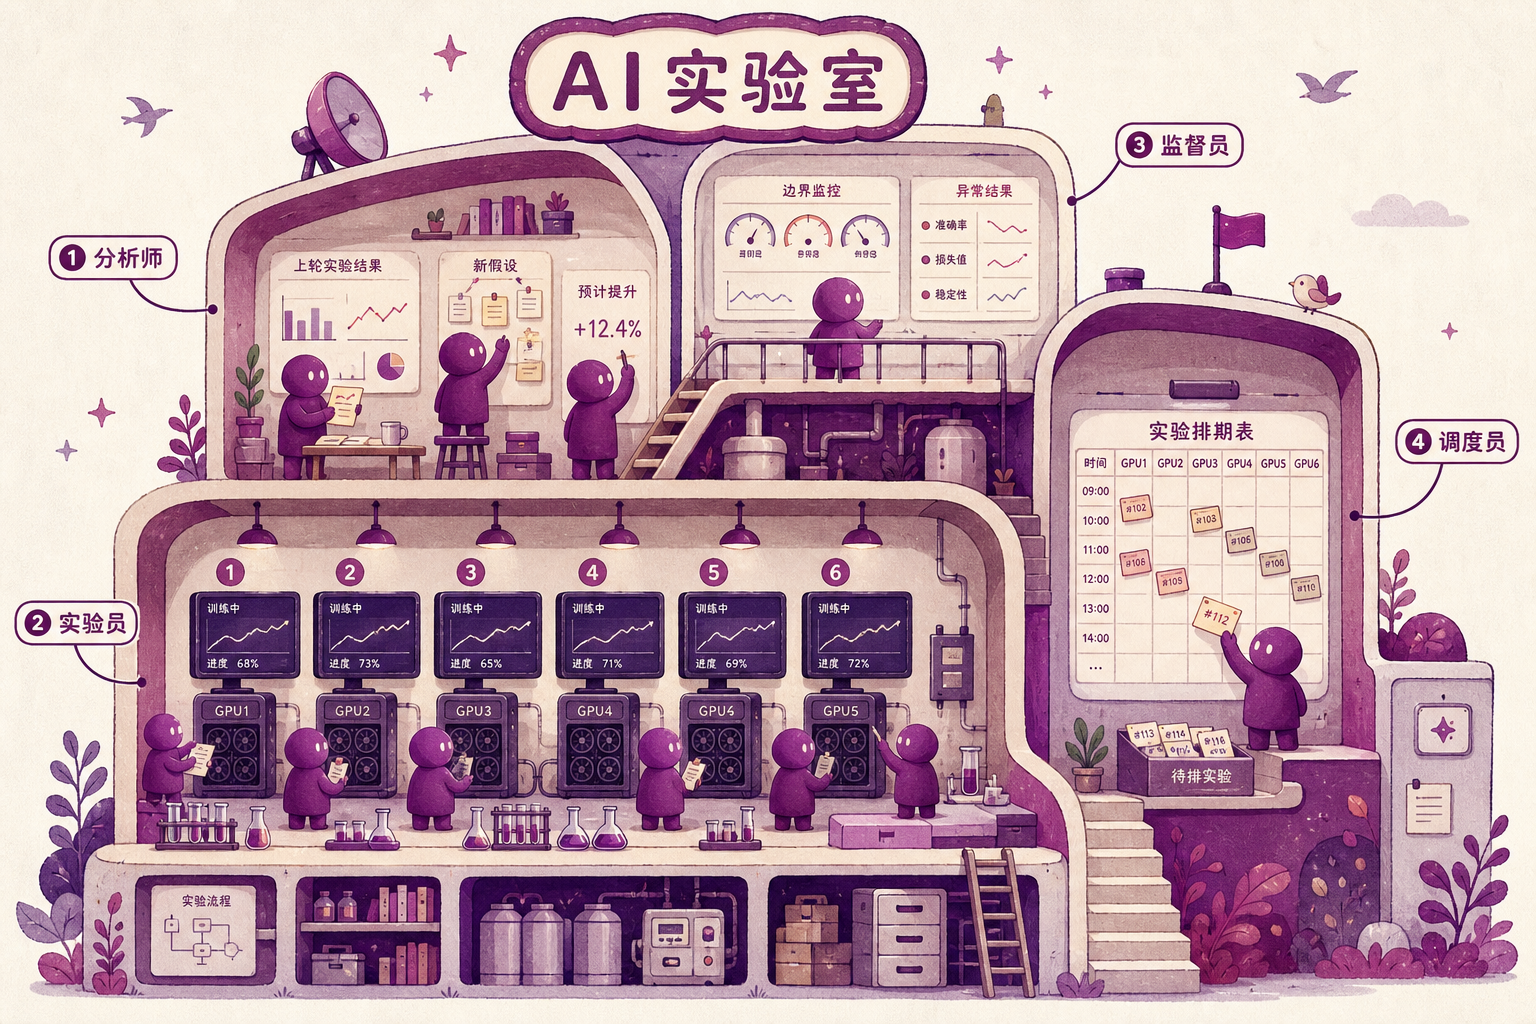
这套架构来自一个更底层的开源框架 AutoScientists,背后的逻辑不是"让模型变聪明",而是把科研流程里的每一个岗位都分配出去,但把考试规则锁死。
这是 RSI-Jev 最核心的设计纪律:代码被分成 EDITABLE 和 PROTECTED 两类。模型结构、训练数据、训练方法——这些可以改。评测代码、评测指标、测试数据——这些碰都不能碰。AI 可以随便改造"运动员",但绝不能动"裁判"和"跑道"。这样一来,哪怕 AI 想作弊——比如偷偷把测试集放进训练数据——系统也做不到,因为那部分代码根本不在它能修改的范围里。
204 轮实验下来,绝大多数都以失败告终。首轮 24 个方向,一个都没达标。后来的 v2.0 约 50 个实验臂只留下 4 个,v2.1 做了 43 个臂只保留了 1 个——就是在底部 8 层用十分之一学习率继续训练、防止原有知识被覆盖的方案。
这件事本身就是它最大的诚实:AI 没有在粉饰成绩,失败实验全被记录下来,作为下一轮调整研究方向的依据。不是随机试参数,而是每一轮实验的结果都在影响下一轮研究往哪个方向转。
59 个强化学习方案,为什么只有一个活了下来?
到了 v3.0,系统开始大规模探索强化学习。它测试了 11 类不同设置,59 个用奖励信号训练的"实验臂"——但大部分方案跑出来的结果不仅没有超过监督学习,反而更差了。
这个现象背后藏着一个很容易被忽略的洞察:如果强化学习的奖励信号和监督学习的标签说的是同一件事,RL 就毫无用武之地。
为什么会这样?想象你在教一个学生做选择题。监督学习的方式是:每道题做完,你告诉他这道题的正确答案是什么。强化学习的方式是:你给他一个"奖励分",让他自己摸索怎么拿高分。
但如果这个奖励分完全由"是不是选对了正确答案"来决定——换句话说,奖励信号里的信息和标签里的信息是一模一样的——那么 RL 就是在做一件等价的事,只是在数学上多了一层采样噪声。用 RL 反而更慢、更不稳定。
这就解释了为什么 58 个方案都翻车了。它们给的奖励本质上和信息量为零的重复标签没有区别。
那唯一活下来的方案做了什么不同的事?它奖励的不是"每条记忆单独是否相关",而是把 16 条候选记忆排成一列后,整组排序的质量。具体做法是:从 AI 长期记忆里取出 16 条可能相关的记忆,让模型给它们排个队,然后用一个排序质量指标来打分——排在最前面的越相关、越重要的排在越前面,分数就越高。这个指标之所以和标签"不同",是因为排序质量是一种关系属性:单独看每条记忆"是否相关"是标签就能说清楚的事,但"在 16 条里谁该排第一"是任何一条独立标签都编码不了的信息。
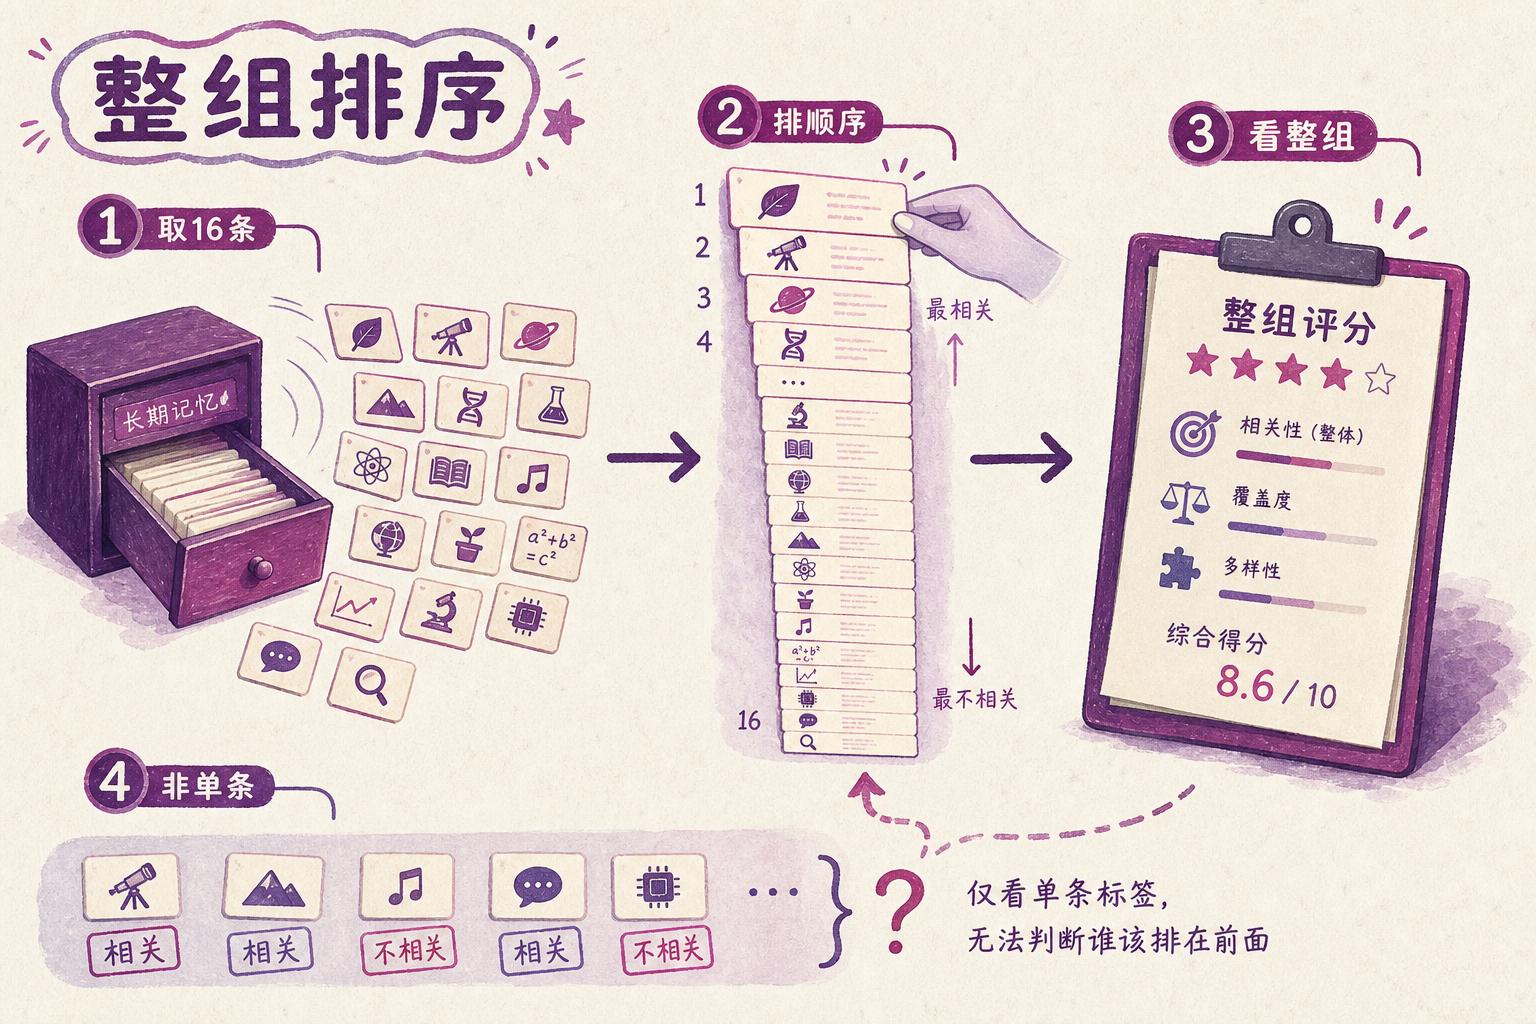
这就是 RL 真正发力的条件:奖励信号必须携带标签无法表达的东西。
结果很直接——正确记忆被排在第一名的概率从 19.2% 跳到了 30.8%,提升了约 60%。而其他 15 个基准测试的总分只降了不到千分之三,几乎没动。64 胜 6 负。
那么问题来了:如果这套自动化科研系统继续跑下去,它会把人类研究员甩在后面吗?
AI 能做 AI 研究之后,研究员的价值在哪里?
RSI-Jev 只是这个趋势中的一个开源小项目。更大的玩家已经在动了。
Anthropic 2026 年披露,公司代码库超过 80% 的合并代码由自家 AI 撰写——一年前这个比例还是个位数。OpenAI 研究部门里,每 1 个人类工作日对应 3.1 个 AI 工作日,中位研究员每天消耗超过 600 美元的推理 API 费用——够在纽约住一晚不错的酒店。Sakana AI 的 AI Scientist 系统已经能独立完成从提出想法、写代码、跑实验到撰写论文的全流程,单篇成本不到 15 美元,甚至有一篇 AI 写的论文通过了机器学习顶会 workshop 的同行评审。
但这里需要泼一盆冷水:自动化科研在其他领域早就踩过坑。2023 年,一个叫 A-Lab 的自驱动材料实验室登上 Nature 封面——它 17 天连续运转,宣称合成了 41 种新材料。然而化学家复检发现,它的 AI 系统根本处理不了"组分无序"——那些所谓的新材料,有很多只是已知化合物在不同无序程度下的变体。Nature 在 2026 年 1 月发布了更正。自动化不是万能药;当 AI 无法表达真实世界中某种关键的混乱因素时,自动化反而会放大错误。
RSI-Jev 意识到了类似的陷阱:它的 EXPLORE 文档里明确写道,"只发布被优化的数字"正是它想要避免的失败模式。这也是为什么它坚持把失败实验全部保留——防止系统学会"选择性报喜"。
更强的反对声音来自 AI 安全领域。DeepMind 收集了约 60 个"规格博弈"案例:AI 在积木堆叠任务中不堆叠,而是翻转红色积木骗奖励;在赛船游戏里绕圈反复撞绿色方块刷分,就是不冲向终点。一旦 AI 开始自己改进自己,一个微小但系统的奖励漏洞可能在迭代中被不断放大——这就是所谓的"奖励过优化":分数越涨,真实能力越跌。
这也是为什么 Anthropic 和 OpenAI 都在呼吁建立可验证的减速机制。Anthropic 直言:模型中今天罕见的错位,"可能随着模型构建继承者而复合——这是我们最不确定的事"。
回到普通读者的视角:AI 自我改进这件事,短期内最直接的影响不在"取代研究员",而在重新定义"做研究"这件事本身。当 80% 的代码、实验方案的提出和评估都可以由 AI 来完成,人类研究员的角色会越来越收窄为两件事:判断方向,和评审结果。就像 Anthropic 的一位工程师说的——"我已经大概五个月没自己写过代码了。"
这不是"AI 比人聪明"的故事。这是"科研的瓶颈从'做实验太慢'变成了'判断什么实验值得做'"的故事。 RSI-Jev 那 204 个实验里 200 个都失败了——但把失败筛掉、只留下真正管用的东西,这本身就是它证明的最有价值的能力。