想象你坐在一张93人的长桌上。每个人轮流发言,但规则很奇怪——每句话都以完全相同的音量叠加进集体记忆。第一个人讲完,总音量是1。第二个人讲完,总音量变成2。到第93个人开口时,他的声音被前92人的声浪彻底淹没。
不是他说得不好。是规则本身注定了后来者的无力。
过去十年,每一台大语言模型——学名叫Transformer——都在重复同一场对话。Transformer能堆到几十上百层,靠的是"残差连接":每一层把自己的输出以1:1的固定权重加进主干数据流,就像饭桌上每个人的发言都以相同音量叠加。这条规则始于2015年的ResNet,初衷是给深层信号留一条快速通道。它太成功了,以至于从GPT到Claude到Kimi,每一台大模型都原封不动继承了它。
但这里藏着一个反直觉的缺陷:过去十年几乎所有人都以为残差连接是深层网络的保护神,但它的1:1等权累加对每一层的新鲜计算恰恰是慢性杀手。
为什么堆了93层,最后一层却"几乎没说话"?
2015年,何恺明等人提出ResNet,核心创新是一条不经过任何变换的直通车道:每一层只学一个"修正项"(残差),再以固定权重1.0加回主干。152层就拿下了当时最权威的图像识别竞赛ImageNet冠军。
三年后Transformer登场,原封不动继承了这个设计。但到了2020年前后,研究者发现一个棘手的问题:为了让深层Transformer稳定训练,必须把"层归一化"——一种稳定训练的数学操作——从残差块的衔接处挪进残差分支内部(从Post-Norm切换到Pre-Norm)。Pre-Norm让训练不再需要繁琐的预热步骤,GPT系列全面倒向这一方案。
代价也随之浮现:主干数据流的数值范围随深度线性膨胀。50层的模型里,单层贡献平均只占2%——一场50人讨论中你的发言权重和别人一样,但总音量把你的声音稀释到只剩五十分之一。到了93层,最后几层的新鲜计算在历史累积面前几乎可以忽略不计。
学术界管这叫"PreNorm稀释"。后果是双重的:深层网络几乎学不到真正的新特征,而反向传播中用于指导模型调整参数的数学信号——梯度——也被困在浅层。大模型越来越深,但新增的层并没有在"思考",只是在重复浅层已经搞定的模式。
那么问题来了:这个缺陷存在了十年,为什么没人修?
不是没试过。有人给每一层配一个可学习的固定标量来缩放残差,有人推导出精细的初始化公式让模型稳定训到1000层,还有人尝试用固定权重而非1:1来做跨层加权。但它们都碰到了同一堵墙:所有方案用的都是"固定权重"——不管输入是什么,每一层的残差缩放比例永远不变。
真正的问题在于,不同输入需要不同层的历史信息。解一道代数题可能需要第12层的推理步骤,写一段代码可能需要第67层的语法模式。固定权重的方案相当于对所有人发同一张食谱——粗粒度上管用,细粒度上错得一塌糊涂。
给每一层一个"调音台"——AttnRes是怎么做到的?
回到那张长桌。如果规则允许发言者根据当前讨论的焦点,自己决定多听前面谁的发言、少听谁的——后来者就不再注定被淹没。
这就是今年3月公开的Attention Residuals(注意力残差,简称AttnRes)所做的事。
经典残差的写法是:第l层的输出 = 前面累积 + 本层计算,加号两边系数永远是1:1。AttnRes把它改成:第l层的输出 = 前面所有层输出的加权和,权重由第l层自己打分决定。每一层都有一个微小的"伪查询向量"——可以理解为这一层的好奇心——扫过前面每一层留下的信息,问一句"你跟我现在的任务有多相关?",据此分配权重。所有权重加起来恰好等于1,输出的数值范围天然有上限,不会随深度膨胀。
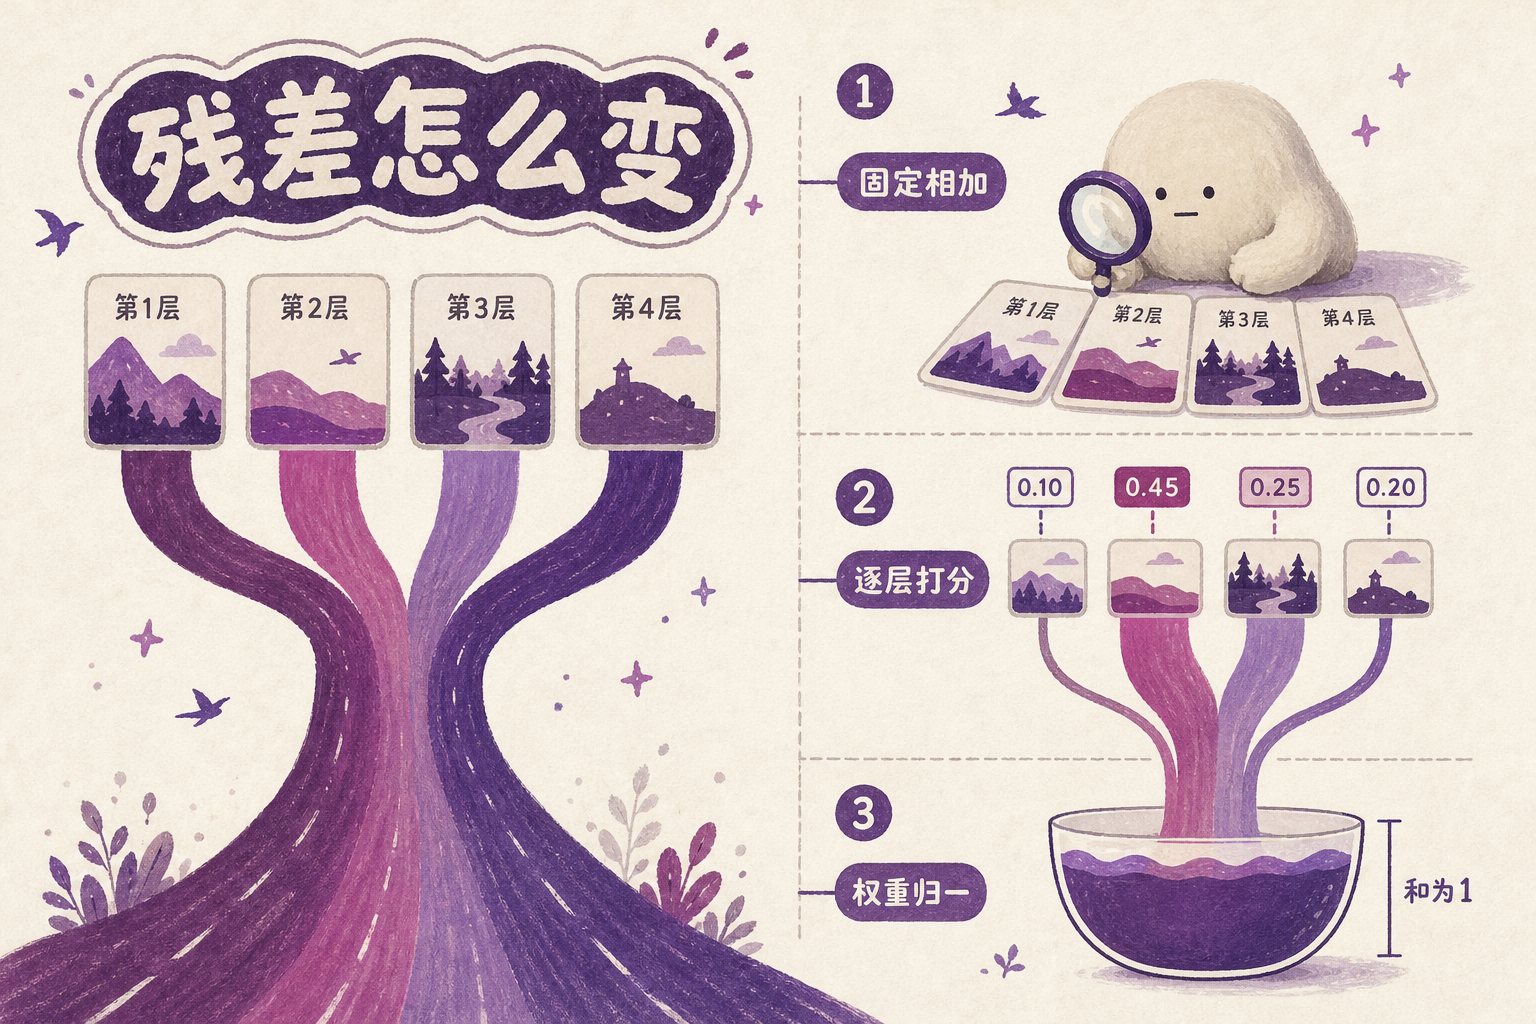
换句话说,经典残差是固定1:1权重的"最粗糙的注意力";AttnRes等于把注意力机制旋转了九十度:不再在同一个句子的不同词之间分配关注,而是在深度方向上、在不同层之间分配关注。每一层第一次拥有了对历史的"选择性倾听"。
但这里有一个明显的代价。如果第93层要对前面92层逐一打分,存储量随层数线性增长,计算也会变成平方级——对于上百层的大模型,这不可接受。
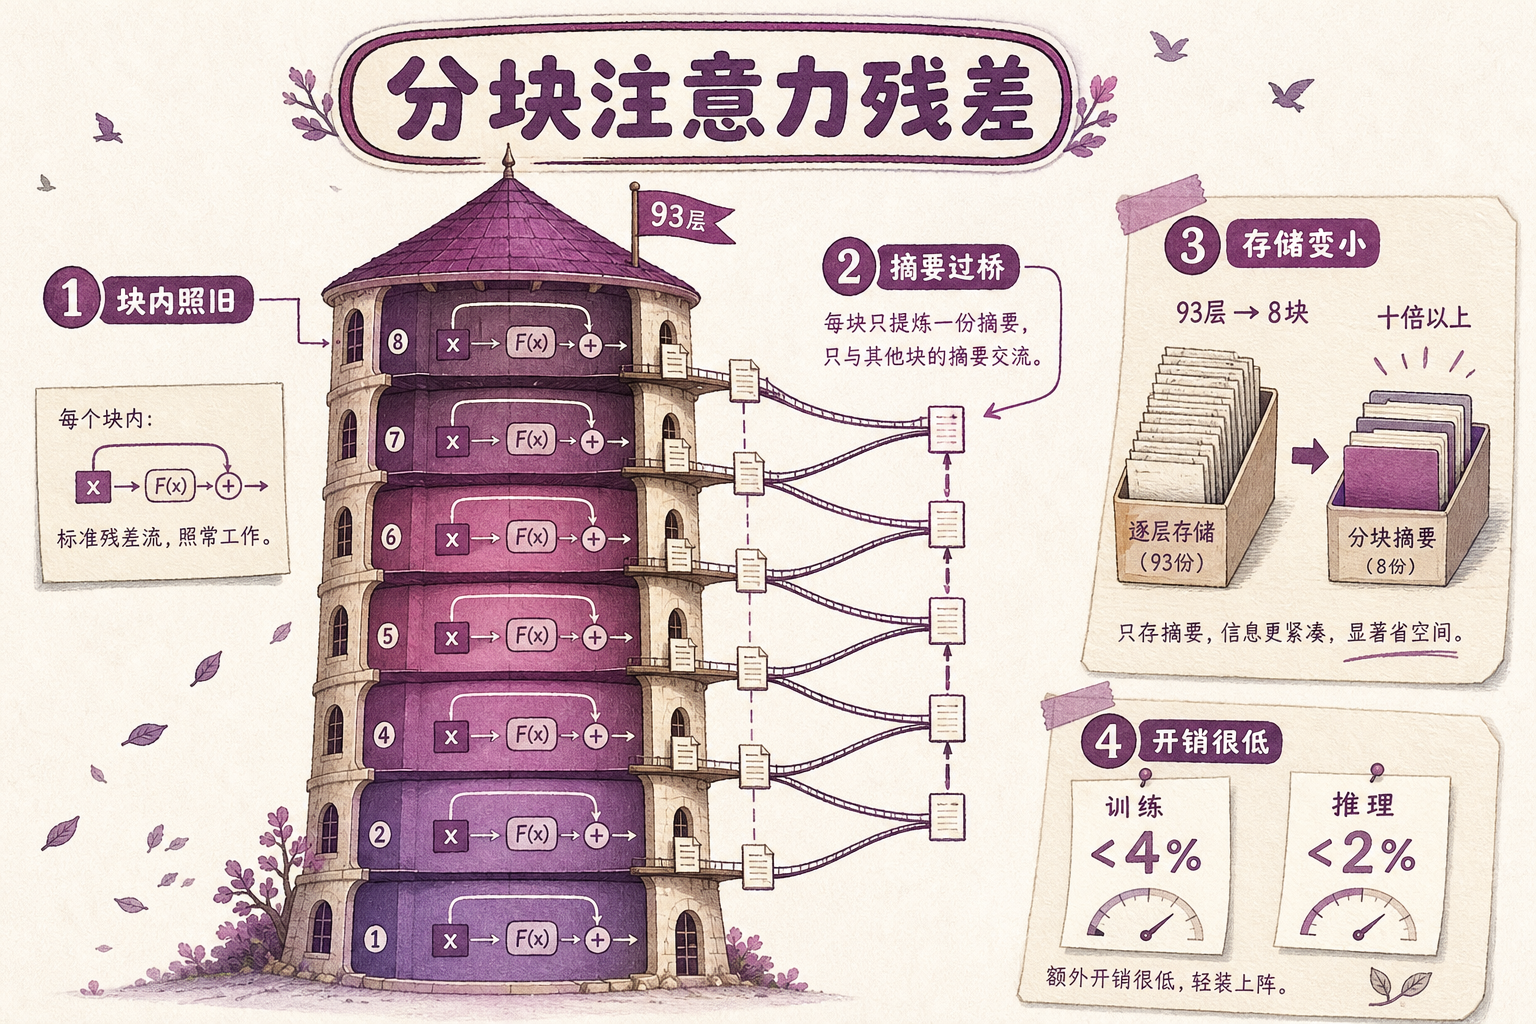
研究团队的解法叫分块注意力残差(Block AttnRes):把93层拆成若干块,比如8块。块内部照旧用标准残差——省掉块内的打分开销;只在块与块之间做注意力路由。每一块选出一个有代表性的信息摘要代表整块,跨块通信只在这几个摘要之间进行。存储量从"跟层数成正比"骤降到"只跟块数成正比"——93层拆成8块,存储需求缩水了十倍以上。论文实测:Block AttnRes引入的训练时间开销不到4%,推理延迟增加不到2%。
那么效果到底怎么样?
在Kimi Linear 48B模型上用1.4万亿个文本单元做预训练对比。GPQA-Diamond——一个博士级理科推理题基准——从36.9分跳到44.4分(+7.5),代码生成HumanEval提升3.1分,数学推理MATH提升3.6分。更关键的是缩放律实验——在不同模型规模上反复验证增长趋势——达到同样的训练损失,经典残差需要多烧25%的算力。论文作者之一苏剑林这样概括:"大约5%以内的开销,换取25%的收益。"
训练成本打75折:谁能拿到这张船票?
今年7月发布的Kimi K3给出了第一个生产级答案。K3是一台2.8万亿总参数——约与GPT-4同处一个量级——每次激活1040亿参数的模型,采用混合专家架构(把模型拆成多个"专家"、每次推理只唤醒一小部分),93层深,支持上百万文本单元的上下文窗口。技术报告里明写:K3"建立在注意力残差之上"——AttnRes不是实验玩具,而是K3架构的核心支柱。K3在大模型竞技场Arena的编码盲测中拿过第一,超越了Claude Fable 5。
所以谁先受益?凡是从零预训练新基座模型的实验室。AttnRes是一个"即插即用"的替换——不改训练管线、不改优化器、不改数据流,把残差计算的几行代码换掉就行,官方已放出完整开源实现。按1.25倍算力等效来算,每100万美元训练预算相当于买到125万美元的模型质量。
但谁拿不到这张船票?所有已经训完、部署上线的现有模型。AttnRes改的是模型结构本身——GPT-4、Claude、Gemini这些已烧完数亿美元训出来的模型,没办法"回厂加装"。改结构意味着从头重新预训练。短期最大的赢家,是正在规划下一代模型、尚未大规模投入训练的那些团队——恰好,大模型军备竞赛远没到终点。
还有一个被低估的变化。论文系统测试了不同深度和宽度组合后发现,AttnRes有一个强烈偏好:它喜欢"更深更窄"的模型。传统上,模型设计师在深度和宽度之间要做痛苦的权衡——深了容易退化,宽了算力飙升。AttnRes缓解了深度侧的退化压力,把这条权衡曲线往外推了一截。未来的模型可能会更"瘦高"——这对推理效率是好事:更窄的层意味着更少的并行计算单元。
当然,1.25倍需要被正确理解。它不是"每一步计算快25%",而是"更短训练达到同等质量"——省的是总时长和总耗电。论文只在480亿参数规模上做了完整验证,更大规模上是否还能维持同样优势,目前未知。
一个17岁少年改得动的,和一个团队还没摸到的边界
到这里,镜头该拉回到故事里那个人了。
2025年初,陈广宇还在通过阅读论文和借助AI工具理解机器学习的基础概念。几个月后,他开始编写底层计算内核,在开源社区分享自己的研究。2025年11月,月之暗面的核心技术大牛杜雨伦——MIT博士、生成模型领域的顶级学者——把他招进了公司。那时他16岁。
接下来不到一年里,他和队友一起死磕底层计算内核的性能优化,和苏剑林等人共同构思并完善了注意力残差架构,在最底层的训练动态里摸爬滚打,甚至一边和队友看世界杯一边赶制K3的发布案例。他在告别推特里写:"在Kimi的过去一年是我人生中最美好的一年。感谢一切,尤其是杜雨伦当年相信并聘用了一个16岁的我。"
但AttnRes不是童话,它有一本正经的局限。统计上,GPQA-Diamond只有198道题,+7.5分大约对应多答对15题,单次运行有可能落在噪声范围内。结构上,分块策略牺牲了部分跨层信息——块与块之间的"摘要通信"是否会丢失某些长程依赖,目前没有定量分析。
最尖锐的质疑来自MIT研究者刘子鸣。他发现如果只是对残差按层数做简单缩放——第l层的贡献除以l——某些玩具实验上效果与AttnRes打平。这意味着部分收益可能不是来自可学习的注意力,而仅仅来自对历史累积的归一化。团队成员自己也意识到了这个缝隙:后续工作发现AttnRes对"历史累加态"做路由在深层权重坍缩到约0.2,意味着深层几乎不做区分性选择。改为对层间"变化量"做路由后,最大权重回升到0.6,区分能力恢复,困惑度(衡量模型预测准确度的指标)再降1.7%到8.2%。方向大概率是对的,但"深度维该路由什么"的答案还没写完。
如果你从这些事情中只读到一个天才少年的故事,就读窄了。AttnRes真正在说的,是十年里每一个做Transformer的人都知道残差连接有个小毛病,但谁也没觉得它能被修——直到有人真的动手修了,而其中一作的年龄和这份工作的分量形成了整个行业都忍不住点开看一眼的反差。
对正在规划下一代模型的实验室,AttnRes意味着同样的电费和GPU小时能训出更好的模型。对正在读机器学习论文的学生,它意味着大模型的核心构件并不比微积分更难接近——经验壁垒正在崩塌。
十年里人人都知道残差连接有个小毛病。没人想到动手修它的,是一张17岁的面孔。
