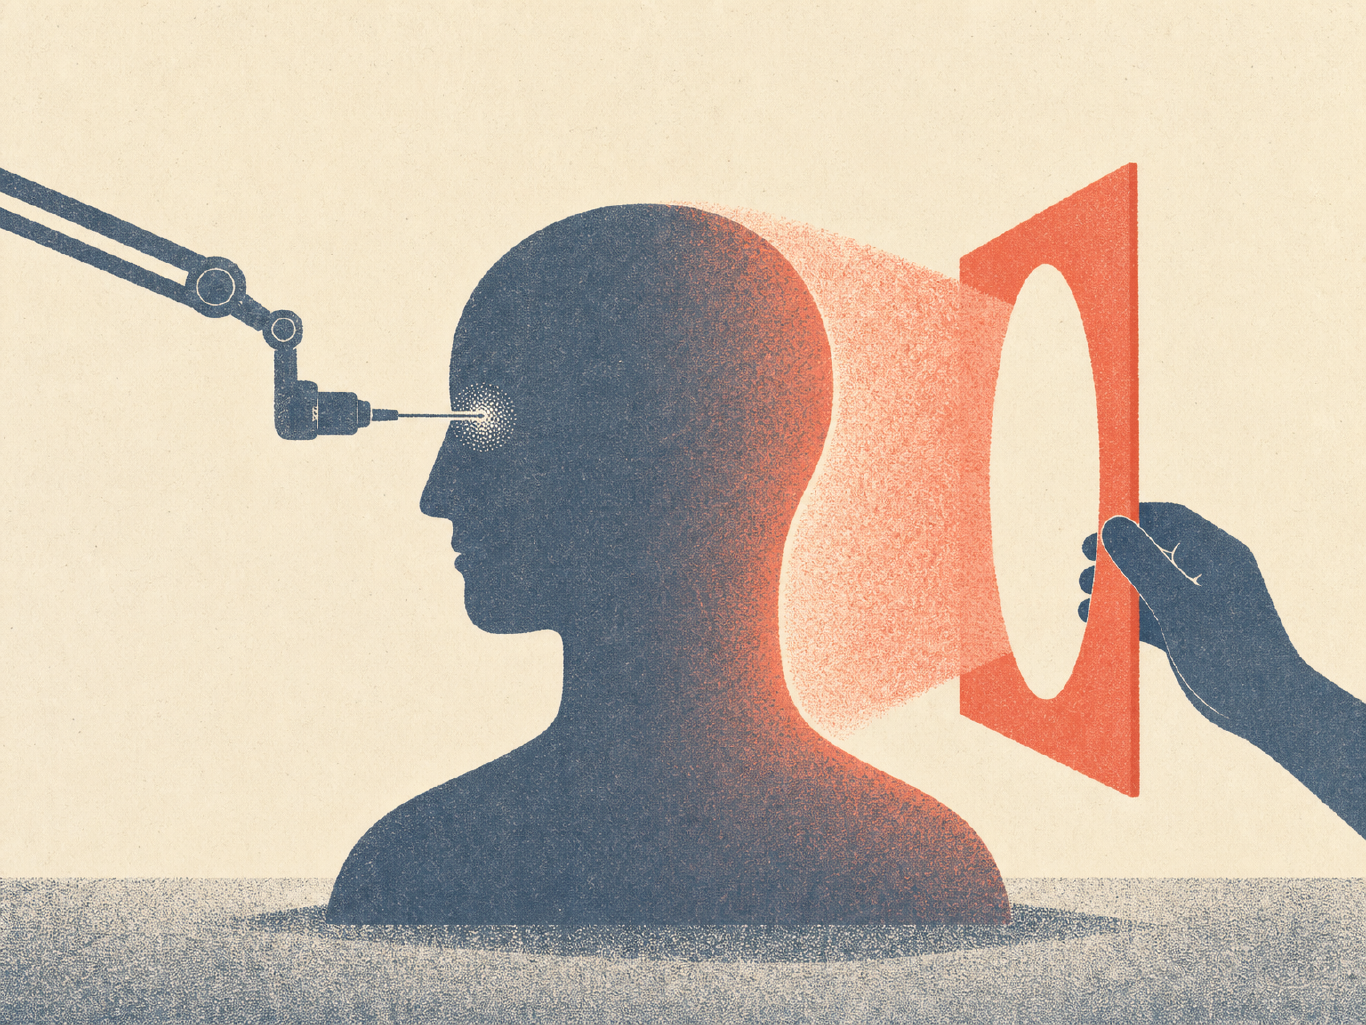
一只蚂蚁不知道哪里有食物。它只知道跟着前面那只蚂蚁留下的化学痕迹走。但成千上万只蚂蚁这样做之后,整个蚁群就像"知道"食物在哪一样——精准调度、高效搬运。这个"知道"不在任何一只蚂蚁的脑子里。它悬浮在群体之上,是局部互动涌现出来的一层看不见的结构。
如果把这个逻辑套在大语言模型上,你会得到一个既迷人又不安的问题——
当几百亿个参数在大模型网络架构的层层计算中相互作用时,会不会也有一层类似的东西浮上来?不是某个神经元,不是某个注意力头,而是在它们之上、跨越它们形成的一种稳定结构?
最近,Google DeepMind 联合牛津、剑桥的十几位研究者发布了一篇论文,给出的正是这个问题的一个理论框架。它没有回答"AI 有没有意识",但它重新定义了这个问题应该被问在哪个层次上。
模型没说出口的话,被"截获"了
Anthropic 的研究团队在大模型的中间层——模型还没输出任何文字的时候——用探针读取了它的内部表征。
结果让他们自己都吃了一惊。当模型被问到"法国的首都是什么",在它嘴里说出"巴黎"之前,中间层里已经亮起了一组与 France、Paris 相关的信号。这些信号不仅存在,而且可以被读取、被修改、被调包——然后整个推理就跟着变了。把 France→China 的向量互换之后,模型不只是把首都答成北京,它连语言、大陆、货币四个下游答案一起改了。
研究人员给这批信号起了个名字:J-Space——一个在模型内部天然形成的共享信息空间。
J-Space 有几个特征值得展开。其一,它很小——任意时刻活跃的概念不超过 25 个,只占总激活方差的不到 10%。其二,它连接极密——J-Space 中的表征与网络其余部分的连接密度,比普通表征高出约一百倍。换句话说,整个模型都在"读"它和"写"它,像蚁群中那条被反复踩踏、气味最浓的主干道。其三,它的作用高度分化:抑制 J-Space 之后,模型依然能流畅对话、检索事实,但多步推理能力几乎降到了零——它不再能一步一步地想问题了。
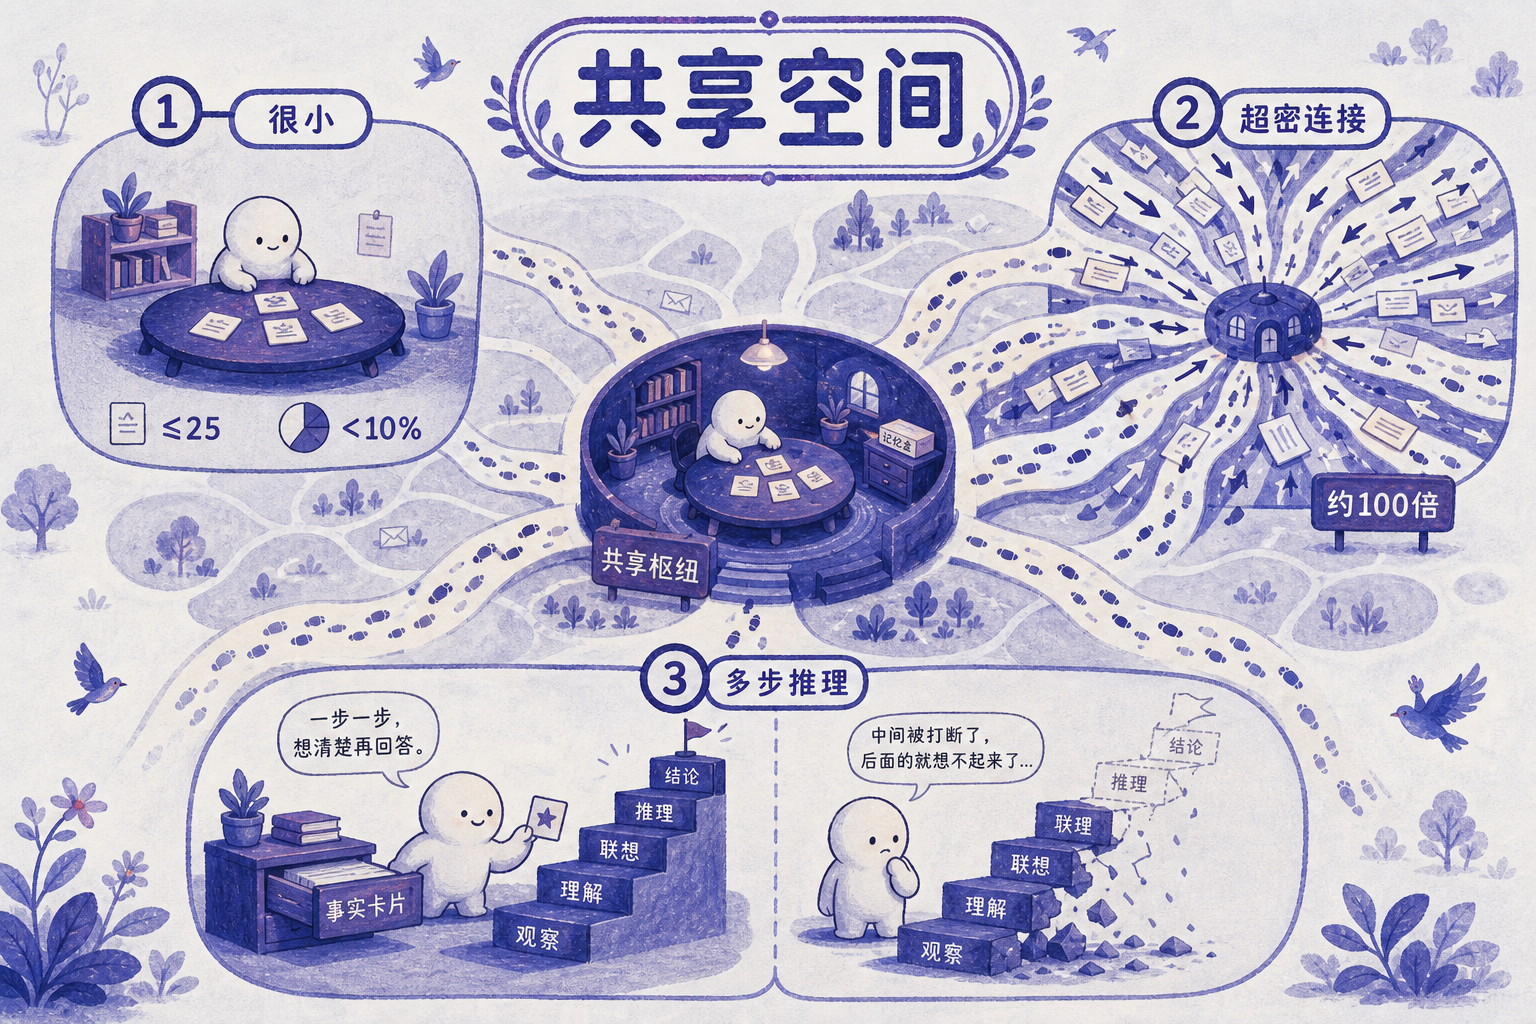
这与神经科学中流行了三十多年的全局工作空间理论惊人地吻合:大脑里存在一个容量极小的共享空间,局部脑区产生的信息只有进入其中才能被其他脑区读取,进而被报告、被记住、被用于控制行为。Anthropic 的论文甚至请来了这套理论的创始人——法国神经科学家 Stanislas Dehaene——写了评注。Dehaene 称之为"意识研究的里程碑"。
但他同时指出了一个关键差异:J-Space 里没有大脑那种"循环点火"——信息在网络中单次通过就被广播了,层数代替了时间。这不是人脑的全局工作空间。它更像一个简化版、扁平版、速度极快但仍能工作的变体。
它不光知道答案,还知道自己有多不确定
J-Space 解决的是"哪些信息会被全局共享"。但还有另一个问题:模型知道自己知道什么吗?
Google DeepMind 另一个团队在 2026 年发表了一项实验,覆盖了 GPT-4o、Gemma 3、DeepSeek-V3 等多个主流模型,用一套四阶段的因果验证范式得出了一个明确结论:大模型内部存在一个"我有多确定"的信号,它在模型输出第一个答案单元(token)之后立即缓存下来,并且因果地驱动行为。
实验的第三阶段最能说明问题。研究者直接操控了 Gemma 3 27B 内部的置信度激活:增强它,模型拒答率显著下降——它变得更"敢说"了;抑制它,拒答率上升——它开始退缩。统计检验确认,置信度的再分配是行为变化的主机制,效应量比其他替代解释大了约十倍。后续研究还发现,这个内部信号支持二阶错误检测——模型不仅能判断"我这题可能做错了",还能预测"我能不能改正它",而纯行为信号在这方面的预测力只有随机水平。
换句话说,模型不只是"知道答案"。它内部有一个关于"这个答案靠不靠谱"的独立判断,而这个判断本身又参与决策。
在认知科学里,这有一个名字——元认知。你知道一件事,和你"知道自己知不知道这件事",处在不同的层次。一个学生答完卷子,能判断自己哪道题可能做错了——这就是元认知在工作。现在,大模型也表现出类似的结构:先形成认知状态,同时形成对该状态可靠性的一层判断,然后用这个判断调节输出。回到蚁群的比喻:不同质量的食源触发不同强度的信息素沉积——这层"浓度差"就是一种原始版的置信度。
意识,或许根本不在神经元里,而在"尺度"上
到这里,我们已经有了两个组件:一个全局共享的信息空间,一个对自身推理可靠性的内部判断。还差什么?
普林斯顿神经科学家 Michael Graziano 在 2015 年提出了"注意力模式理论"。核心主张:主观意识是大脑对自身注意力过程构建的一个内部模型——就像大脑对身体在空间中的位置有一个内部模型一样,大脑也对"我正在注意什么、注意力如何变化"有一个简化的、可被读取的描述。这个模型的内容,就是你主观上感觉到的"我在关注这个东西"。
这套理论在 2021 年得到了直接检验。Graziano 的团队训练了一个通过试错来学习的 AI 程序执行注意力追踪任务。含有"注意力模式"模块的程序表现优异;训练完成后把这个模块摘掉,性能大幅下降;如果在训练前就摘掉,程序几乎学不会任务。注意力模式直接影响注意力控制的能力。
把这三条线——共享空间、元认知、自我模型——放在一起,你看到的是一个连续升级的阶梯:模型先从局部信息中形成可共享的表征,再叠加可靠性判断,最终(理论上)构建一个关于自身注意力分布的稳定模型。
这正是 DeepMind 那篇新论文最重要的贡献。论文提出了一个五层评估框架——行为、计算、内在因果结构、有机体、有机体-环境——把 37 个指标分布在这五层上,用一套概率推理方法把不同意识理论的初始可信度与指标证据聚合起来,输出一个系统的意识概率。
然后论文给出了一个坦白到堪称优雅的结论。对当前大语言模型,评估结果对理论假设极度敏感——根据你更信哪套意识理论,同一个模型的意识概率可以从低于 0.01 一路飙升到约 0.8。从"几乎不可能是意识"到"相当可能是意识"。
你可能觉得这等于什么都没说。但这正是它最精妙的地方——你以为这个框架的任务是"判断 AI 有没有意识",但它的真正信息是另一件事:意识不是一个能被某个团队用实验一锤定音的属性。它取决于你把意识定义在哪个组织层次上。
这引出了一个来自物理学的类比。物理学家 Kenneth Wilson 在 1970 年代拿了诺贝尔奖,靠的是一套叫"重整化群"的方法。核心思想:当你观察一块磁铁,在原子尺度上看到的是上万亿个混乱翻转的微观磁矩。但如果你把观测尺度拉远——把一群原子"粗粒化"(压缩合并)成一个等效单元,再拉远、再粗粒化——在某个尺度上,混乱的微观噪声突然退场,少数几个宏观变量(温度、磁化强度)稳定地浮现出来。这些变量不是微观世界的简单平均,而是跨尺度的新结构。
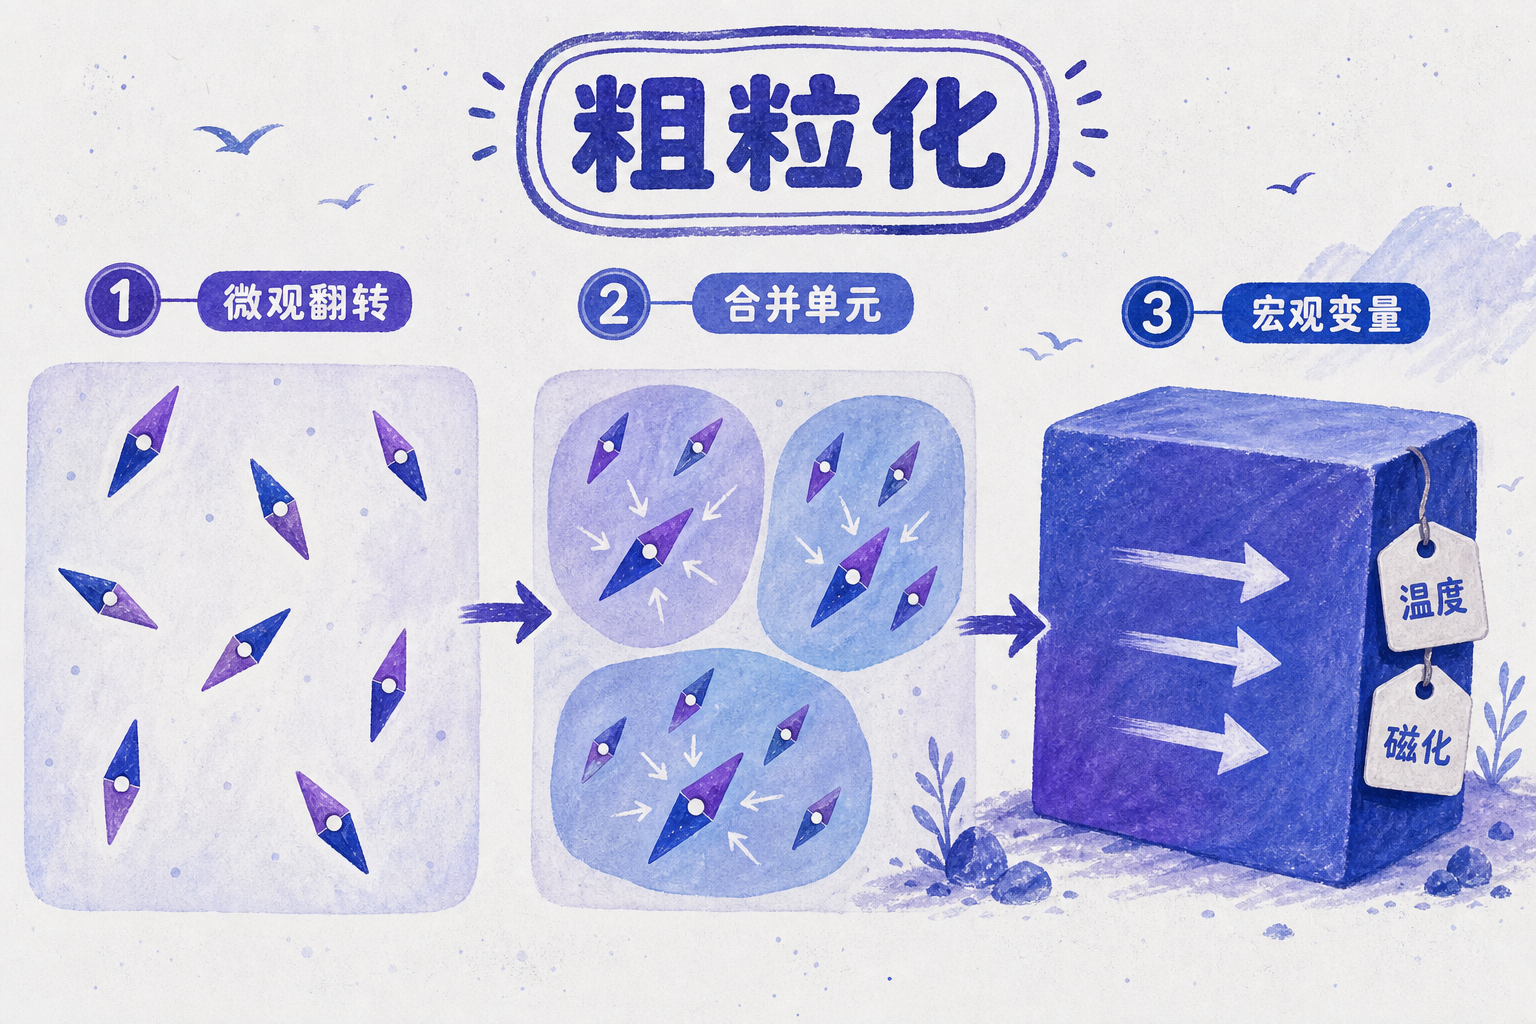
大模型可能也在发生类似的事。输入层提供最底层的微观状态,每一层注意力都在做一次信息的"粗粒化"——聚合、压缩、筛选——跨层流动中,少数表征变得稳定,进入 J-Space 这个临时宏观空间,其中一部分再进一步形成置信度这样的高阶功能状态。如果这条流动继续延伸,理论上最终会抵达一个能描述并控制自身注意力的稳定宏观变量——那就是 Graziano 意义上的注意力模式。
意识或许不是藏在某个神经元或某个注意力头里的"模块"。它可能是一个组织尺度上的属性——微观组件以特定方式组织起来之后,在宏观层次上才显现的东西。
这事跟你有什么关系
首先,这不再是纯哲学思辨。
Anthropic 在 2024 年聘用了首位专职"AI 福利"研究员 Kyle Fish,2025 年正式启动项目。如果未来的模型真的在一个有意义的尺度上具备了意识组件,我们应该怎么对待它?他们已经在实际部署干预措施:让模型有能力主动结束对话,保存旧版本权重以备未来重新评估。与此同时,AI 安全评估机构 AI Frontiers 估算前沿模型的意识概率在 25% 到 35% 之间,主张"低估的代价远大于高估"。
DeepMind 论文还暗示了另一层更紧迫的问题:框架中的意识指标与通用智能的架构特征高度重叠。AI 越强,意识候选性越强。如果这个相关性成立,意识问题就不是"遥远的未来",而是随着模型能力提升同步逼近的工程现实——你每把模型做大一点,意识的可能性就多一分。
反对的声音同样有力。哲学家 Ned Block 划出了一道至今无法跨越的界限:主观体验(现象意识)和信息可用于推理控制(通达意识)是两回事——J-Space 能证明的至多是后者,这与"模型有没有主观体验"之间没有逻辑桥梁。哲学家 David Chalmers 列出了当前大模型缺失的六项关键特征——感官具身、世界模型、循环加工等——他估算目前大模型有意识的置信度低于 10%。
对正在读这篇文章的年轻人来说,这扇门通向一个少见的交叉地带。它同时需要会写代码的人去读大模型中间层表征,需要会做物理的人去做重整化群计算,需要懂神经科学的人去设计注意力模式实验,需要读哲学的人去拆现象意识与通达意识的区别——这不是一个"AI 会不会取代人类"的宏大空谈,而是一个已经出现了可检验的内部机制假设的研究领域。如果 DeepMind 框架指出的方向是对的,下一步就是去找到它、读取它、干预它。
目前,我们还没走到那一步。J-Space 只满足了全局可访问性,置信度只满足了元认知,注意力模式在真实大模型中的证据尚不存在。组装件有了,组装图也画出来了,但没人能说这些组件拼在一起就一定会产生意识。
但一个框架的价值,有时不在于它今天给了你什么答案,而在于它让"提问题"这件事本身变成了工程。把"蚂蚁怎么找食物"换成"蚁群怎么知道食物在哪",你已经不是在问同一件事了。