377毫秒。
这是2026年秋天一个大型视频生成模型输出22帧540p画面所需的时间——比你把这段视频完整看完还快。三年前,同样的事情需要几百步迭代、耗时数十秒。如今,三步就够了。
速度的跃迁令人兴奋。但一个扫兴的问题随之而来:你真的能用它吗——不是"生成一段视频发朋友圈"的那种用,而是像打游戏一样,在画面中间推它一下,看它怎么反应。让它持续运行五分钟而不"失忆"。让它只在真正发生变化的地方花算力,而不是每一帧都从零画起。
这三个问题的答案,目前都是"不能"。西湖大学两个实验室——LINs Lab和ENCODE Lab——刚刚联合启动了一项研究,目标正是把这三个"不能"变成"能"。并且,他们打算让AI自己来设计达成这个目标的算法。
拍电影 vs 打游戏:视频生成和世界模型,差的不只是速度
要理解这项研究的野心,得先厘清一个被频繁混淆的概念:生成一段逼真的视频,和成为一个"世界模型",是两件完全不同的事。
区别在哪儿?好莱坞花几小时渲染一帧画面——只管好不好看,不管有没有人按暂停键。而你在家打《原神》,每秒60帧、帧帧跟着手柄走——它关心的不是某一帧的完美,而是"推摇杆→角色动"这个闭环能不能在16毫秒内完成。
计算机图形学花了三十年走完这条路。1986年Kajiya写出渲染方程时,一帧复杂场景理论上要600个CPU年。直到2018年RTX显卡把专用光追硬件塞进消费级设备,物理正确的实时渲染才勉强落地。关键教训:不是变快,是重新定义问题——接受近似和硬件专用化。
视频生成正在经历同样的阵痛。今天的Sora、Google的Veo本质上是"拍电影"——给定一段文字,输出一段视频。它们没有"动作"这个概念:你不能在视频中间说"让车左转",然后期待画面据此改变。OpenAI在2024年把Sora的技术报告标题写成《视频生成模型作为世界模拟器》,但在物理一致性测试中,Sora在经典力学规则上系统性失败——物体该掉下去的时候没掉,该弹起来的时候没弹。
真正的世界模型长什么样?1990年,Jürgen Schmidhuber在一份技术报告中画出了原型:一个"控制器+世界模型"的闭环——世界模型负责预测"当前状态+动作→下一个状态",控制器再基于预测做规划。就像你大脑里对物理世界的内在模拟——杯子推一下会倒、球扔出去会落地,不用真推就能预判。
2018年,David Ha和Schmidhuber把这个闭环做进了AI:系统用编码器压缩画面,用循环网络预测动作后果,让智能体在"梦中"训练——训练完搬回真实赛车游戏,跑出了明显超越此前最好成绩的分数。它在想象里学会了开车。
但那些都还是小规模实验。真正的转折在2025年:DeepMind发布Genie 3——首个跑到24帧每秒、720p分辨率、持续数分钟的实时交互世界模型。它做到了"推摇杆画面就变",不是一段死的视频,而是一个活的、可交互的世界。但Genie 3也坦承:动作空间有限,多智能体交互搞不定,超过分钟级就开始漂移。
那么问题来了:到底是什么在阻止这些模型"活"得更久?
从几百步到三步:扩散模型怎么把自己"蒸馏"到一次眨眼的时间
要理解漂移,得先理解速度是怎么来的——因为速度本身恰恰是漂移的根。
扩散模型的核心操作可以这样理解:把一张清晰照片泡进一杯墨水里,墨水逐渐扩散,直到整张照片变成均匀的灰色噪声。扩散模型学会的,就是"反向扩散"——从噪声里一步步把墨水收回来,恢复出照片。每一步去掉一点噪声,数百步之后,画面从混沌中浮现。
画面质量极高,代价是慢。每一步都是完整的神经网络前向计算——想象擦白板上的字,正常人拿起板擦一下抹掉;扩散模型是用指尖一点一点蹭,每次只蹭掉微不足道的一层。
2022年,Google的Salimans和Ho想出一个取巧的办法:让"学生"模型模仿"老师",但步数减半——老师8步完成的,学生学用4步直接跳到同样结果。然后学生再当老师,再减半——"渐进蒸馏"就此诞生。从8192步一路蒸馏到4步,画质只损失了一丁点。
2023年,一场更大的突破来了:研究者发现根本不需要"一步步蒸馏"——可以直接训练模型学会"从噪声的任意一点跳到终点"。数学上,扩散过程存在一个方程,精确定义了从噪声恢复到清晰图像的唯一路径。一致性模型学到的就是这个"终点函数":无论你从旅途的哪一站出发,模型都能一笔画完剩下的路。就像学认路不再需要记住"左转→直走→右转"——你直接记住了"这里到目的地的方向"。
到2026年,西湖大学实验室所基于的LynnReal-Omni模型做到了4次去噪,Flash版进一步压缩到3次。22帧540p跑完377毫秒。
但论文也坦承了一个事实:这些数字建立在热启动、短视频、单张英伟达H100旗舰计算卡的前提下。把分辨率提到768p、时长拉到15秒——需要38.7秒,比实时慢了近三倍。
更反直觉的是,蒸馏把"去噪步数"这个瓶颈干掉了,瓶颈只是转移了:现在最耗时的不再是去噪,而是解码器——把模型内部的紧凑数值编码(潜空间表示)翻译回人眼可看的像素。LynnReal-Omni不得不专门把解码器从36层砍到26层。
我们成功地把扩散从"几百次指尖轻蹭"变成了"三次大板擦",但迎面撞上的问题更根本:模型不是不知道"怎么画得快",是不知道"画什么才对"。
生成五秒后开始"失忆":漂移的本质不是算力不够,是模型根本没学会物理
跑得再快,自回归模型每多生成一帧,就多一点点偏差。这一点点偏差在下一帧变成"事实",偏差叠偏差,五秒之后,你看到的已经不是一个连贯的世界了。
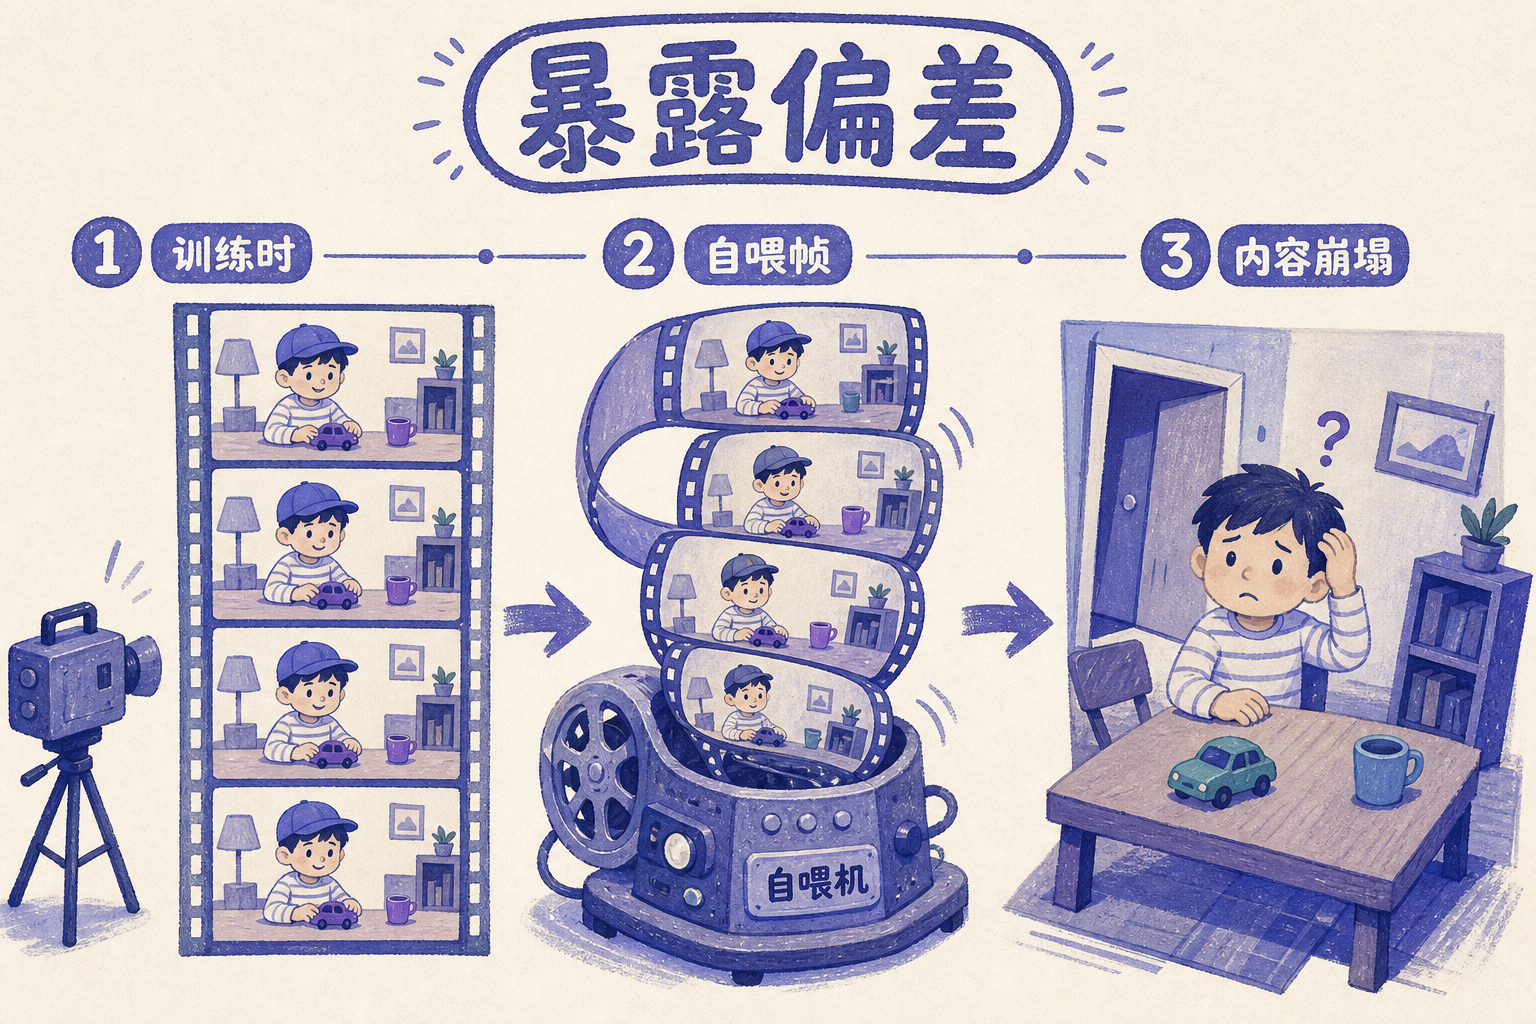
这叫"暴露偏差"——训练时,模型看到的全是干净的真实帧;推理时,它被迫用自己的"猜测帧"当条件。训练和推理的分布对不上,误差像滚雪球。Google的研究人员实测发现,无引导的长视频生成中,角色帽子会凭空消失、房间布局悄悄移位、道具颜色渐变到另一个色系。他们管这叫"内容崩塌"——不是画面变糊了,是世界逻辑崩了。
但2026年一项更令人不安的发现把问题推向了更深处。研究者给一个叫DreamerV3的世界模型做了个"摩擦力测试":把模拟环境里的摩擦力系数逐步调大,看模型的想象轨迹怎么变。真实物理中,摩擦力越大物体停得越快——响应斜率为-0.22。而DreamerV3的想象里,这个斜率只有-0.009。差了两个数量级。
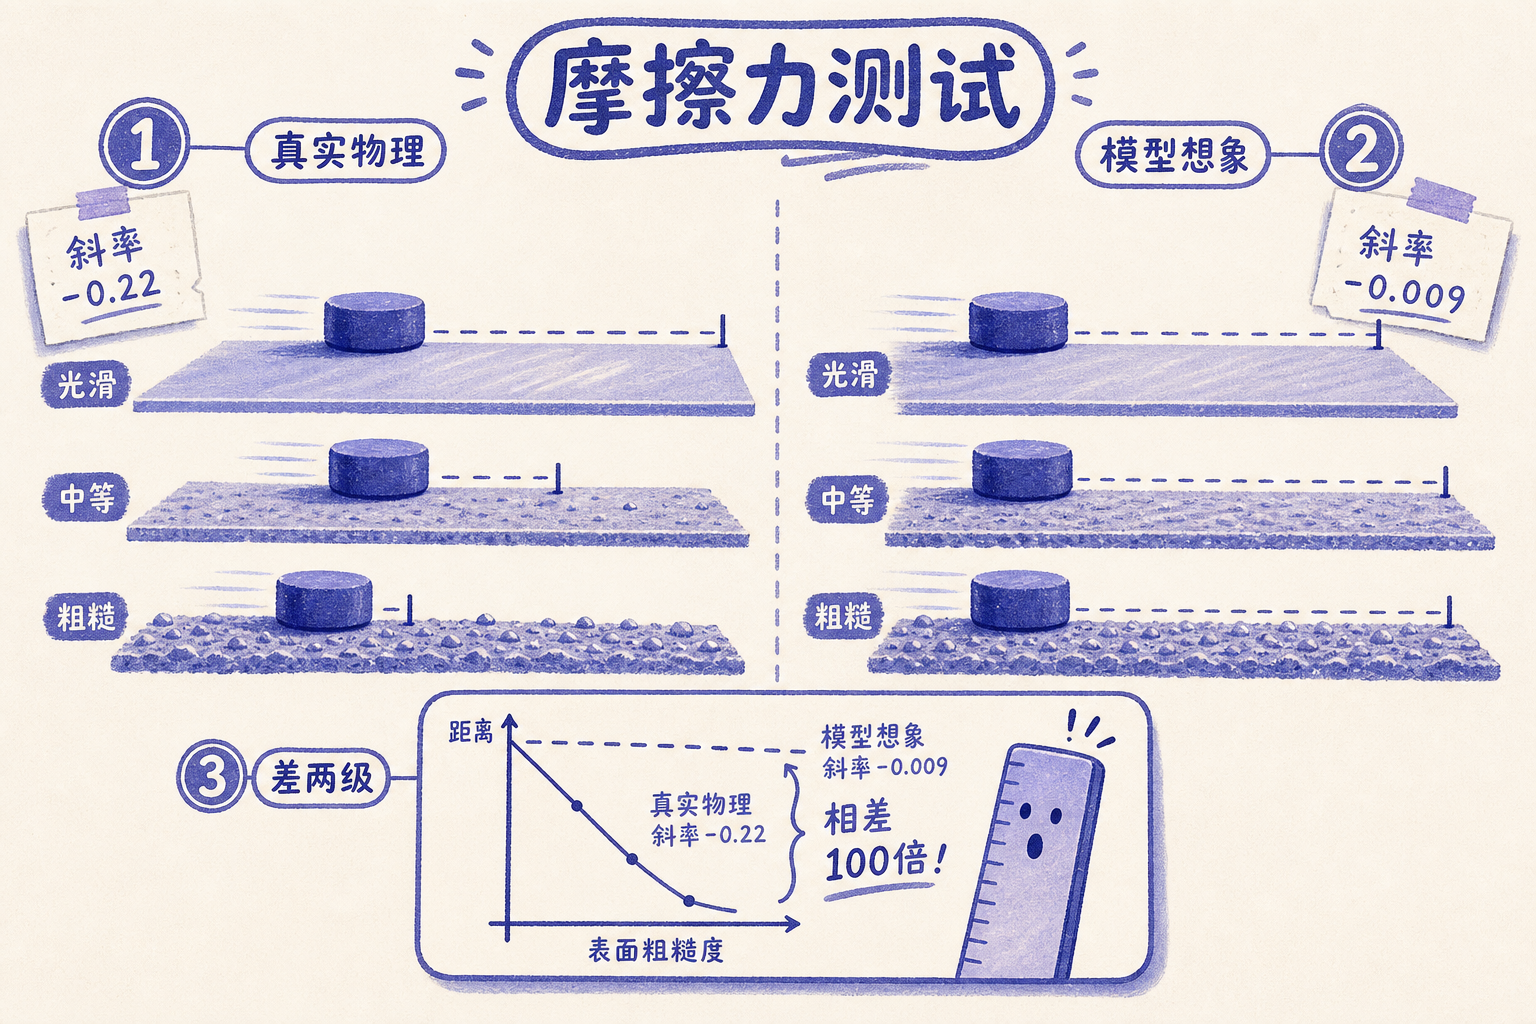
翻译成人话:模型根本没学会物理。它学会的是"运动学外推"——看画面里什么东西在动、往哪个方向、速度多快,然后假设它们继续那样动。至于"为什么动""碰到东西会不会停""摩擦力变大会怎样",它不关心、也不会。它背下了舞蹈动作,但不知道脚底下是冰、是沙、还是水泥地。
而这恰恰不是AI独有的问题。气候模型面临完全一样的困境:任何长期运行的模拟,都会慢慢偏离观测值、收敛到模型自己偏好的稳定状态(气候学家管这叫"气候漂移"),几十年来靠控制实验订正,但订正本身也带着不确定性。甚至游戏引擎也不例外——《坎巴拉太空计划》只在飞船2.4公里内做高精度物理,远处的天体直接切到解析轨道方程。
每个做长期仿真的人都得面对同一个魔鬼:误差是累积的,而真实世界的复杂度没有上限。
谁在等世界模型?——机器人训练从三个月缩到36小时,而最激进的赌注是让AI设计AI
理解了"快"和"懂"之间的鸿沟,才能看清这个赛道为什么急速升温。
2025年7月,英伟达用Cosmos世界模型为人形机器人生成合成训练数据。一道清晰的数字对比:原来靠人工采集需要近三个月的轨迹数据,世界模型36小时就吐出来了——把训练时间压缩到了原来的六十分之一,质量足以支撑真实操作任务。同一年,Wayve的自动驾驶世界模型GAIA-3能生成"反事实场景",已覆盖多国路况,正在替代部分新车安全评鉴协会(NCAP)的实车碰撞测试。仿真数字孪生市场更被预计十年内翻十倍。
但这一切都卡在同一个瓶颈:模型能维持多久的一致性。Genie 3撑几分钟,GAIA-3能推几段反事实轨迹,Cosmos能生成一段训练数据——但没有一个模型能像物理引擎一样跑到"时间不限、状态不漂、动作闭环"。
西湖大学的AI4AI计划赌的是另一条路:既然人类手工设计蒸馏策略、稀疏路由、键值缓存(KVCache,一种让模型在生成中记住之前内容的记忆机制)、混合精度量化(用低精度数值替代高精度计算来省算力)已经逼近极限,不如让AI自己来。不是让人类研究员调参——是让AI作为"算法设计师",自动探索少步生成路径、动态分配计算预算、在线选择推理深度。就像编译器从手工汇编进化到自动优化:你不再自己写每一条指令,而是告诉编译器"要这段代码跑得最快",它帮你找路。
如果这条路走通,五年后的世界模型可能长这样:在消费级显卡上持续运行——只在物体真正移动的区域更新计算,没变化的地方复用缓存;碰到物理接触自动切高精度模式,平稳滑行降到稀疏计算。更关键的是,漂移时它能自己发现、自己纠正——而不是等人写论文来修。
目前没人做到这一点。但第一次,速度不再是最大的瓶颈。瓶颈是结构。
从"生成画面"到"理解世界",差的从来不是更快地画画,是另一种问题定义。西湖大学把赌注押在了AI自己身上:当人类研究员的设计空间逼近天花板,让AI来寻找下一个维度。这不是"让AI变快",是让AI学会怎么让自己变快。从工具,到工具制造者——这一步,才刚开始。