Claude(Anthropic公司的AI模型)设计出1320个全新的蛋白质结合子——专门设计来抓住特定靶标蛋白的人工分子,自然界中从未存在过。两家独立实验室接单:合成这些蛋白、让细胞表达出来、测试它们能不能结合目标。结果:354个成功结合,966个失败。
然后,那966个失败品没有被扔进垃圾桶。
它们被全部开源,喂回了模型。因为在这个新世界里,失败不是废料——它是训练数据。AI药物发现正在把制药业最重要的一条假设翻转过来:AI不是来减少实验的,它是来制造实验的。
AI不是来裁员的——它来给湿实验室批发订单了
1865年,英国经济学家杰文斯写下了一句让后世争论了160年的话:"认为燃料的经济使用等同于消耗的减少,完全是观念混乱。事实恰恰相反。"他的论据很直白:瓦特改良蒸汽机后,单位功率煤耗骤降,但英国煤炭总消费量在随后几十年间从约300万吨飙升至约9000万吨——翻了30倍。蒸汽机变得太便宜了,于是它从矿井抽水扩散到纺织、运输、每一个工业部门。效率提升没有减少资源消耗,它只是打开了需求的水闸。
2026年的AI制药,正在上演同一出戏。
2020到2021年那一轮AI药物发现热潮的逻辑很清楚:用计算替代低价值的湿实验室筛选——湿实验室就是需要动手操作细胞、试剂和仪器的物理实验室,每一步都烧钱。AI被当作搜索效率工具,目标是少合成、少测试、更快锁定候选药物。这条逻辑在2022年利率急升后碎了一地——明星分子DSP-1181从发现到I期临床仅用不到12个月,随后因未达到评估标准被放弃。更快的发现,不等于更好的生物学。
2026年的逻辑截然相反:用AI大幅扩展假设空间,再用湿实验室来验证。核心经济学很简单——假设生成趋近于零成本。
传统药物发现中,一个博士团队可能要花几个月才能锁定几个值得推进的候选物。能进入昂贵验证流程的,只有最高置信度的那几个。AI改变了这个等式:Claude可以在一个下午吐出上千个蛋白设计,每个几乎不产生边际成本。"上场机会"暴增,瓶颈从设计端转移到了生物验证端。这不是"AI替代实验"——而是AI创造的海量候选物,正在把湿实验室冲成新的瓶颈。
就像瓦特的蒸汽机没有让英国少烧煤,反而让煤成了19世纪最紧俏的资源。
失败不再是废料——它是下一轮模型的燃料
但如果你以为这只是一次需求端的井喷,就漏掉了更深的逻辑。传统药物发现只问一个问题:"候选X有效吗?"AI药物发现还追问第二个问题:"这个实验能教给模型什么?"
回到Claude那1320个蛋白结合子。354个成功了——命中率约27%,远高于行业典型水平的10%-15%。Claude还在一个此前多支团队颗粒无收的靶标上打出了12个结合子,其中最强的结合亲和力达到3.9纳摩尔(数值越低意味着结合越紧),比此前人类设计竞赛冠军的45纳摩尔强出一个数量级。
但真正值得盯住的,是另外那966个。实验承接方Adaptyv已经把话说得很清楚:这次是"开环"——AI设计了一轮,实验室测了一轮,信息还没回流。下一步是"关闭环路":AI代理收到实验数据后,从成败中学习,自主选择下一批设计。"什么不表达、什么不结合、什么亲和力差——这些都是负向标签。"失败数据不是被丢弃,而是被编码成模型调整参数的依据,喂进下一轮训练。
这就是新范式的引擎:AI→实验→数据→更好的AI→更多实验。它在逻辑上更接近半导体的制程迭代——每一代芯片的缺陷数据反哺光刻参数优化——而不是传统药物的"设计-测试-放弃"线性流水线。
这条闭环正在催生一种新角色:生物数据铸造厂。DNA合成商Twist Bioscience明确表示,其业务正转向"从AI设计序列中生成可直接输入模型的结构化实验数据"。GenScript的序列到数据工作流可以在4天内完成从数字序列到结合亲和力数据的全流程,其高管在电话会上直言:"我们交付的是数据,数据才是终点。"在部分工作流中,客户关心的已不是拿到物理蛋白本身,而是把结构化实验结果喂回模型。湿实验室正在从制造药物,转型为制造训练数据。
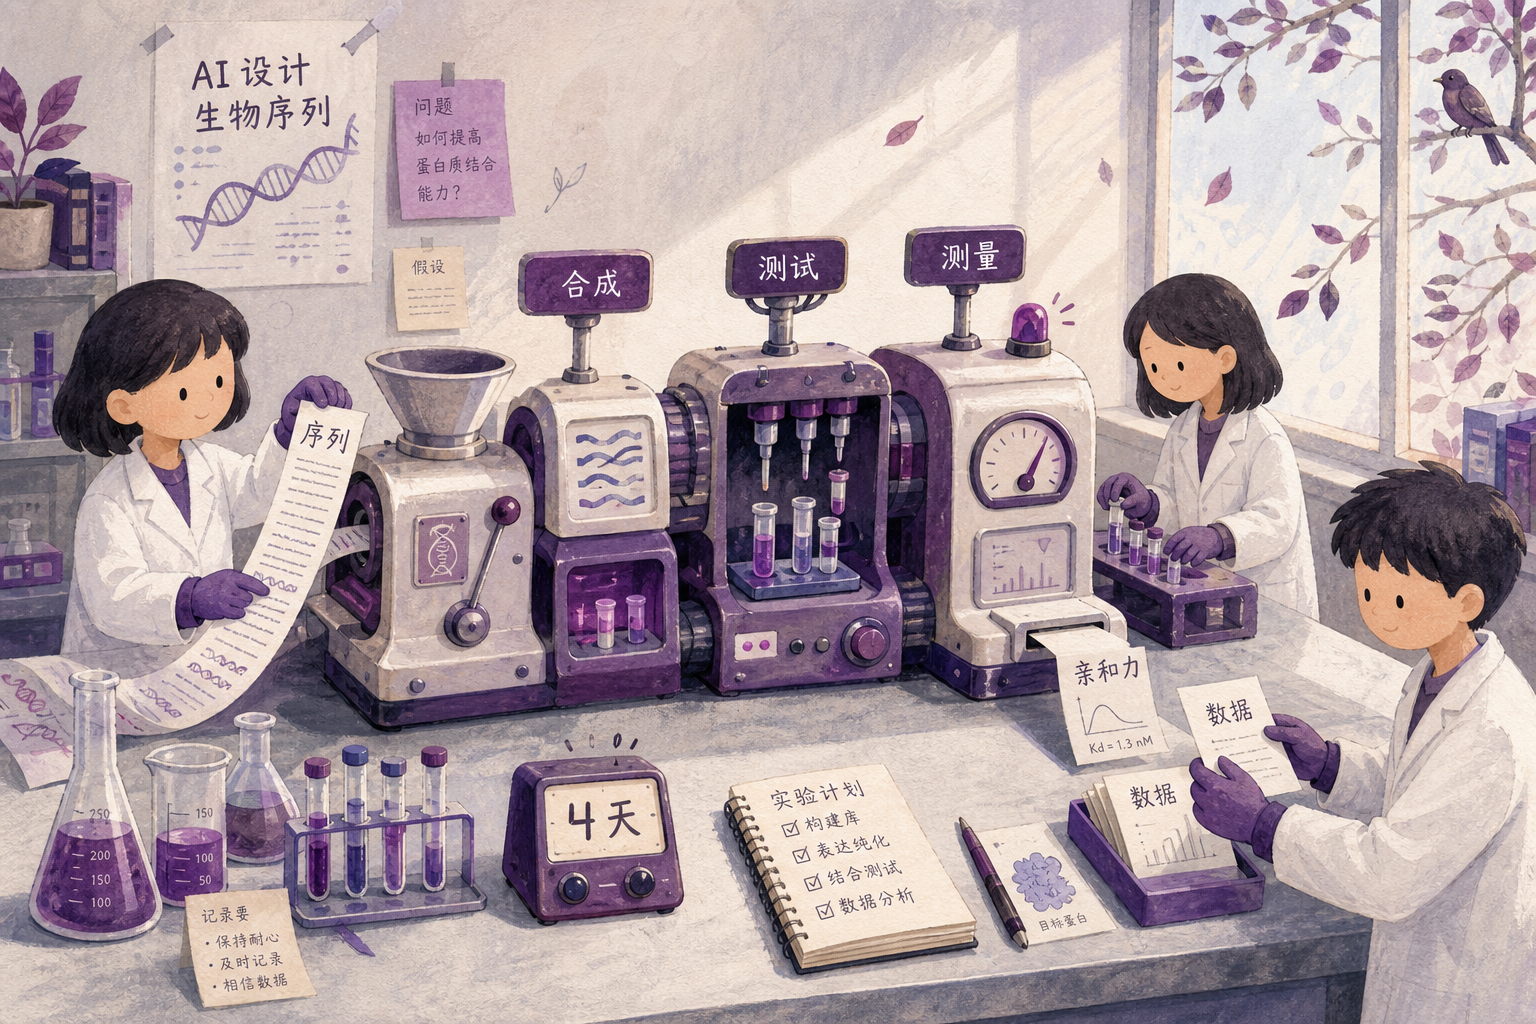
今年9月,Anthropic又亮出了另一种"闭环"的可能:Claude用21小时从20多万个逆转录酶(一种能把RNA信息抄回DNA的蛋白质工具)中筛选出一种此前从未被人描述过的酶系统——一种与基因编辑工具"基因剪刀"类似的重复序列阵列。无论这个发现最终能否成药,它的意义在于演示了同一条逻辑:AI提出假设,湿实验室去接——然后实验数据回流,AI再提下一个。
瓶颈沿着产业链往下爬——谁在接这波水?
如果AI制药的"洪水"逻辑成立,受益的就不只是模型公司。瓶颈会像接力棒一样沿着供应链往下传。
第一棒:DNA合成。Twist的AI药物发现订单正在经历连续三位数的年度增长——从2025财年约2500万美元,到2026财年约5000万,CFO已在电话会上明确确认2027财年将达约1亿美元。公司的DNA合成机从8台扩到12台。
第二棒:蛋白质生产与验证。GenScript的AI药物发现业务连续第三个半年同比翻倍,平台实际日产能已达约8000个设计,目标在2026年底前翻到约16000个。这个业务的毛利率比传统蛋白表达高出约20个百分点——因为客户买的不是蛋白,是数据。
第三棒:临床前测试。全球最大合同研究组织之一Charles River在2026年第二季度的book-to-bill比率(新增订单与已完成订单的比值)达到1.19——每完成100元订单就有119元新单涌入,为近四年最高。CEO在电话会上说了一句信息量极大的话:"使用AI平台进行药物发现的公司,目前运行的项目比典型生物技术公司更多。"翻译过来就是:AI公司正在以传统药企无法想象的速度制造候选物,而每一个候选物都需要安全评估。
再往下,连实验猴都感受到了压力。中国食蟹猴报价已回升至约18万元一只——回到了疫情期间的高点。浙商证券预测2026到2028年每年将短缺1.5万到2万只。单个生物药项目做毒理就需要12到100只猴——而AI正在用海量新候选物堵塞这条本就拥挤的管道。
对产业链上的这些公司来说,上游AI实验室每多设计一个蛋白、每多生成一个候选分子,下游就多一笔订单。无论AI设计出来的药最终能不能上市,DNA要先合成、蛋白要先生出来、安全评估要先跑一遍——这些实验需求已经真实发生了。
上一次AI制药狂欢是怎么死的——这次有什么不一样?
熟悉这个主题的人,本能地会想起2020到2021年那场AI制药狂欢和随后的崩盘。Exscientia的DSP-1181从发现到I期(小规模人体安全性测试)不到一年,然后悄无声息地死了。BenevolentAI通过欧洲最大SPAC(一种先上市募资再找收购目标的"空白支票"公司)上市估值15亿欧元,两年后市值蒸发90%。Recursion十年目标100个临床候选,实际只推进了4个。
当时的失败有两个明确原因:宏观环境急剧收紧,叠加"更快的发现不等于更好的临床生物学"被残酷证实。美国化学文摘社后来对首批AI设计药物做了结构分析,发现DSP-1181的分子形状与1967年获批的老药氟哌啶醇高度重叠——所谓"AI设计",很大程度上是对已知骨架的微调。
但2026年的背景有一个根本不同:那一轮周期发生在GPT出现之前。2020/21年的AI工具更像高级搜索引擎——在已知化学空间中搜索、排名、优化。2026年的工具——Claude、GPT-Rosalind——是可以自主设计实验方案、从零生成蛋白序列、在21小时内遍历20万个酶候选的推理引擎。不是说这些模型没有局限,而是它们和5年前的工具已经不是一个物种。最关键的区别是:那轮AI是"少做实验",这轮是"多做实验"——两轮周期的核心逻辑是相反的。
但最根本的风险没有消失。有数据显示AI发现药物的I期成功率约80%-90%,远高于行业历史平均——但到了II期临床(在几百名患者中验证实际疗效),成功率约40%,与历史均值持平,且样本量仍然有限。AI擅长设计"类药"分子,但一个分子能不能在活人体内真正起效,取决于它在体内如何被分解、会不会误伤不该碰的蛋白、会不会触发免疫系统的攻击——这些硅基模型至今无法可靠预测。行业里90%的临床候选药最终失败,主因是缺乏疗效和毒性,而不是"发现不够快"。
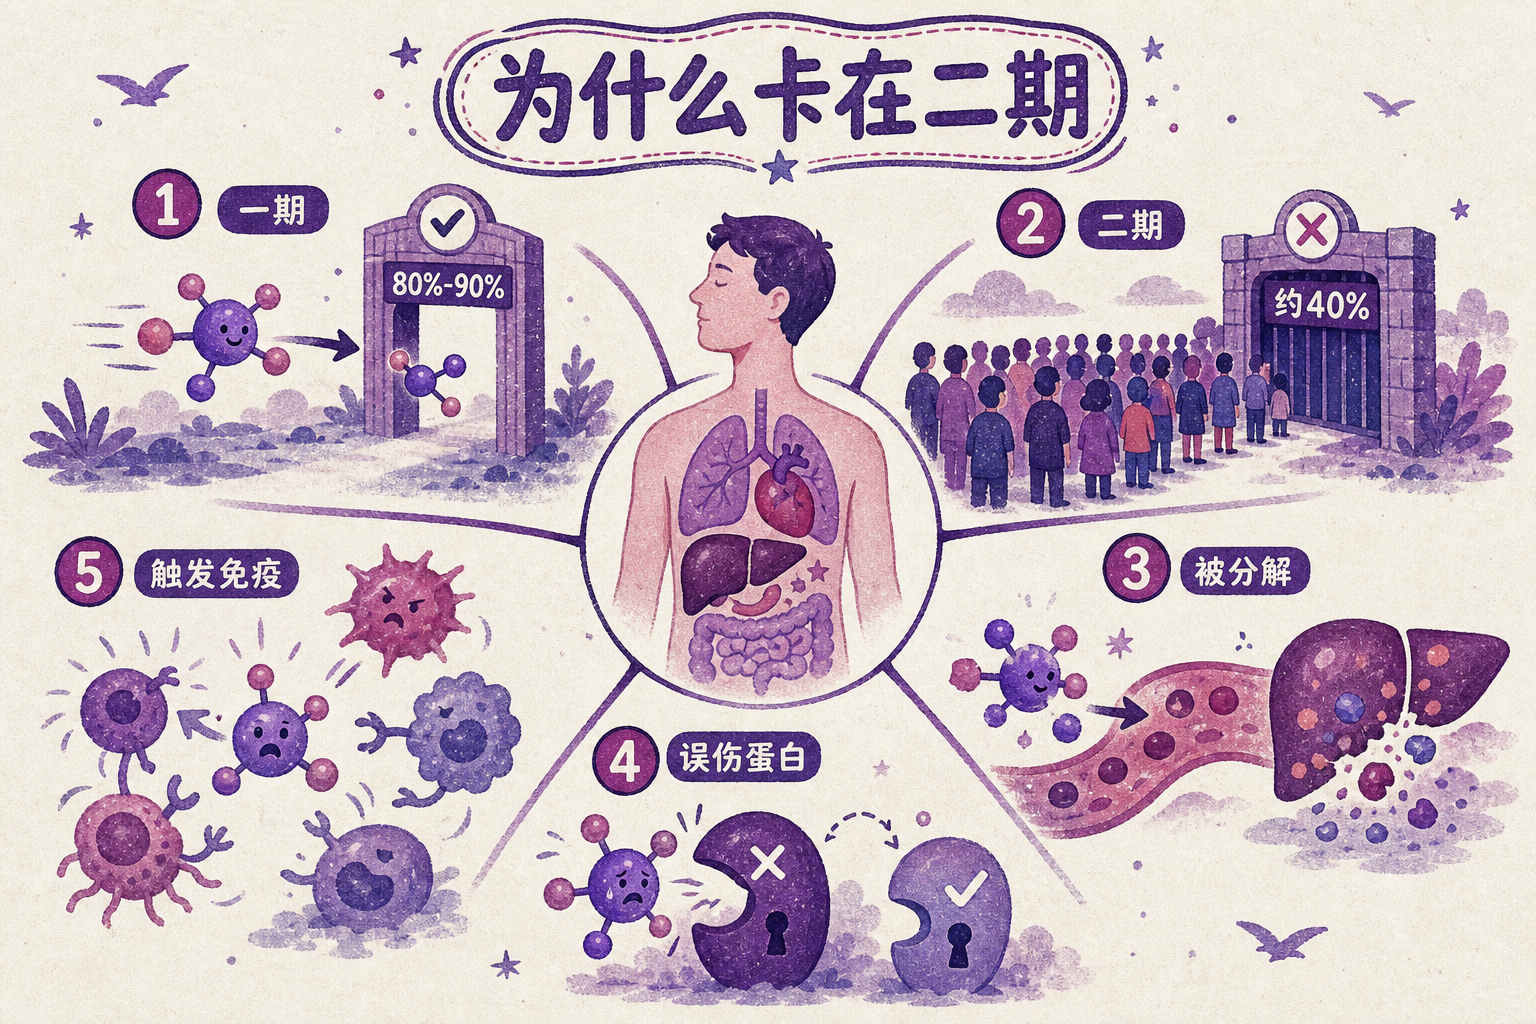
这正是这笔"瓶颈交易"最脆弱的地方:如果AI药物在I期表现亮眼,却在II/III期以正常失败率落败,整个投资逻辑将面临根本挑战。同构实验室(Isomorphic Labs,谷歌DeepMind旗下专注AI制药的姊妹公司)计划在2027年底前将AI设计药物推进人体临床试验——II期临床结果才是真正的裁判。如果它输了,AI就仍然只是一个更快的筛子,而不是一个真正的范式转换。
对正在这条产业链上的公司来说,从DNA合成到蛋白生产到临床前测试,未来两到三年的实验量增长几乎是确定的——无论最终哪个AI设计的分子能走到上市,实验本身已经做下去了。真正的悬念不在2026年,而在2028年之后:当第一批AI原生药物交出II期临床答卷,我们才会知道,这一次的洪水灌溉的是一片新大陆,还是一块已经淹过一次的盐碱地。过去治肥胖靠管住嘴,现在可以直接关掉脂肪的水龙头——但AI制药恰恰相反:水龙头拧开之后,真正的问题不是水量够不够,而是管道够不够粗。