你大概没见过这样的天气预报:每天都是"晴转多云,气温适中"。它永远不会错得太离谱——但也永远不会在台风登陆前把你叫醒。
这正是今天大多数AI预测模型的通病。时间序列预测、机器人操控——底层共享一个隐秘的诱惑:取平均。平均让误差变小,模型看起来更稳。但平均也会把台风眼抹成微风、把闪崩熨成涟漪、让机器人永远伸向杯子的"平均位置"——然后杯子偏移两厘米,整条流水线卡住。
今年人工智能领域最顶级的学术会议之一NeurIPS 2026,从30709篇投稿中录用了7900篇——大约每四篇投稿才有一篇被接收。其中来自天基综合信息系统全国重点实验室的三篇论文,分别从三个角度捅破了这层"平均幻觉"。它们指向同一个命题:AI要学会保留"尖锐",而不是把它磨平。
为什么"平均"是最危险的预测?
想象一张抹掉等高线的地形图——"平均海拔500米",是悬崖还是缓坡,你不会知道。
时间序列预测每天都在发生同样的事。电力公司预判明天的用电峰值,算法给出的却是一个平滑的午后——尖峰被熨平了。AI气象模型预报日常天气表现惊艳,一到台风、热浪,就系统性低估极端事件强度。
问题出在模型训练最核心的机制上:把预测值和真实值的差距平方后求平均。这套机制天然偏爱"安全"的预测——你预测了一个尖锐峰值但时间偏了一点,平方误差会狠狠惩罚你;你预测一条平滑均值线,误差反而不大。久而久之,模型学会了把多个可能的未来搅成一锅粥,端出一碗温度适中的糊糊。
DGF论文的原话一针见血:预测"跟上了真实未来的粗粒度趋势,却无法保留尖峰、振荡、转折点和状态转换——而这些才定义了什么是'合理的动态演化'。"
那怎么办?天基全重实验室的DGF方案给出了一个反直觉的答案:不要只预测一个未来,而是同时预测好几个。
具体来说,DGF显式建模多个可能的"模态"——比如电力负荷的"平稳模式"和"峰值模式"——分别给每种模态做预测。然后用一种叫狄利克雷分布的数学工具,来描述"当前到底是哪种模态"这件事本身的不确定性。直觉很简单:你掷一个不均匀的骰子,不知道每个面朝上的概率是多少——狄利克雷分布描述的正是"对这些概率的拿不准程度"。在DGF里,它相当于给模型装上一个模式切换开关:数据暗示即将进入峰值模式时,开关自动把概率拨过去,预测随之变尖锐;一切平稳时,开关拨回来。群组采样和层次化强化学习优化则确保这些模式不会彼此趋同——保持多样性本身成了训练目标。
气象学里早有类似的教训。欧洲中期天气预报中心运行集合预报几十年,早就发现集合均值会把风暴的精确位置和强度一起平均掉——所以气象台真正用的是概率预报:报的是"明天下雨概率",而不是"明天的平均降水量"。流行病的教训更扎心:新冠期间约10%的感染者贡献了80%以上的新感染——"平均传播率"低于1,疫情照样能靠少数超级传播事件持续燃烧。
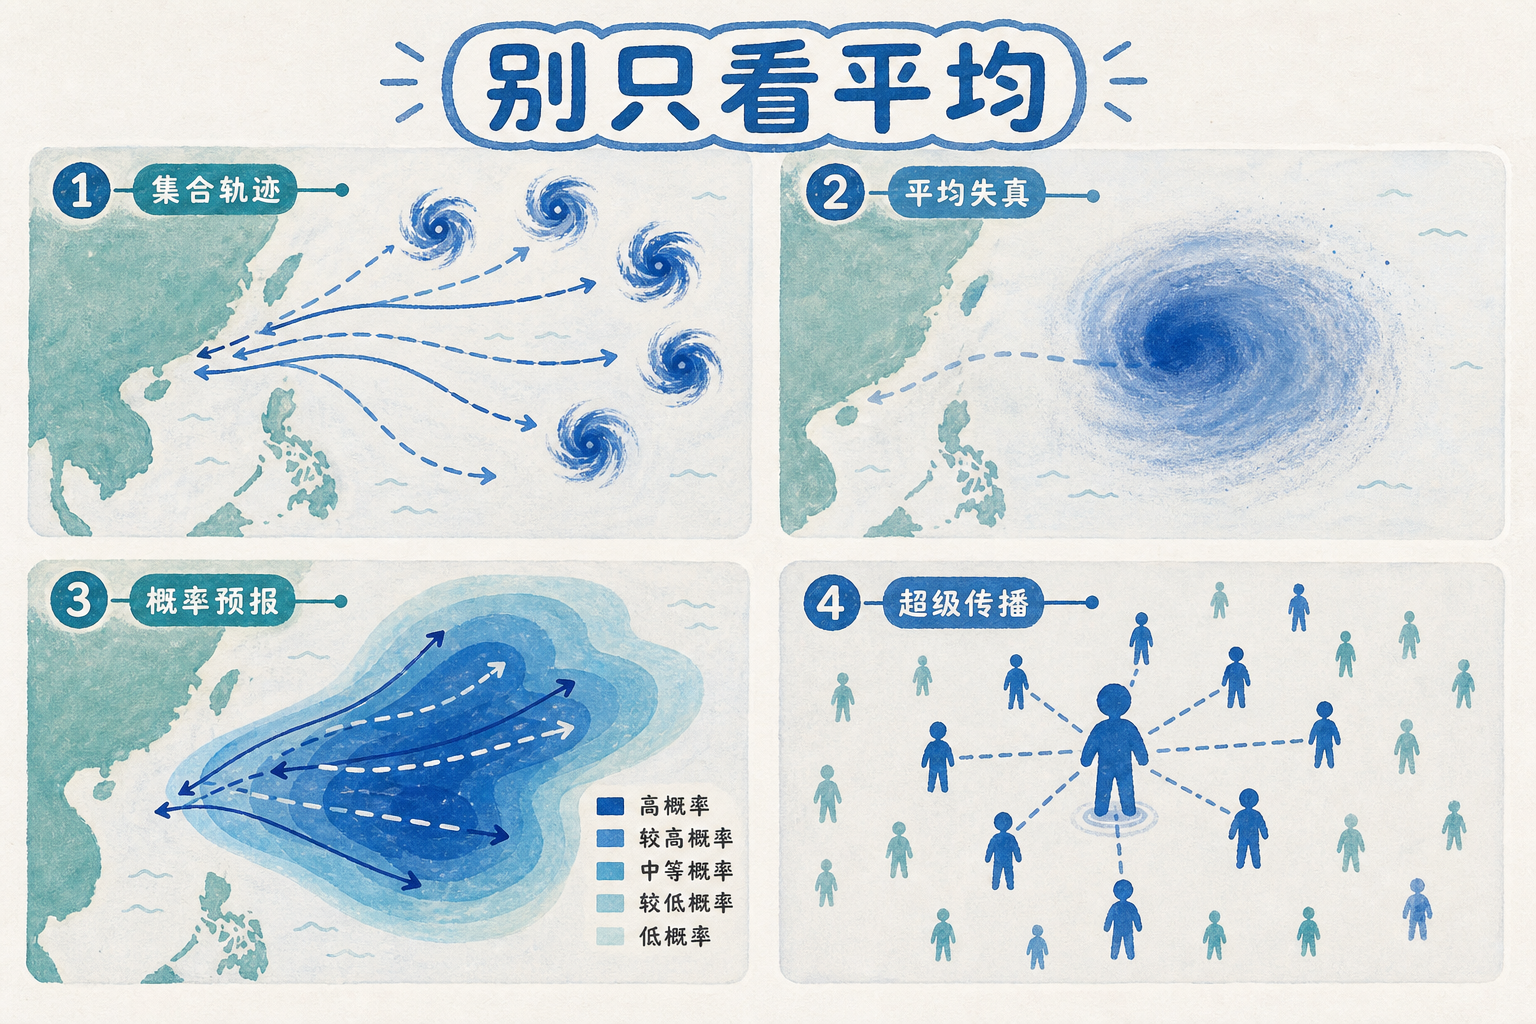
同一个规律反复出现:取平均毁掉的是尾部——而尾部往往是最值钱、最危险、最需要被看到的那部分。
机器人也有"关键一拐"
如果说时间序列预测里,平均毁掉的是未来的"形状",那么在机器人控制中,平均毁掉的是动作的"分量"。
过去几年,视觉-语言-动作模型(VLA)迅速崛起:让AI一边看画面、一边理解语言指令、一边输出机械臂的每一步动作。"把红盒子放到蓝盘子上"——模型看着摄像头,听懂这句话,自己规划出抓取、移动、放置的全套动作。Google的RT-2在2023年率先验证了这个范式,随后开源的OpenVLA用70亿参数就在表现上超过了550亿参数的闭源模型。到2024年底,Physical Intelligence的π0模型在叠衣服这类灵巧任务上超过前代两倍以上,在机器人操控标准测试平台LIBERO上逼近97%成功率。
但所有这些模型共享一个暗伤:它们是"模仿者"。训练数据来自人类专家演示——完美轨迹,从不犯错。模型照猫画虎地学习,却不知道哪些动作是"关键决策"、哪些只是"惯性执行"。
天基全重实验室的PAPO-VLA论文直指要害:机器人执行任务时,不同动作对成败的影响存在本质差异。大部分动作只是沿着既定方向往前走——微调角度、维持抓握力度、匀速移动——做好做差影响不大。但少数动作会改变整个执行方向:从"靠近物体"切换到"抓取"的那一刻,或从"抬起"切换到"移向目标"的转折点。论文把这些动作称为"规划动作"。
识别规划动作的方法很讲究:先看相邻两步之间的动作变化幅度——变化大,才可能是方向切换点;再用轨迹最终是否成功来加权。但光识别还不够——怎么判断一个规划动作到底有多重要?PAPO-VLA引入了两个互相牵制的标准:保留这个动作、扰动其他动作,任务还能不能成功?(在问"有它够不够")扰动这个动作、保留其他动作,任务会不会失败?(在问"没它行不行")一个动作只有"既帮得上忙、又不可或缺",才能拿到高权重。
这就像评估一场篮球比赛:大部分运球和传球是"维持性动作",重要但单拎出来决定不了胜负;第四节最后两分钟的抢断快攻则是"规划动作"——它不仅改变方向,而且直接决定结果。PAPO-VLA的逻辑是:训练时把火力集中在这些回合上。
然后,这些重要性权重被注入GRPO——一种让一组动作互相比拼、优胜者获得正向更新的强化学习方法——让模型对关键的"一拐"多学一点、对普通动作差不多就行。在LIBERO标准测试上,PAPO-VLA把成功率从纯模仿学习的约75%推到了96%;在长达500步以上的超长时序任务中,从约48%提到了64%。逐一移除某个组件的消融实验表明,拿掉因果充分性或必要性中的任何一个,性能都明显下降——两个标准互相制衡,缺一不可。
迷路了,怎么找回来?
PAPO-VLA解决了"哪些动作值得认真学"的问题,但还有一个更棘手的困境:机器人偏离轨迹之后怎么办?
传统VLA训练只见过专家的完美演示。一旦抓歪了、碰到了障碍物、初始位置和训练时不一样——模型就彻底懵了,它从来没见过"失败之后该怎么补救"。这其实是一个经典问题:模仿学习下,误差随轨迹长度呈指数级累积——开头偏了一丁点,走了几十步之后就偏出一大截。近期测试更触目惊心:在LIBERO-plus的扰动实验中,仅改变相机视角或机器人初始位置,VLA成功率就从95%暴跌到30%以下。更耐人寻味的是,语言指令的扰动几乎不影响表现——这些模型很可能根本没在认真"听"指令,只是在走视觉捷径。
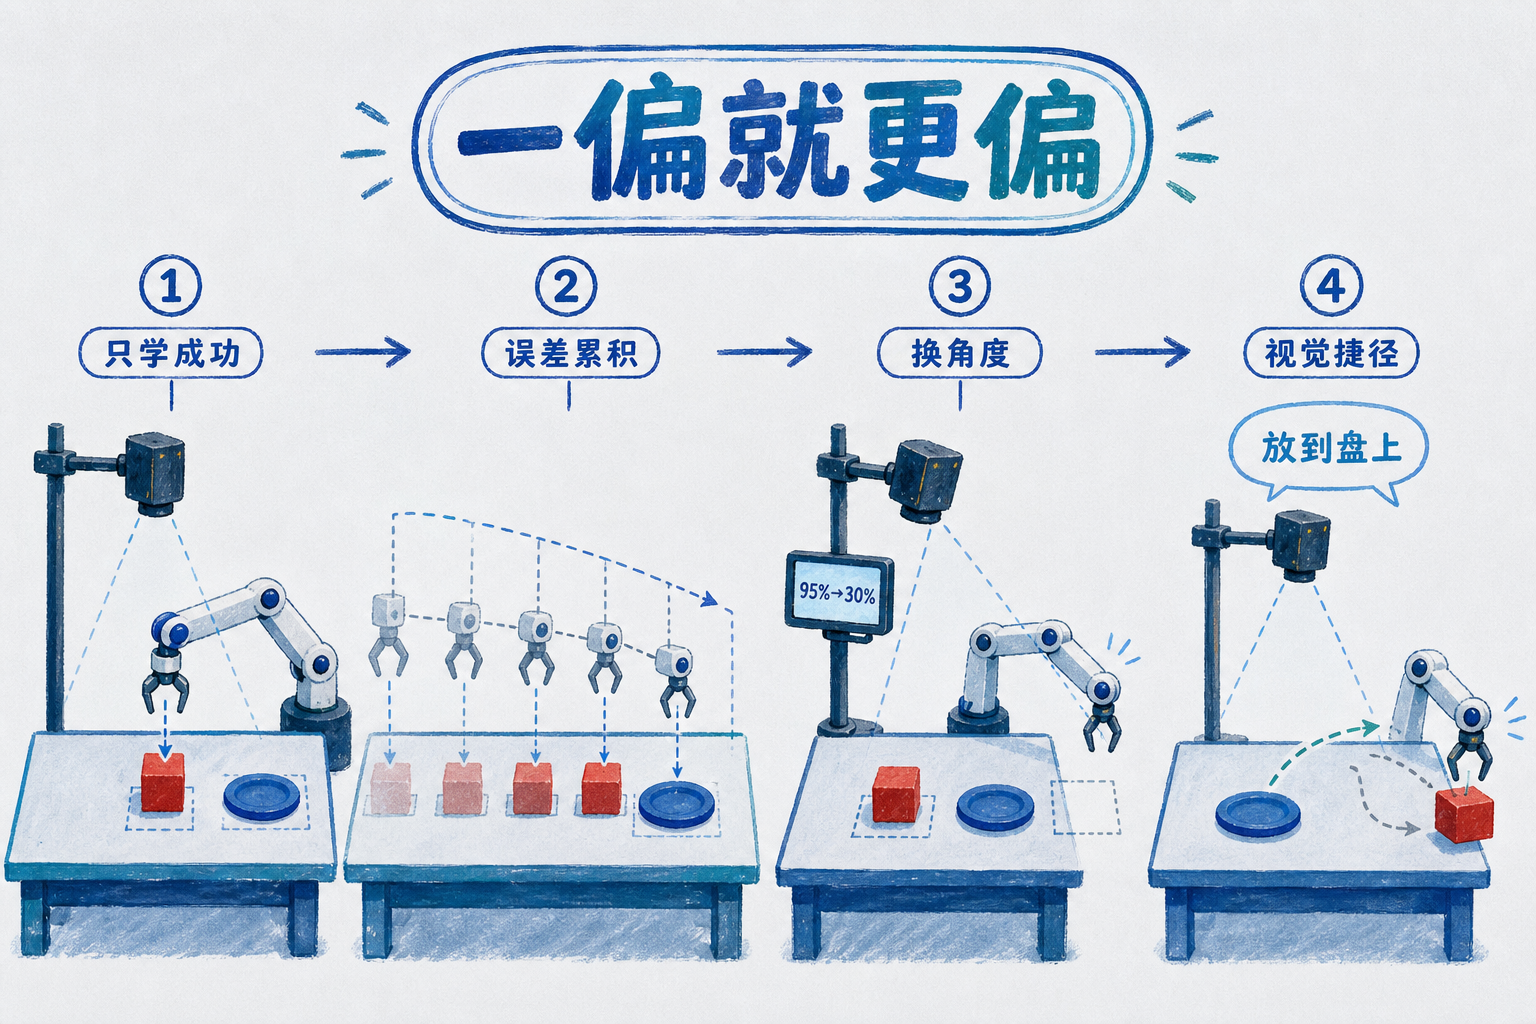
天基全重实验室的第三篇论文OGPO,正是冲着这个死穴来的。核心思路很优雅:把"模仿别人怎么走"改成"学习怎么到达目的地"。
具体分三步。第一步,目标重标记——一条原本"失败"的轨迹不直接丢弃,而是把轨迹终点标记为"中间目标":失败的经验不是垃圾,是换了目标的成功经验。第二步,构造过程奖励——在轨迹中间设置稠密的进度信号,让模型每走一步都知道自己离关键状态是更近还是更远,而不是只在任务完成时才收到一个"对/错"的反馈。第三步,优势加权策略优化——对走得好的一步多学一点,走得差的少学;同时保留一个"安全带",新学到的动作不能偏离原始模型太远,防止学了诡异但不可靠的捷径。
整套机制的关键优势是:**不需要让机器人在真实世界里反复试错。**在线交互极其昂贵——大规模训练所需的电力、损耗和人工监督成本极高。OGPO完全在离线数据上完成训练,在LIBERO和MetaWorld等标准基准上,长时序任务成功率和抗干扰鲁棒性都有显著提升。
从论文到产线,还差几步?
三篇论文指向同一个方向:让AI别再玩虚的。但实际问题来了——这些技术什么时候能走出实验室?
先看产业端。人形机器人正在以超出大多数人预期的速度进入真实场景。Figure的02型机器人已在宝马美国工厂跑了11个月:每班10小时,装载超9万个零件,参与生产3万多辆X3,放置成功率超99%。Agility Robotics的双足机器人Digit以"机器人即服务"模式为物流公司搬运了超10万个周转箱。国际机器人联合会统计,2025年全球人形机器人出货约7000台——中国厂商AgiBot一家就占了近四成份额。
但7000台是什么概念?放在全球工业机器人的庞大基数面前,人形机器人的占比微乎其微。而且这些部署大多是试点性质:特斯拉的Optimus在自家工厂里,用马斯克的原话说,"主要用来学习和采集数据,而不是做有生产力的工作"。还没有任何一家人形机器人公司实现规模化盈利。
这恰好倒映出VLA技术的核心瓶颈:训练环境里95%以上的成功率,换个相机角度就暴跌到30%以下。三篇NeurIPS论文各自的解法——DGF的多模态预测、PAPO-VLA的规划动作加权、OGPO的离线恢复学习——分别攻击了"鲁棒性"这个总问题的三个不同侧面。它们不是在各自的小领域里刷分,而是在合力补一张拼图。对正在学机器人学或强化学习的学生来说,这三篇论文本身就是一份路线图:概率建模的思维、因果推理的框架、离线策略优化的技巧——每一个方向都指向同一个更根本的追问:如何让AI在不确定的世界里,做出不模糊的决策。
天气预报不模糊,才救得了命。机器人不模糊,才进得了车间。答案从来不在"平均"里——它藏在被你平均掉的那些尖峰之中。