你有一间装了64张顶级GPU的机房,每一张都贵得让人心疼。但你跑起强化学习训练时盯着监控面板,看到的不是GPU在吞吐数据——90%的时间,它们在空等。等最慢的那条Agent轨迹跑完,等整个批次收齐,等训练端终于可以做一次梯度更新。
这不是某个实验室的个例。风投机构Amplify Partners调研多家顶级AI实验室后发现,同步RL集群里,高达90%的GPU时间被浪费在等待上。
RadixArk的Miles框架要解决的就是这件事。2026年9月,团队发布完整技术报告,用64张NVIDIA GB300显卡对7440亿参数的MoE模型(混合专家模型——每个Token只激活少数专家子网络,而非全部参数都参与计算)做了一次从头到尾的Agent强化学习——每一步中位时间263秒。这不是靠堆更多GPU,而是把RL循环里三个最要命的工程瓶颈,一个接一个拆开了。
为什么744B的模型一跑RL就卡死?GPU不是算不动,是等不起
强化学习训练大模型,说起来只有三步:让模型生成回答(Rollout),根据回答质量更新模型(Training),再把新参数推回推理端(Weight Update)。三步循环往复。
但一到Agent任务,事情立刻崩了。一个Agent可能调用几十次工具——查文档、跑代码、读文件——每条轨迹的长度差异巨大。有的30秒跑完,有的要跑三分钟。在同步模式下,最快完成的GPU只能干等最慢的那条。训练端也必须等整个批次收齐。
Miles的做法是把Rollout和Training彻底解耦。它引入一个有界数据缓冲区——想象餐厅后厨的成品台:厨师做好一道菜就往台上一放,不用等其他厨师收工;品控从台子上取菜试味,不用等着所有菜一起上。这道"成品台"就是Miles的异步调度核心:Rollout GPU把完成的轨迹往里丢,训练端从中独立取样做梯度更新。两边速度各自独立——谁也别等谁。
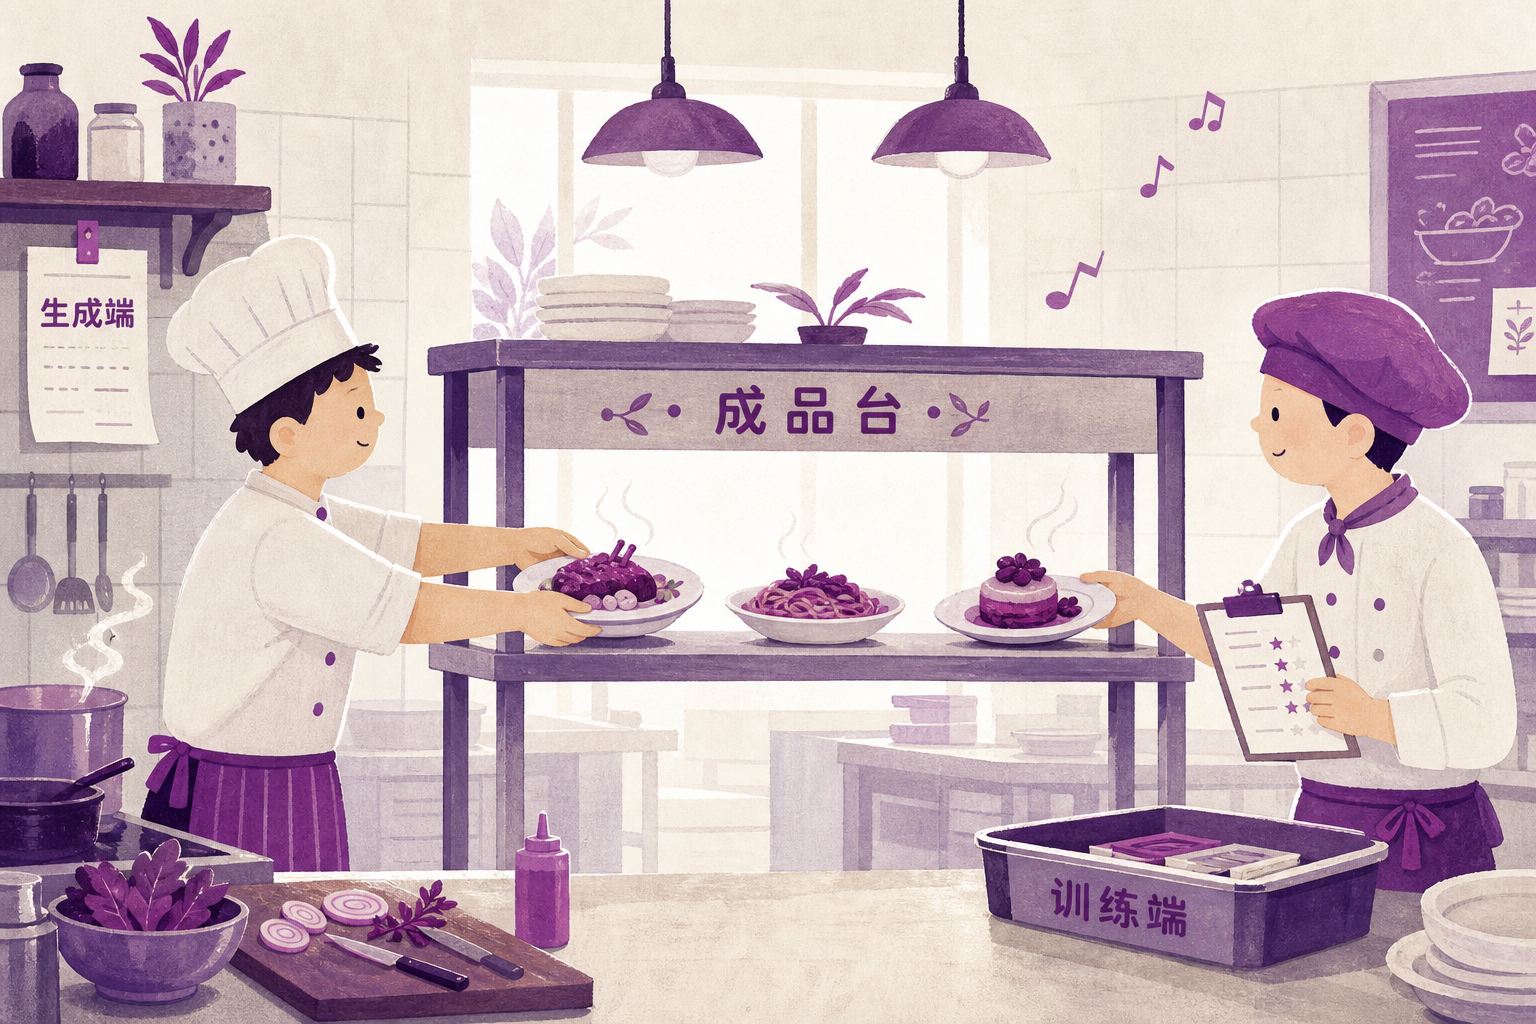
缓冲区的深度需要小心控制。太深,训练端拿到的轨迹是旧模型产生的,和当前模型的实际行为已有差距(这叫off-policy偏差);太浅,训练端可能饿死。Miles把深度做成可调参数。调度粒度也做到了逐样本级别——一条轨迹完成就立刻进缓冲区,不等凑齐一批。
还有一个让速度翻倍的设计:Prefix Cache。Agent多轮对话里,每一轮都继承前面的上下文——前面算过的键值缓存(模型对已处理上下文的理解快照)如果丢了,就得重算。Miles的做法是为同一个会话锁定路由——同一个Agent的后续轮次永远落在同一台推理引擎上,新会话才去找当前最闲的引擎。在GLM-5.2实验中,这套机制把缓存命中率维持在了96%。
那么问题来了:训练端虽然不等了,但它学的东西,真的是模型刚才生成的那条轨迹吗?
Token一模一样还不够——MoE模型有个更隐蔽的陷阱
你可能会想:Rollout端生成了回答,训练端拿同样的回答去算梯度,这有什么难的?
问题出在Token化。Agent的输出不是裸文本——它经过消息解析、工具调用、Chat Template渲染,再被重新切分成Token。而这个"重新切分"会静默破坏原始序列。根源在于BPE分词器(一种把文本切成最小Token单元的算法)的编解码不对称:一段文本可以对应多组不同的Token序列,但重新编码时,算法只能贪心地选一组——不一定是原始那组。
还有更隐蔽的破坏方式。某些模型的聊天模板会自动裁剪历史推理内容——Agent每调用一次工具就注入一条系统消息,之前的推理Token就被静默擦掉。有研究人员把这叫"精确比特前缀被破坏"。
Miles的TITO方案直接绕过了整个问题。它不再让Agent框架自己去重新拼Token,而是在推理端维护一个只追加不重写的Token缓冲区。原始生成的是什么Token ID、什么对数概率,训练端拿到的就是什么。就像餐厅里,品控不靠服务员口头转述"这道菜放了什么"——而是直接拿到厨师实际下料的原始记录。
到这里,Token一致性解决了。但如果你用的是MoE模型,还有一个更深的问题。
即使Token序列完全一致、模型权重完全一致,同一个Token在训练端和推理端仍可能走进不同的专家。根源是浮点运算的非结合性:不同框架的通信拓扑、算子融合方式、聚合顺序不同,导致微小的数值差异。MoE路由器对隐藏状态极其敏感——一个微小扰动就可以翻转top-K选择。在61层深度、58层使用了MoE的模型上,这种误差跨层累积放大。
R3论文给出的数字让人心头一紧:在Qwen3-30B-A3B上,94%的Token在至少一层MoE中选错了专家。 平均每个Token有大约6个路由器的选择不一致。训练-推理KL散度——衡量两个模型对同一输入预测分布差异的指标——达到1.535×10⁻³,是同等规模稠密模型的2.4倍。
这很像分布式数据库领域一个纠缠了几十年的老问题。Google Spanner用原子钟保证"外部一致性"——如果交易T1在T2之前完成,所有读取者都必须先看到T1再看到T2。Kafka用leader epoch号防止消费者从"僵尸leader"读到过期数据。它们的共同逻辑是:不靠重新计算来判断"应该是哪个版本",而是把写入时的真实状态直接保存下来。Miles的R3方案走的正是同一条路——它不重新计算每个Token应该进哪个专家,而是把推理时每个Token实际激活的专家编号记下来,训练时直接照单重放。
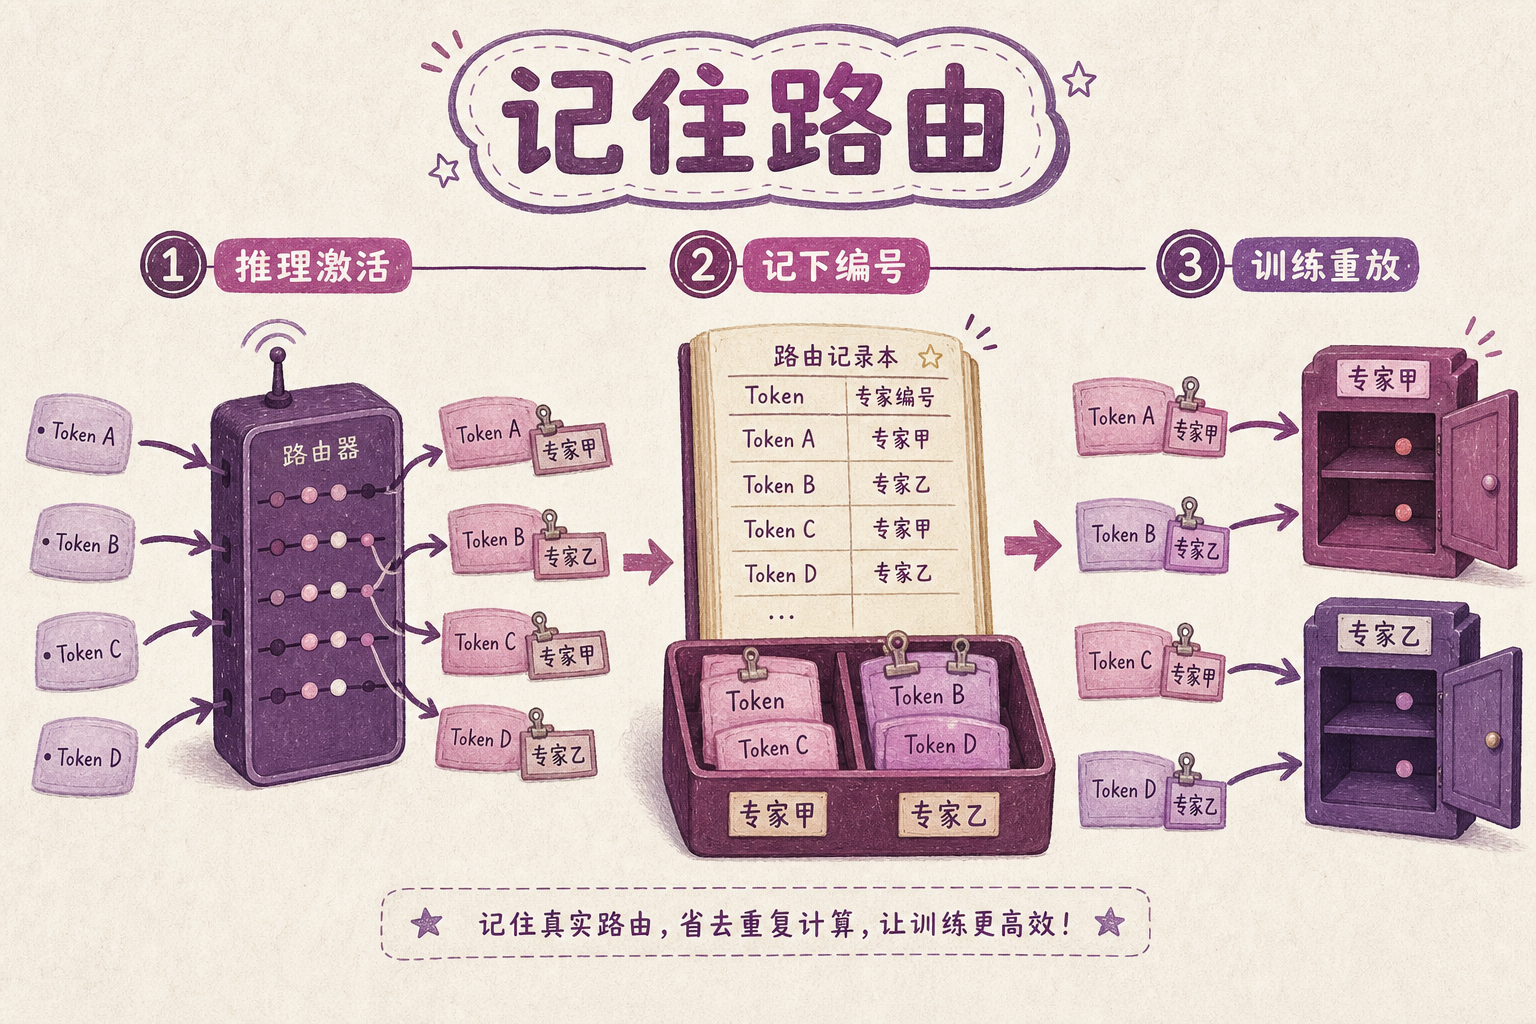
效果立竿见影:KL散度从1.535×10⁻³降到7.5×10⁻⁴——接近稠密模型水平。训练稳定性大幅提升:没有R3时,60步训练后10%的Token概率差超过两倍;有R3后,这个比例始终低于万分之一。
现在,Token一致了,路由一致了,异步也跑起来了。但每训练完一步,怎么把744B甚至1T参数的更新模型送回推理集群?
权重更新从53秒压到7秒——但单节点反而更慢
传统做法是NCCL Broadcast——把整个模型权重广播给所有推理节点。模型来到数百B参数时,这成了一场噩梦。Miles实测中,GLM-5 744B的一次完整Broadcast耗时58秒——每训练一步,推理端要等将近一分钟才能拿到新模型。Kimi K2 1T参数更夸张:53.28秒。
Miles的P2P方案做了一个概念翻转:不广播,而是点对点直传。在训练节点的CPU内存里建一个模型副本,通过RDMA——一种让一台机器直接读写另一台机器内存的网络技术——每个训练节点把自己负责的那片权重直接写入对应推理节点的内存。推理节点不用参与传输,只是被动地发现自己内存里多了新数据。
效果:Kimi K2 1T从53.28秒降到7.23秒,缩短86.4%。GLM-5 744B从58.30秒降到8.48秒,缩短85.5%。而且P2P的加速比随节点数增长——节点越多,广播浪费越严重,P2P优势越大。
但这里有一个教科书级的工程反转。
单节点环境下,P2P反而比Broadcast慢大约70%。原因很简单:把权重加载到CPU内存的固定开销——内存注册、张量格式转换——在节点数少的时候,超过了P2P省下的传输时间。Miles团队在论文里坦率标注了这个边界条件,并保留Broadcast作为默认方案。这不是P2P的失败——这是好工程的标志:知道方案的适用边界,比知道方案的优势更重要。
Miles还顺手解决了显存问题。全参数训练中,高精度主权重加上优化器追踪梯度方向的两个辅助变量,每个参数要占大约12字节——相当于每存一个参数,就要在边上堆好几倍的"优化器行李"。对于超大模型,Miles可以把这些行李按块流式搬到磁盘上。在Qwen3-30B-A3B上,卸载时间从24秒降到5.2秒,重载从8.9秒降到1.3秒。
后训练基础设施,正在成为AI公司的新护城河
Miles不是一个孤例。2026年,整个AI行业正在经历一个静默的重心转移:后训练计算量已经超过了预训练。
Cursor在Composer 1.5中披露,它的RL规模在一年内扩大了20倍,后训练计算量超过预训练。Anthropic的Opus 4.7在软件工程基准测试SWE-Bench Verified上从80.8%跳到87.6%——近7个百分点的提升不是靠更大的基座模型,而是靠更好的后训练。Salesforce同期发布了SFR-RL,宣称同样GPU可以训练5倍更大的模型。行业共识正在成形:2026年的护城河不是预训练数据量,而是后训练数据、领域化奖励模型,以及能支撑这套循环持续运转的RL计算基础设施。
在这个背景下,Miles的定位就很清楚了。它不是又一个"新的RL目标函数"——它不试图改进现有RL算法的数学公式。它做的事情更低层、更基础:让RL循环在千亿参数规模上持续运转,不出故障。Token要一致,MoE路由要一致,Rollout不能闲着,Trainer不能被显存卡住,数百B乃至1T参数的权重还得在几秒内送到推理集群。这些不是锦上添花的优化——哪一项没做好,整个训练就会崩。
但这也意味着Miles的门槛很高。64张GB300只是入门券——单节点场景下P2P反而更慢,小团队无法从中受益。开源RL框架的生态正在碎片化:veRL、OpenRLHF、TRL、Miles、SFR-RL各有侧重,没有统一标准。这些基础设施会进一步巩固算力寡头的优势,还是给小实验室一个追赶的抓手,目前仍无定论。
团队自己也刻意压低了调门。100步、单一任务分布上的Reward从0.438涨到0.556——但他们明确写道,这"无法排除不同Run之间的随机波动"。在一篇充斥着benchmark军备竞赛的行业里,这是一种难得的清醒。
真正值得关注的不是某个数字涨了几个点。是这套系统证明了一件事:Agent RL可以在744B参数的MoE模型上持续跑100步,每步不到五分钟,中间没有崩过。Token一致、路由一致、权重秒传——把这三件事同时做对,RL才从"能跑demo"变成了"能上产线"。而谁能把这条产线跑起来,谁就拿到了下一代AI Agent的入场券。