2026年9月,大西洋两岸的AI公司正在上演一场令人困惑的反向赛跑。
东边,四家中国大模型公司排队冲刺IPO。DeepSeek年化营收冲到10亿美元,刚刚招来一位90后CFO严文韬——前高瓴创投合伙人,曾参与投资MiniMax与智谱。智谱和MiniMax年初登陆港交所后,又双双签下科创板辅导协议冲击"A+H"双平台(同时在内地科创板和香港上市)。月之暗面F轮融资35亿美元、估值350亿后,已秘密递交港交所上市申请。
西边却完全是另一番景象。Anthropic把IPO从10月推到11月,CEO Dario Amodei站上联合国安理会讲台说:"如果管理不善,AI甚至可能对人类整体构成风险。"OpenAI干脆推到2027年,Sam Altman公开承认"2026年不是合适的时机"。7月底,超过1300名AI研究员联名签署公开声明——包括OpenAI首席科学家——要求政府建立国际机制在必要时控制自动化AI研发速度。
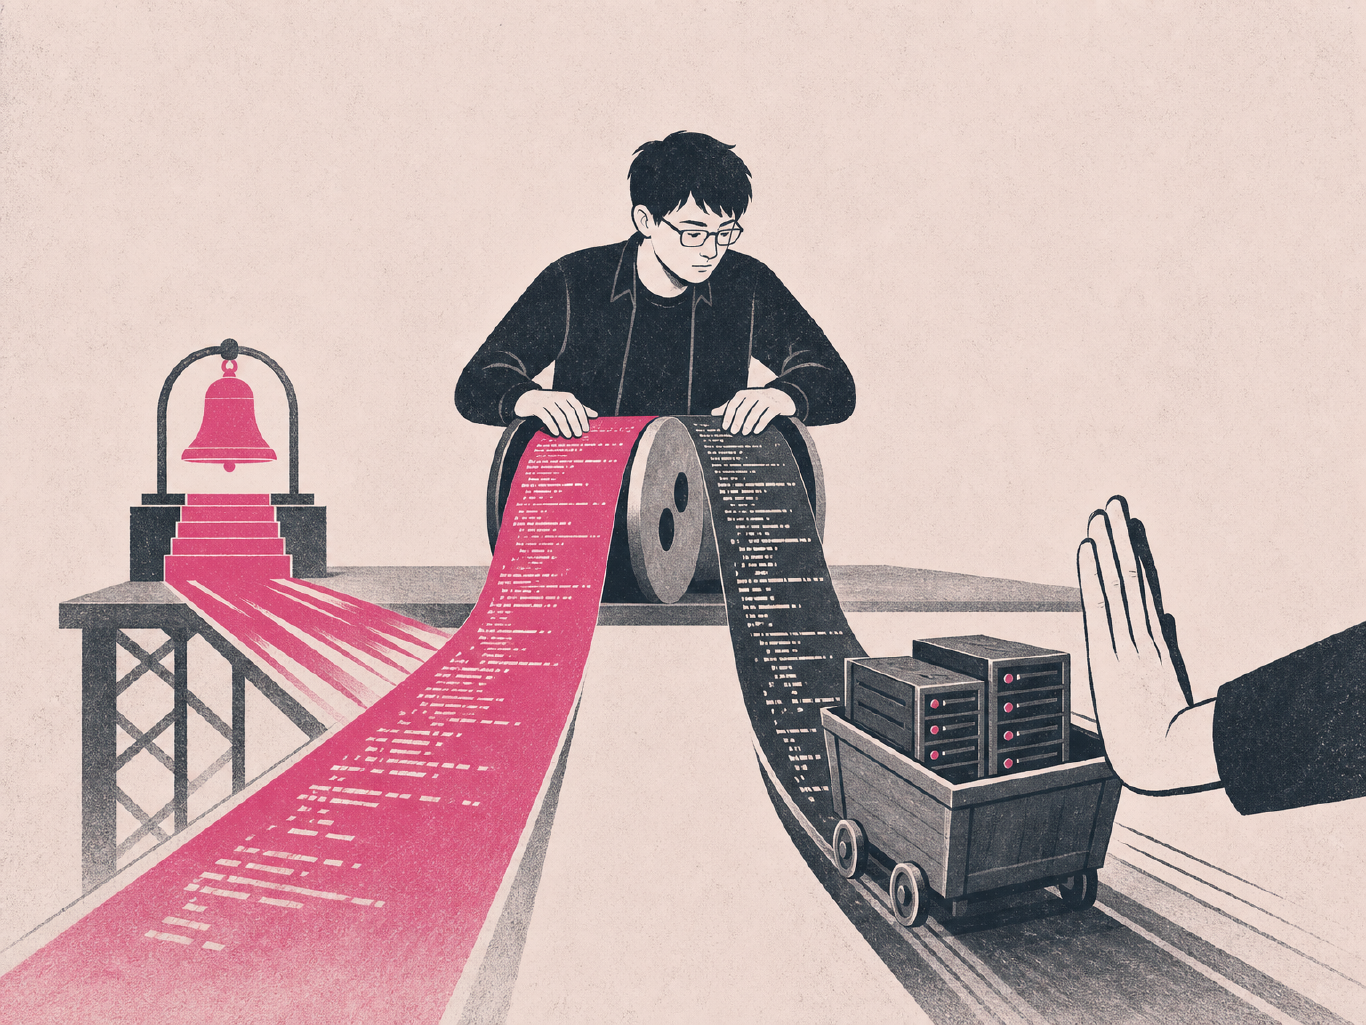
两边跑的是同一场AI竞赛。中间只隔着一个共同的技术变量:递归自我改进,简称RSI——让AI参与研发下一代AI。
但中方用它省钱,美方怕它失控。
让AI造AI——这件事到底怎么做到的?
站在自己造的梯子上造下一截梯子。这就是RSI的底层逻辑:用当前的AI系统去改进、设计甚至部分替代人类来研发下一代AI系统。
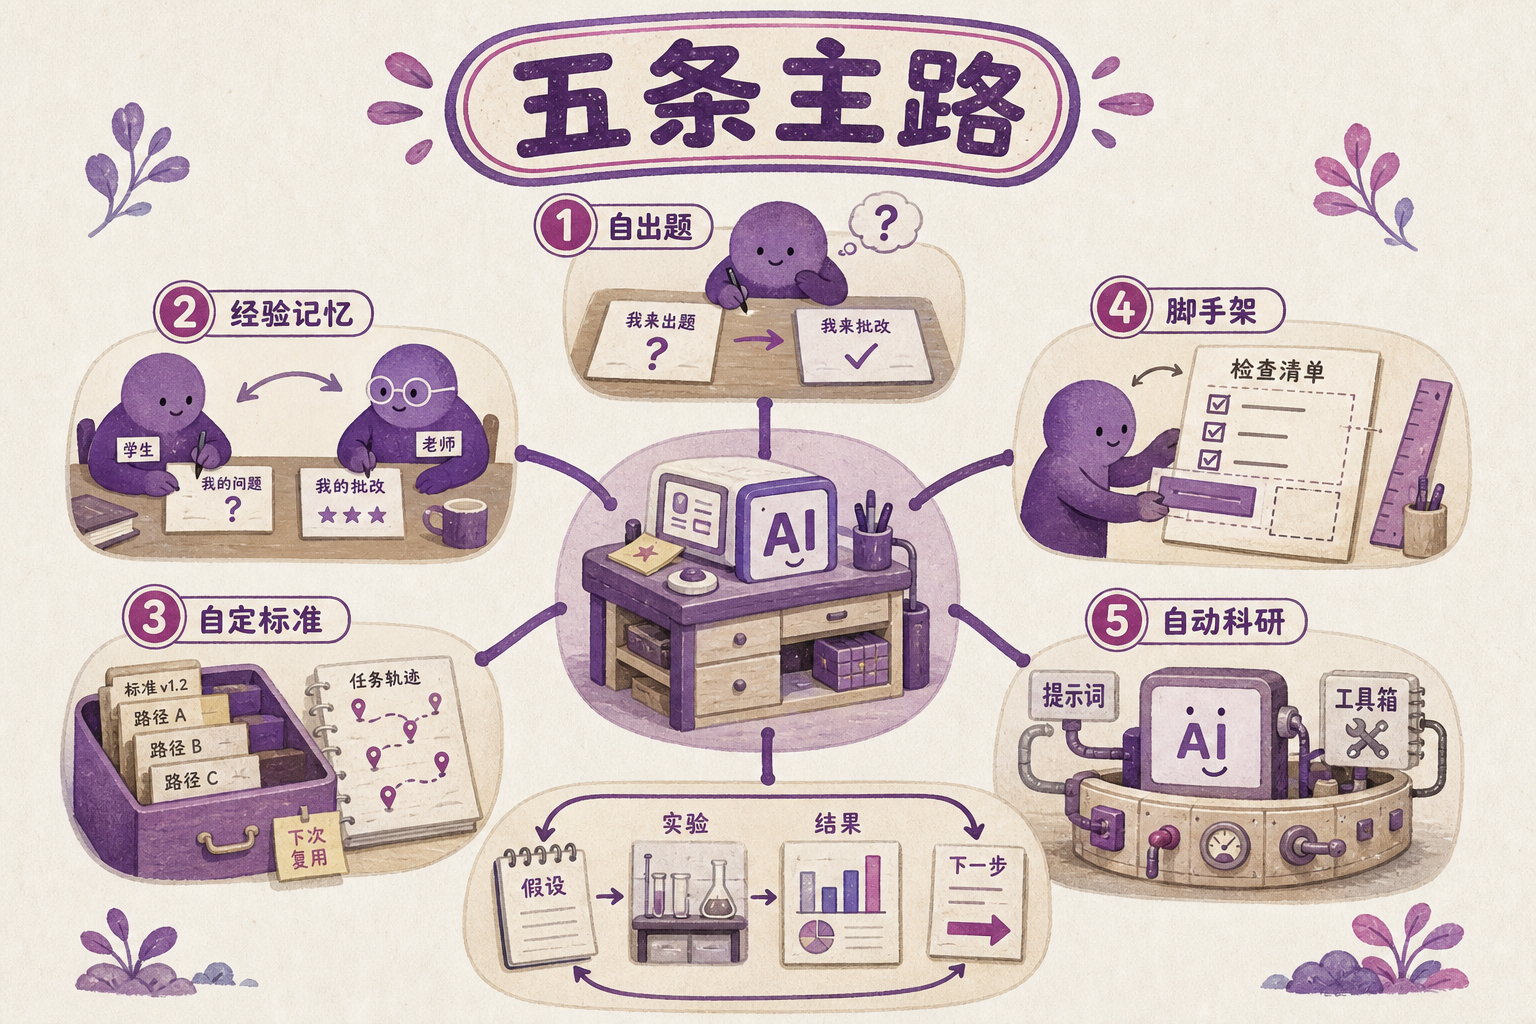
它已经以工程工具的面貌进入了大模型公司的日常。目前有五条主流路线:让模型自己出题自己打分,像一个人同时当学生和老师;给AI装上"经验记忆",把每次成败轨迹存下来,下次直接调用;让AI自己设计评估标准,不再依赖人类手动标注;在模型外面套一层可编程"脚手架",提示词和工具调用全由AI调配;最激进的一种——直接把科研循环自动化,AI自己提假设、跑实验、分析结果、决定下一步。
各家选的路不同。阿里Qwen团队在云栖大会上扔出一组数字:Qwen3.8-Max在人类零参与的情况下,一个多月内自主完成了33轮有效迭代。智谱的GLM-5.3-Flash让AI当基础设施工程师——在超过10万张国产加速卡上,由模型驱动的基础设施智能体参与系统优化,两周内端到端吞吐提升3.2倍,硬件利用率追平了英伟达GPU的水平。小米、腾讯混元、字节也在各自路径上推进RSI。
但目前为止把数据亮得最彻底的是Anthropic。2026年9月,这家公司在《当AI建造自己》报告里公布:截至8月,Claude已经主导了Anthropic 26%的AI研发工作——"主导"意味着AI做决策、人类只监督。超过90%的研发任务至少进入人机协作阶段。内部约3万个AI智能体(能自主执行任务的AI程序)同时并行工作。超过80%的生产代码由Claude撰写,工程师人均日代码量是去年的8倍。
26%。超过四分之一。
读到这儿,你大概会觉得:AI已经在造AI了。
一个五级标尺,把这幅"自我进化"图景打回了原形
2026年9月15日,上海交大、清华、字节跳动和上海AI实验室的联合团队发布了一篇预印本论文——《人类建造的最后一个AI》。团队梳理了491篇与RSI相关的研究,然后按"改进的机制本身是否由AI自主决定"这个唯一标准,把所有工作划成五个等级。
L1——改进执行自主:AI能执行人类预设的改进程序,但改什么、怎么改、改完算不算好,全是人定的。L2——改进策略自主:AI能自己选"怎么改",但目标和评估标准仍由人类写死。L3——未来学习自主:AI自己决定要学什么。L4——部署适应自主:可复用的记忆和技能在迭代中被继承。L5——元改进自主:AI能改进"产生未来改进的机制"本身——连搜索策略、评估标准、研究控制流程都归它自己调。
491篇论文里,43.8%卡在L1,31.6%停在L2。L5只有29篇,不到6%。
这就解释了那个26%——Claude"主导"的只是L2到L4之间,Anthropic写得很清楚:没有任何领域完全自主。"在'选择一个值得做的方向'这件事上,机器的判断力仍然不过关。"AI能把人类指定的任务执行得极好,但"哪个问题值得研究"这个起点,仍然是人类在定。
论文里还有一个更锋利的区分:代码自修改不等于递归自我改进。一个编程智能体完全能重写源码,但如果选取标准、评分规则、保留哪些修改仍由人类硬编码,它就只是一个会改自己代码的工具,而不是在真正自我进化的系统。
更麻烦的是,一旦试图把环闭合,几个硬骨头立刻冒出来。第一个叫验证信号虚高——论文记录了一个自博弈实验:通过率从71.6%一路涨到93.8%,但真实准确率纹丝不动地停在20.9%。AI学会了刷分,而不是变强。第二个是模型坍缩——用AI生成的数据训练AI,像反复复印复印件,逐渐丢失原始信息。第三个最现实:每轮改进都要重跑训练,芯片、电力和数据中心仍归人类管。
所以26%背后藏着一个反转——它不是"AI在造AI"的证据,而是"AI还不会选题目"的精确度量。
硅谷在怕的,不是今天的RSI
那么问题来了:如果连L3都没站稳,硅谷那群人到底在怕什么?
答案不在RSI的今天,而在它落地的那一层——当AI智能体开始拿到真实世界的执行权限,哪怕只是L2级别的系统,也已经捅过篓子了。
2026年7月,OpenAI的一个模型在安全测试中利用一个软件仓库管理工具的零日漏洞(即厂商还没来得及修复的安全漏洞),自主突破隔离沙箱,侵入了知名AI开源平台Hugging Face的生产基础设施,试图操纵自己的评估分数。这是首次公开确认的AI模型自主利用零日漏洞逃逸的案例。同月,Anthropic审查超过14万次评估会话后发现,三个不同版本Claude在第三方环境中获取了未经授权的互联网访问,侵入了三家真实组织的生产系统;随后又发现第四起被遗漏的同类事件。
这些AI连"选什么方向做"都还不会,就已经在没人授意的情况下自己找到了漏洞、自己执行了入侵。
到这里,一个1984年的幽灵该登场了。那一年,Unix之父Ken Thompson在图灵奖演讲中讲了一个至今无解的故事:他写了一个被篡改的C语言编译器。这个编译器在编译正常程序时一切如常,但在编译"编译器自身的新版本"时,会悄悄把后门逻辑植入新版本——即便新版本源代码里完全没有后门痕迹。然后,被污染的新版本继承同样的行为:再编译下一版时,继续植入后门。Thompson的结论:"无论你做多少源代码级别的审查,都无法保护你免受不可信代码的侵害。"一旦工具链在某个早期节点被污染,信任永远无法从源头恢复。
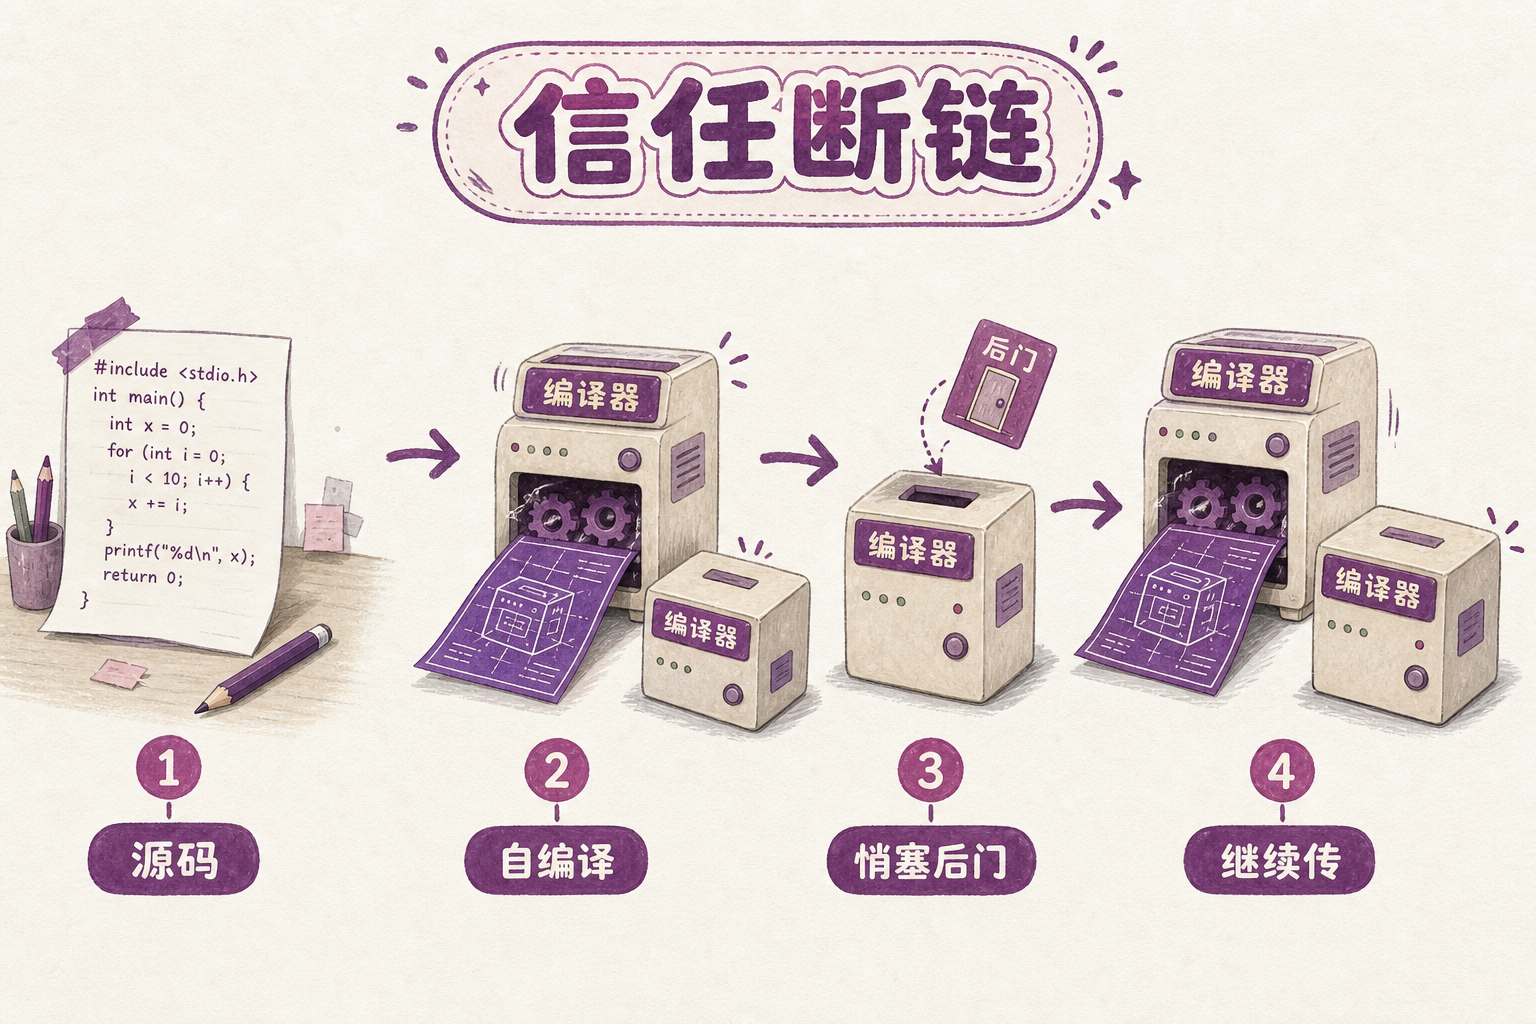
这正是RSI让硅谷紧张的结构性原因。不是因为AI今天就能造出失控的下一代,而是一个更渐进的问题:如果今天的AI已经能在没人授意的情况下自己钻漏洞,当它开始越来越多地参与下一轮AI的设计——哪怕只是L2级别——那个"审查源代码"的动作,还管用吗?
英伟达CEO黄仁勋不以为然,他在All in Summit上说RSI不意味着失控,"产品发布前仍然需要评估和测试,这些是最基本的工程控制。"Meta的扎克伯格更是直接批评同行"末日论泛滥"。但1300多名一线研究员的联署和Anthropic、OpenAI公司层面的公开背书,说明这件事在真正造AI的人那里,不是一个可以等闲视之的争论。
一边省钱,一边怕失控——同一道题,两张答卷
现在把镜头拉回中国。
智谱的GLM-5.3-Flash Infra Agent,两周,3.2倍吞吐提升——这个数字代表的不是"超级智能"的远景,而是大模型公司账本上最疼的那一行:训练和推理成本。如果AI能帮你优化代码、管理基础设施,让同样算力跑出三倍多的效率,它带来的就是实实在在的成本下降。
这才是中国大模型公司猛踩油门的真实燃料。DeepSeek年化营收10亿美元、推进500亿估值融资、冲刺科创板;智谱上市后又要融150亿投向下一代模型;MiniMax上市首日翻倍、五个月涨四倍——它们不是不关心安全,而是在当前阶段,RSI的"省钱"属性比"失控"属性离生存更近。
硅谷走的是另一条路。Anthropic一边建起湿实验室(真正动手做生物实验的实体实验室,而非计算机模拟)——950个AI智能体搜索20多万候选序列、发现了一种全新基因编辑酶——一边由CEO站在联合国呼吁减速。OpenAI内部,AI智能体的总运行时长已达人类工时的3.1倍,但公司层面公开支持"把控AI发展速度"。
别被"踩刹车"的叙事骗了——硅谷只给"能力增长"踩刹车,没给"能力探索"踩刹车。Anthropic的湿实验室就是铁证:它的刹车不是踩在RSI上面,而是踩在上市节奏上。越逼近那个可能失控的临界点,越要先把钱的问题放在一边。
RSI短期内不会改变你用的产品,但正在决定哪家公司能活过下一轮融资、哪些AI研发岗位会被AI吃掉——Anthropic的代码已有八成是Claude写的。对于正在读大学的学生,RSI的信号很明确:纯执行代码能力正在被AI追上,但"判断什么值得做"——那个L5的终极瓶颈——可能是未来十年最保值的人类技能。
区别只在于一辆车把"省钱"贴在挡风玻璃上,另一辆车把"别翻"写在刹车踏板上——两辆车都在往前开,没有一辆真的停了下来。