想象你站在一个宴会厅外面,里面上千人同时在说话。你把耳朵贴在墙上,录了一段模糊的混响,然后试图回答一个问题:这间屋子里,哪个人说了那句话——那句在几十年后会导致精神分裂症的话?
过去几十年,脑病遗传学基本上就在做这件事。
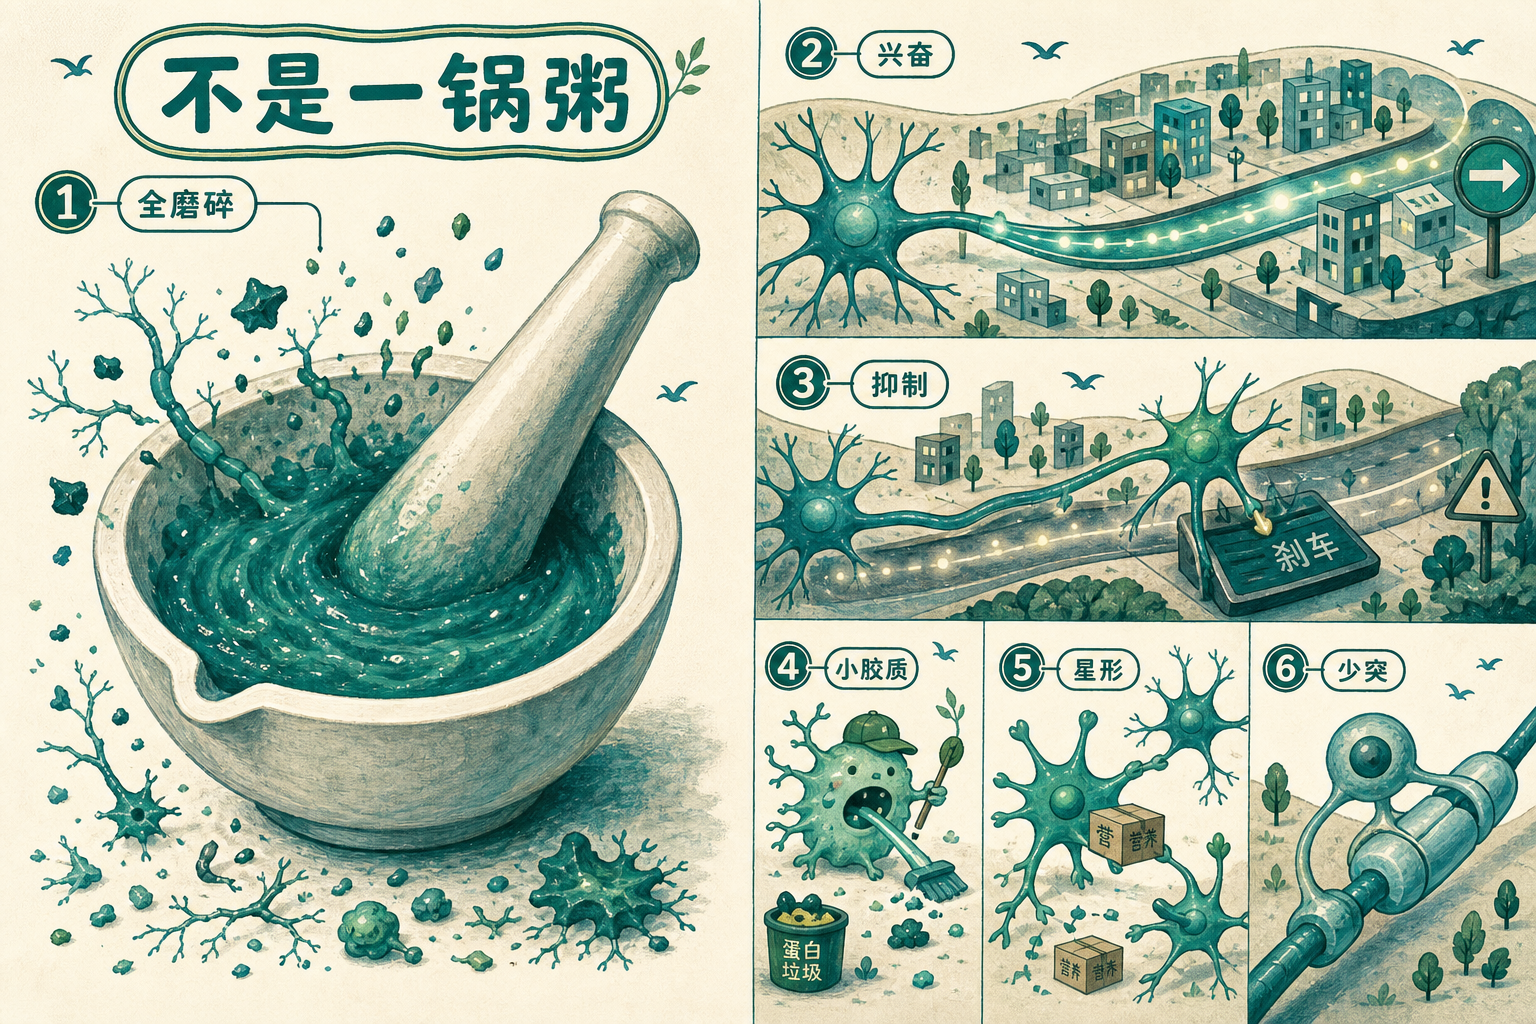
标准做法是把一块脑组织磨碎——神经元、免疫清道夫、支撑细胞、绝缘细胞,统统打成浆——测一个"平均基因表达量",再拿它跟疾病风险做统计关联。问题再明显不过:大脑不是一锅粥。它是一座分工极细的城市。同一块前额叶皮层里,兴奋性神经元在向前传递信号,抑制性神经元在踩刹车,小胶质细胞在巡逻吃垃圾,星形胶质细胞在投喂养分,少突胶质细胞在给电线裹绝缘皮。每一种细胞拿的是同一本基因组,但演奏的是完全不同的曲子——不同基因在不同细胞里以不同的音量表达。全磨碎了,你听到的只有噪音。
更麻烦的是,精神分裂症、双相障碍、阿尔茨海默病这些脑病的遗传风险,绝大多数并不藏在基因本身里。它们藏在基因组的"非编码区"——不直接编码蛋白质,而是充当开关、调光器、音量旋钮:控制哪个基因在哪种细胞里表达多少。一个编码区的突变好比菜谱里的错别字,一眼就能发现。而非编码区的突变,像是遥控器上一个模糊的指印——它只是让某个频道的声音稍微小了一点。你尝整盘菜是尝不出来的。
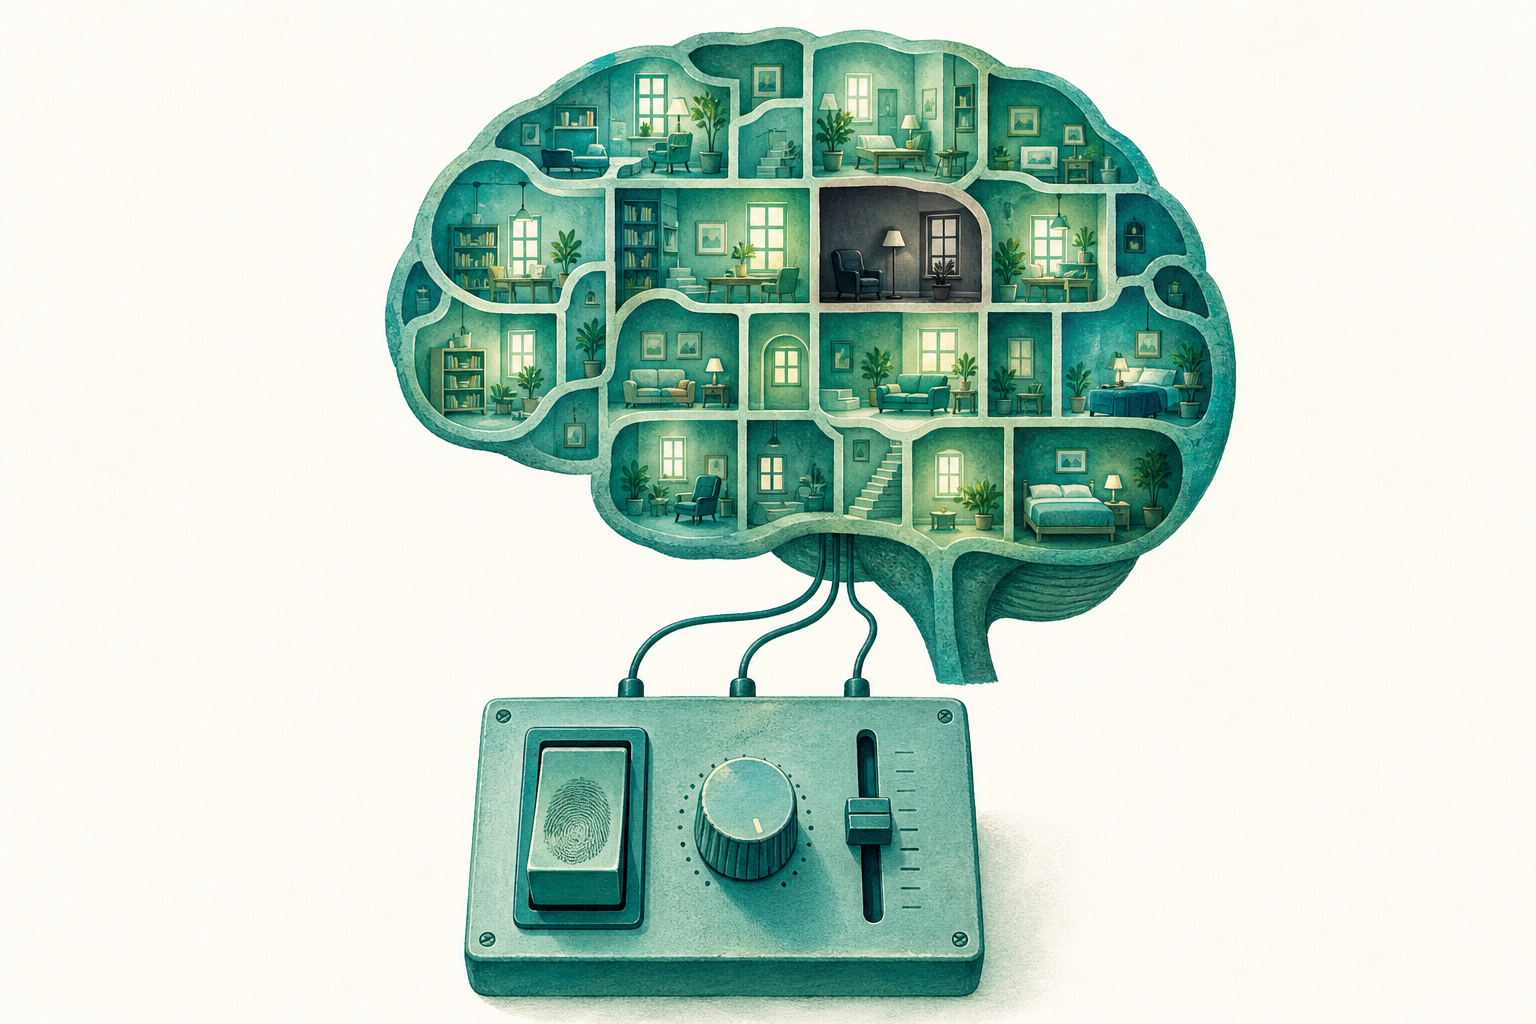
于是问题变成:你手里只有一段宴会厅外墙录下来的混响,怎么找出是哪个房间的哪个旋钮出了问题?
从基因型"算"出每种细胞的表达量——不是魔法,是统计
2026年9月,西奈山伊坎医学院的Panos Roussos团队在《自然》上给出了答案。思路拆开看很直接。
第一步,攒一支精密的"麦克风阵列"。PsychAD联盟此前已对1494名捐赠者的背外侧前额叶皮层——大脑额头后方负责决策和记忆的关键区域——做了单核RNA测序:不磨碎,而是一个一个细胞核地测,超过600万个细胞核。捐赠者涵盖欧洲、非洲和混血美洲人群,覆盖阿尔茨海默病、精神分裂症、双相障碍等八种脑病以及健康对照。这相当于在宴会厅的每一个座位上单独放了一支麦克风。
第二步,训练预测模型。研究者为每种主要脑细胞类型——从八大类细分到23个亚类——分别训练了一套"单核转录组插补模型"(snTIMs)。插补这个词听起来玄,原理并不复杂:已知一个人的基因型——也就是DNA上散落的数百万个单字母变异——模型就能推算出这个人在每种脑细胞里,每个基因的表达水平大概是多少。
怎么做到的?你把它想象成一套"声纹识别系统"。训练时,模型拿920名欧洲血统捐赠者的真实单核测序数据当参考答案:输入是每个人基因组上靠近某个基因的所有单字母变异,输出是该基因在某种细胞里的表达量。核心算法叫弹性网回归——它自动从几百个可能有关的变异里筛出那几个真正有预测力的,同时防止过拟合,就像从一桌子旋钮里只拧那几个连着电路的。模型学会这套映射后,面对一个只测过基因型、从未做过单核测序的新人,它就能直接"算"出这个人在每种脑细胞里的基因表达量——虚拟的,但靠谱。独立数据集上,模型预测和真实测量在绝大多数基因上高度吻合(相关性0.76以上);跟物理分选出的小胶质细胞实测数据比,吻合度更高(0.84)。
这等于把昂贵到不可能大规模推广的单细胞测序,"复印"到了任何有基因型数据的人群里。有了每个人的虚拟单细胞读数,最后一步水到渠成:把这些预测表达量跟12种脑病的全基因组关联分析结合——也就是在几十万人的数据里扫描哪些DNA变异总跟疾病同时出现——看哪个基因在哪一种细胞里表达异常才真正跟疾病挂钩。研究团队还在约60万人的"百万退伍军人计划"数据库中跨族群检验,发现这些细胞类型特异的风险信号在欧洲裔、非洲裔、拉丁裔等多个族群中一致成立。不是单一族群的偶然现象。
阿尔茨海默病真正的战场不在神经元,而在清道夫细胞
翻遍600万个细胞核、12种脑病,最让人意外的答案来自阿尔茨海默病。
过去大众的直觉——甚至很多研究者的默认假设——是:这种吞噬记忆的疾病,主战场应该在神经元本身。毕竟神经元负责思考和记忆,它们一死,认知就塌了。
但snTIMs画出的图景截然不同。阿尔茨海默病的风险基因信号高度集中于小胶质细胞——大脑里负责巡逻、吞噬垃圾、清理有毒蛋白的免疫"清道夫"。基因BIN1在不同细胞类型中的效应差异极大:在小胶质细胞里,它的异常表达与疾病风险紧紧绑在一起;在其他细胞里,几乎风平浪静。相比之下,另一个知名风险基因CLU在所有细胞类型中的效应均匀分布——有些基因是全域性的基础设施故障,有些则是特定工种的失职。
更说明问题的是通路层面的发现。tau蛋白结合通路——由BIN1和APOE两个基因驱动——只在小胶质细胞里达到了显著的疾病关联,在别的细胞类型中根本检测不到。换句话说,阿尔茨海默病的一条核心致病通路,很可能是小胶质细胞的清道夫功能出了岔子,有毒蛋白越堆越多,神经元只是被殃及的无辜邻居。
精神分裂症的故事则完全不同。它的关键信号集中在抑制性神经元——那些在神经回路中负责踩刹车的细胞。双相障碍主要指向兴奋性神经元的一个深层亚层。每一种病都有自己的"细胞身份证"。
整体来看,这项研究共发现8656个基因-疾病关联,其中49.4%——4274个——是传统"磨碎组织"方法完全检测不到的。这些信号之前之所以隐身,正是因为它们只在特定细胞类型里微弱地异动,一被全脑平均就淹没了。就像交响乐录音里某一把中提琴跑调——整体听感也许不觉得,但把中提琴声部单独拉出来,跑调就再明显不过。
还有一个发现不容忽视:阿尔茨海默病和帕金森病在小胶质细胞中共享了49条异常通路,而这些共享信号在全组织分析中完全捕捉不到。两种看似迥异的神经退行性疾病,可能在免疫清道夫细胞层面有共同的起点。
从细胞地图到药,这条路上已经有人摔过跤
知道风险基因在哪种细胞里作乱,对药物意味着什么?一句话:靶向从"炸掉整栋楼"缩小到了"修好那个坏掉的开关"。
西奈山团队所在的研究网络已启动了一个机器人药物筛选平台,每周测试超过一千个候选化合物,直接针对从细胞图谱中定位出的分子改变。另一项同期研究将阿尔茨海默病的141个已知风险基因按细胞类型归位:78个定位在小胶质细胞(其中43个是小胶质特异性的)、44个在星形胶质细胞、41个在兴奋性神经元。这141个基因中,有36个已经是FDA已批准或临床试验阶段的药物靶点——只是此前没人确切知道这些药到底该冲着哪种细胞去。
但这张图不是万能药方。有一个教训必须讲。
基因TREM2是小胶质细胞表面的一种"危险探测器",也是snTIMs这类分析鉴定出的明星靶点之一。生物技术公司Alector开发了一个激活TREM2的抗体药物AL002,在381名早期阿尔茨海默病患者中推进到三期临床。2024年11月,结果揭晓:失败。72周治疗,没有任何一项生物标志物出现改善。更麻烦的是,药物仍然引起了相当比例的不良反应——脑水肿和微出血——在携带高风险APOE4基因型(一种让阿尔茨海默病风险大幅升高的遗传变异)的患者中尤甚。
这次失败恰恰说明了细胞类型特异性为什么只是第一步,不是终点。即便你知道靶点在小胶质细胞,还要回答更细的问题:在疾病的不同阶段,同一个基因是在保护还是在伤害?TREM2在早期可能帮清道夫细胞干活,但持续过度激活反而让它们"脱敏"——就像反复拉响的火警,最终没人再当回事。此外,AL002不只结合大脑里的小胶质细胞,也会被外周血液中的巨噬细胞截胡——"细胞类型特异"的精准因此而打了折扣。
这引出了更深层的硬天花板。snTIMs目前只能可靠预测约60%的基因表达(欧洲血统人群),非洲血统覆盖率约41%,混血美洲更低。还有大约四成基因的表达量从基因型层面根本无法可靠推算——它们更多受环境、表观遗传(不改变DNA序列、但能在基因上贴"便利贴"决定开关的调控层)或稀有突变支配。跨族群的模型可移植性也是痛点:欧洲模型和非洲模型之间,可插补基因的重叠度仅约四成。而且说到底,这一切都是统计推断,不是生物学的判决书——要真正把关联变成因果,下一步必须用CRISPR基因编辑等技术在真实脑细胞或类器官(实验室培养的微型脑组织)中逐一验证,这在目前还没有任何大规模研究完成过。
对正在关注阿尔茨海默病药物进展的患者和家属来说,snTIMs不会明天就送来新药。但它改变了方向盘的角度:过去药物开发盯着"神经元死亡"这个终局画面,现在可以瞄准更上游的事件——小胶质细胞从保护者变成失职者的那个瞬间,抑制性神经元刹车失灵的那个转折点。同一时期的一项研究发现,脑细胞中基因表达的中位遗传力只有约4%——这意味着还有96%的变数不写在你与生俱来的基因型里。但这4%,正是我们目前能系统干预的疆域。
把大脑磨成浆找病因的年代过去了。现在是坐下来,听清每一把中提琴的时候。