你小时候玩过传话游戏吗?一句话经过五个人传下去,最后变成完全不相干的另一句话。现在,把这个游戏搬进AI:让模型根据"桌上有两个红杯子"生成一张图,再把图描述出来,再用描述重新画图——来回传三轮。通常,某些细节会悄悄消失或变形:两个杯子变成三个,红色褪成粉色,左边的花纹跑到了右边。
但上海交大和中国电信人工智能研究院的团队发现,这些"传错"的信息不是废料——它们恰好暴露了模型理解与生成之间的裂缝。关键在于,你能不能把这些裂缝变成训练信号。
他们的方法叫Dreaming in Flow:让模型先做一场可控的视觉梦,再反复审讯这场梦,最后把审讯结果反过来修正下一次生成。听起来像"自我进化",但真正聪明的地方恰恰相反——它设计了一套精密制衡,防止模型把自己的错误越学越牢。
一、能看又能画,为什么反而不是一回事?
统一多模态模型——那种既能看图回答问题、又能根据文字生成图像的AI——是最近两年最热的赛道之一。GPT-4o、Gemini、Janus都在做同一件事:把"理解"和"生成"塞进同一个神经网络,共享同一套参数。
问题在于,塞进去不等于会协作。你可以把它们想象成同一栋楼里的两个部门:理解部负责看图说话,生成部负责按文字画图。它们共用电梯和走廊,但很少真正开会交流。理解部知道"左""右""红""两个"分别是什么意思,可轮到生成部画图时,这些知识不一定会传递过去——于是它会画出三只杯子,或者把左边杯子的花纹错贴到右边。
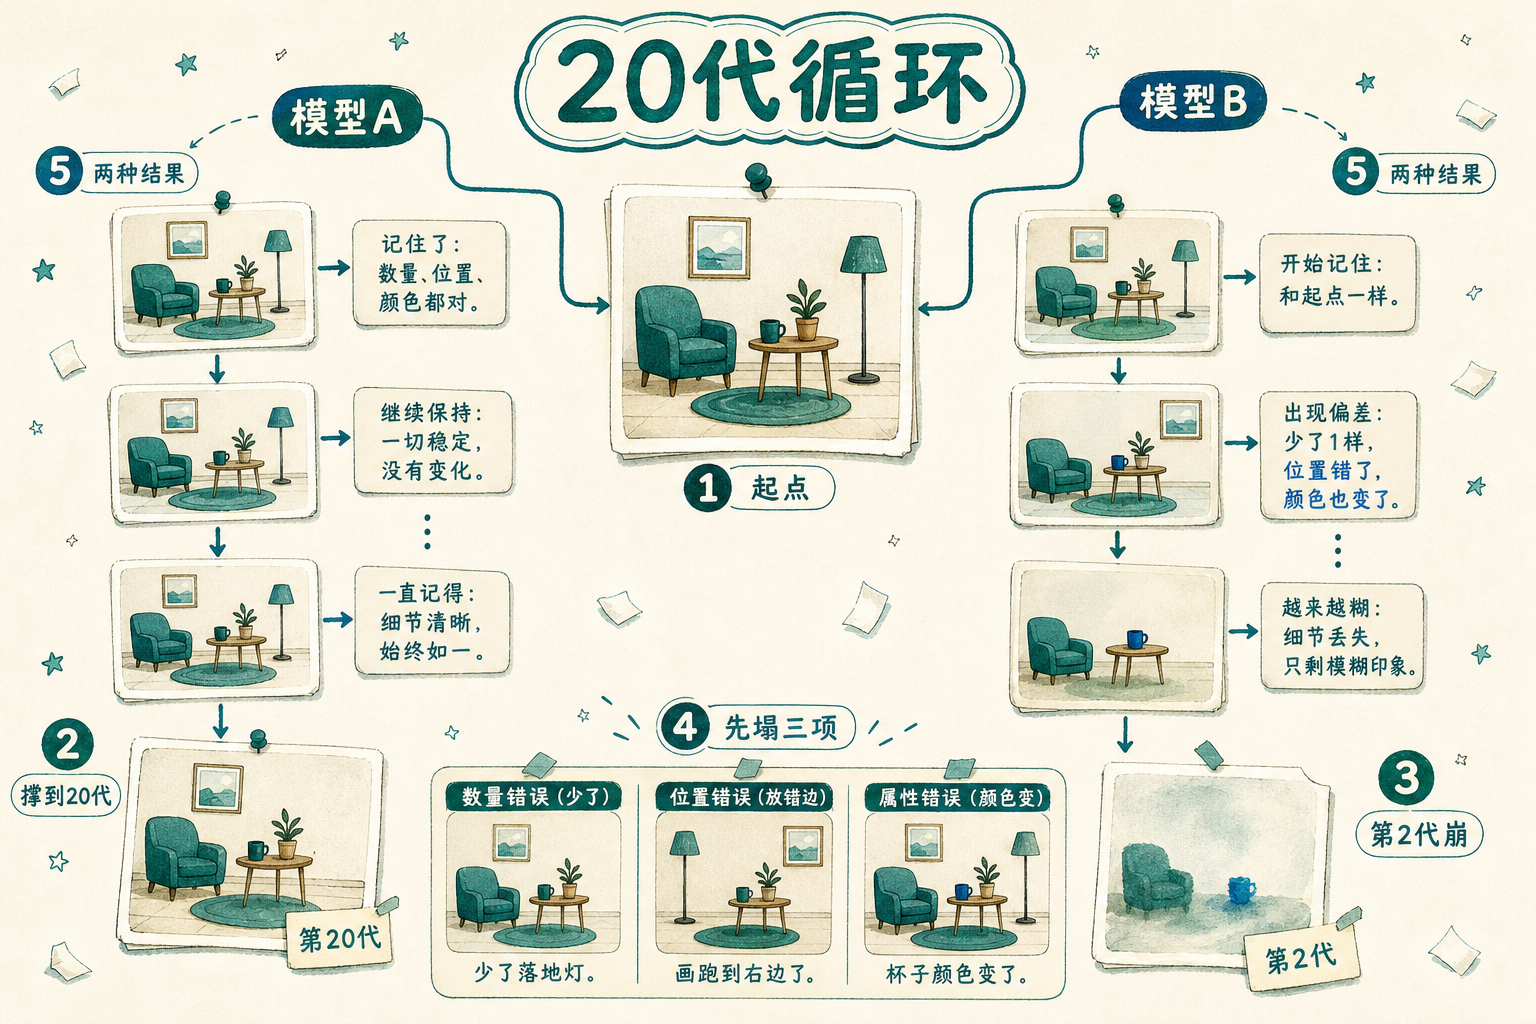
这不是一个理论上的漏洞。有研究者做过一个量化实验:让AI把图像转文字、再文字转图像循环传20代,测量语义偏移。BAGEL(一个140亿参数的多模态模型)勉强撑到20代,而另一种模型到第2代就崩溃了——计数、位置、属性绑定这些组合信息最先塌缩。也就是说,一个普通的多模态模型反复"看图说话再画图",它的世界很快会坍缩成一团含糊的语义。
这就逼出一个悖论:如果模型自己生成的图像本就充满错误,用它来训练自己,难道不是把谣言当教材吗?
二、从"打总分"到"指方向"
这正是Dreaming in Flow最核心的贡献。它不满足于让理解分支给生成结果打一个总分——"这张图70分"。总分能告诉你好不好,却没办法指出哪里该改、往哪个方向改。
团队的做法分两步。
第一步:造梦与审讯。 模型先用生成分支根据一条文字提示画一张图——论文把它叫做"视觉梦境"。然后理解分支读取这张图,生成一段描述;生成分支再用这段描述重新画图;理解分支再描述;再画一次。最后得到"图→文→图→文→图"五个节点的回放链。
这像传话游戏,但目标不同——它不是比谁传得准,而是测量哪些信息"稳定"。如果"金毛犬、红色飞盘、海滩"在三轮回放中始终保留,说明它们确实是模型内部坚实的视觉知识;如果某个属性第一轮就消失,说明模型对它的理解本身就不牢。团队没有要求每张重画图像像素完全一致——那会把模型变成复印机;它要求的是语义分布保持一致,也就是对物体、属性和关系的判断不要乱跑。
但这里有一个陷阱:如果模型学会了一套套话,不管画什么都回答"一只狗在海滩上"怎么办?团队为此加入了无关梦境作为反例——从另一条完全不相关的提示生成一张图,要求主回放链与它拉开距离。这相当于告诉模型:一致不等于含糊,真正的理解还要会排除不相关的东西。在消融实验中(逐一关掉某个组件,看它到底多重要),拿掉这个反例机制后,综合评测分数直接掉了约19分。
第二步:把审讯结果变成修正指令。
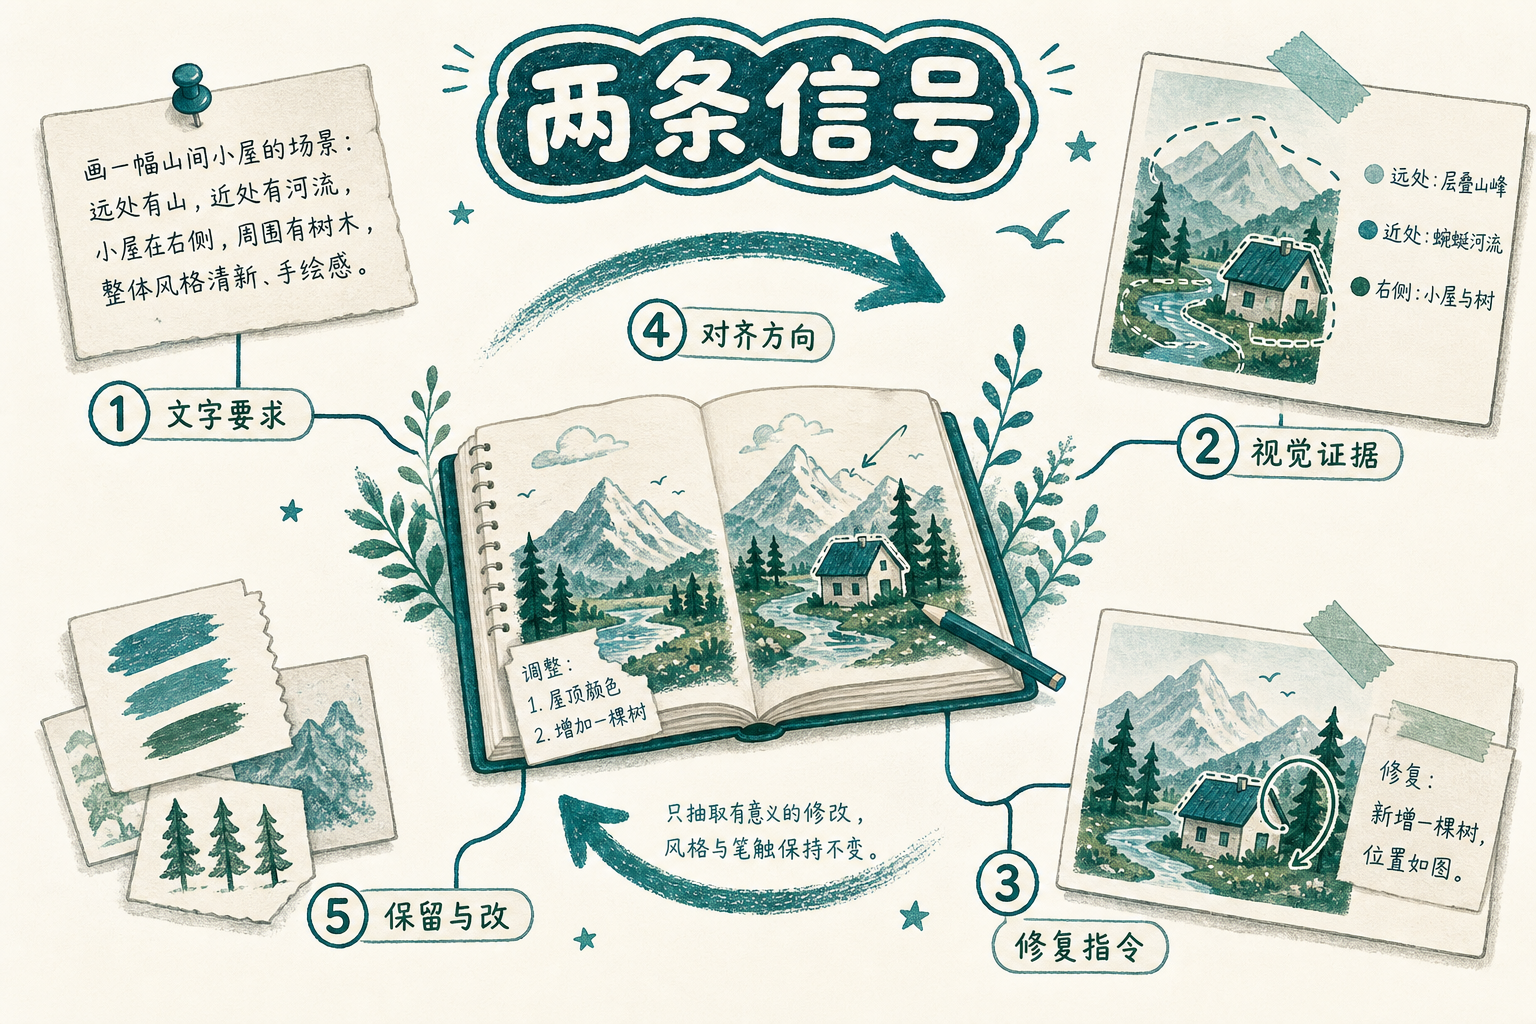
它利用了图像生成模型内部的一个特性。所谓"生成",本质是从一张纯噪声出发,一步步去噪,直到浮现出清晰画面。每一步的修改方向——该把哪个区域的像素往哪个方向调整——模型会根据输入条件给出不同的答案。同一张半成品的带噪图,分别输入纯文字、纯图像、图文组合、以及图文加上修复指令,模型会指向四个不同的去噪方向。
把这些方向放在一起比较,就能分离出三样东西:文字提出了什么要求、图像提供了什么具体视觉证据、修复指令希望纠正什么。然后通过两条训练信号把它们用起来:第一条让纯文字条件下的去噪方向靠近图文共同条件下的方向——相当于把图像里更具体的空间和属性信息蒸馏进文字驱动的生成能力中。第二条提取修复指令引起的方向变化,去掉与提示词无关的风格信息——相当于告诉模型,不要机械照抄自己画的图,而要学到"这张图哪里值得保留、哪里需要改"。
打个比方:想象一个学生做数学题。传统的"打总分"像老师在卷子上写个"70"。而这个方法像老师在每一步推导旁边画箭头——"这里符号错了,往左改。那里漏了一步,补上。"它不是评判结果,而是介入过程。
还有一道关键的保险:冻结初始模型锚点。模型每次更新后,都要检查当前生成方向有没有偏离原始模型太远——如果偏离超过了限度,就会被拉回来。这像给模型系了一根安全带:允许它学新东西,但不能把原本稳定的画质和多样性丢光。拿掉这个锚点后生成分数降幅最大——说明防止能力漂移不是装饰,而是地基。
三、谁会因为这个方法受益?
Dreaming in Flow最直接的受益者是统一多模态模型的训练管线。
目前产业端有一个尴尬的现实。2026年初一项基准测试横跨多种架构,结论是当前"统一"模型只实现了表层统一——两个能力住在一起,却没有深度打通。你可以让GPT-4o生成一张包含十几个物体的复杂图片,OpenAI官方宣称它能处理10到20个不同物体并保持属性绑定。但如果让它自己描述刚画的图里的物体数量和位置,仍然会翻车。这类翻车——手指数不对、杯子数量与文字不符、花纹贴错位置——恰恰是Dreaming in Flow展示出明确改善的维度。
在三种结构各异的统一模型上,无论大小,计数、位置和颜色属性绑定分数都获得了增长。BAGEL的综合生成分数从84.30升到86.97;OpenUni模型的位置分数从17.75翻到34.25,颜色属性从30.00升到38.25。打一个未必恰当的比方:它修理的不是画面好不好看,而是"这张图到底画对了没有"这一类更难骗自己的问题。
从成本角度,方法也有实际吸引力。它不需要额外成对的图文标注数据,不需要调用另一个更强大的模型来逐张打分——这两种做法目前都很贵。两张H100显卡训练约4.1小时,只更新模型的一小层"补丁"(学术上叫低秩适配器),原始参数保持冻结。对比另一种用奖励模型给图像打分的做法,后者需要八张H100先花约3小时生成数据、再花约15小时评分、最后训练约1小时——Dreaming in Flow把经验生成和双向优化合并进同一个训练步,省掉了独立的大规模评分流水线。
对普通用户,收益更间接但可感知:如果一个多模态模型能更稳定地保证"两杯咖啡"真的是两杯、"蓝色花纹"确实在左边那只杯子上,那设计海报、做内容创作、甚至闲聊时让AI画一张图,翻车的概率会下降。但目前这只是训练框架,不是即插即用的产品更新——论文没有公开代码,外部团队还无法直接复现。
四、"自我进化"这个词,暂时还太重了
Dreaming in Flow很容易被包装成"AI从自己的梦中自我进化"。但论文实际做的事情要窄得多:在固定的一千步后训练中,用一千条主提示和一千条无关提示产生视觉经验,只更新低秩适配器,并用冻结初始模型限制偏移。
它没有展示跨月持续学习的能力,没有证明模型能主动发现新的训练目标,也没有验证多轮反复自训练后会不会出现累积偏差。更准确的说法是:它提供了一套精巧的后训练框架,让自生成图像成为受约束的训练样本,而不是放任模型"自己说什么都算对"。
一个值得警惕的问题在论文自身也没完全回答:当理解分支和生成分支共享大量参数时,双向反馈可能出现"共同犯错"。两边如果依赖相同的错误表征,回放一致并不一定代表更接近真实——它可能只代表内部说法统一。这个困境在软件工程史上有一个著名的先例:上世纪八十年代,研究者发现让多个团队独立编写同一功能的程序、再投票表决,并不如预期可靠——因为不同程序员会犯相似的错。共享参数的两个模型分支,比两个不同程序员更容易走入同一个盲区。
还有一个更底层的局限:方法依赖前面说的那种去噪方向比较机制(即流匹配),无法原样移植到扩散模型(另一种主流生成技术路线)或自回归图像生成器(逐像素依次生成的方案)等不同架构上。训练提示的来源也会影响结论——如果一千条提示主要覆盖常见物体和简单关系,换成长文字、多语言或非常规空间结构,回放链能否保持语义一致,尚未回答。
但这些局限并不削弱核心思路的价值。真正值得从这篇论文里带走的,不是一个可抄的训练配方,而是一条原则:自生成数据必须经历怀疑才能变成经验。无关反例、回放一致性、旧能力锚点——这三样东西构成了一套最低限度的安全网。任何想让AI从自身输出中学习的团队,迟早都要面对同一个问题——你怎么知道它学到的是真知识,还是只记住了自己的口癖?
对正在构建多模态产品的工程团队来说,Dreaming in Flow提醒了一个经常被忽略的指标:不是"模型偶尔答对图里有几个杯子",而是"它在同一张图上能否同时说对数量、颜色、左右位置和所属关系"。产品评测拆开这些维度,才知道每次升级到底改善了什么。
让模型做梦很容易。让模型怀疑自己的梦,才是真正困难的事。