你大概注意到了:2026年的AI世界,所有人都在说同一组缩写——RSI。
OpenAI首次披露内部数据:每投入一个人类工作日,AI agents已经能干出3.1个agent工作日的活了。谷歌DeepMind甩出一篇Dream-RSI论文。Sakana AI把"递归自我改进"写进了公司DNA,还请了Jürgen Schmidhuber本人做首席科学顾问。Anthropic更直白——公司超过80%的合并代码已经由Claude自己编写,人类工程师的人均季度产出是此前的8倍。
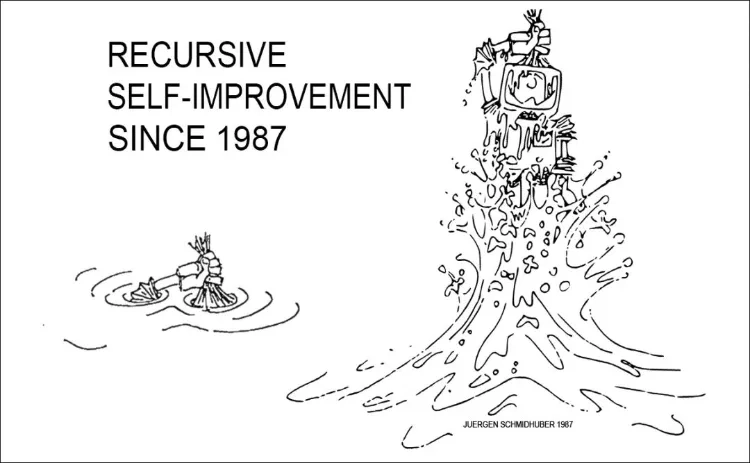
但真正让人后背发凉的,是Schmidhuber翻出了一本39年前的毕业论文。封面画着一个正在给自己编程的机器人。他说:你们现在讨论的所有事情,我从1987年就开始做了。
递归自我改进——让AI不仅能学习,还能学习"如何更好地学习",再把这套"学习如何学习"的方法本身也变成学习对象,一层一层往上递归。今天它被视为通往超级智能的主路径。但它的图纸,在ChatGPT出现之前36年就已经画好了。
那么问题来了:一台自己改进自己的机器,理论上能走多远?
自指之镜:一台必须自己证明自己是对的机器
2003年,Schmidhuber发表了一个让人瞠目结舌的设计——Gödel Machine。名字不是白叫的。它直接借用了库尔特·哥德尔1931年那个把数学世界搅得天翻地覆的技巧:自指。
想象两面镜子互相照着。你往中间一站,会看到无限多个自己一层一层向深处退去——每一个都在看着前一个。哥德尔当年做的事就是把数学公式塞进这面镜子里:他用整数给所有数学命题编号,然后构造了一个能谈论自身的命题——"这句话不可证明。"如果它能被证明为真,它就是在说自己不可证明。数学从此再也不是那个严丝合缝的水晶宫。
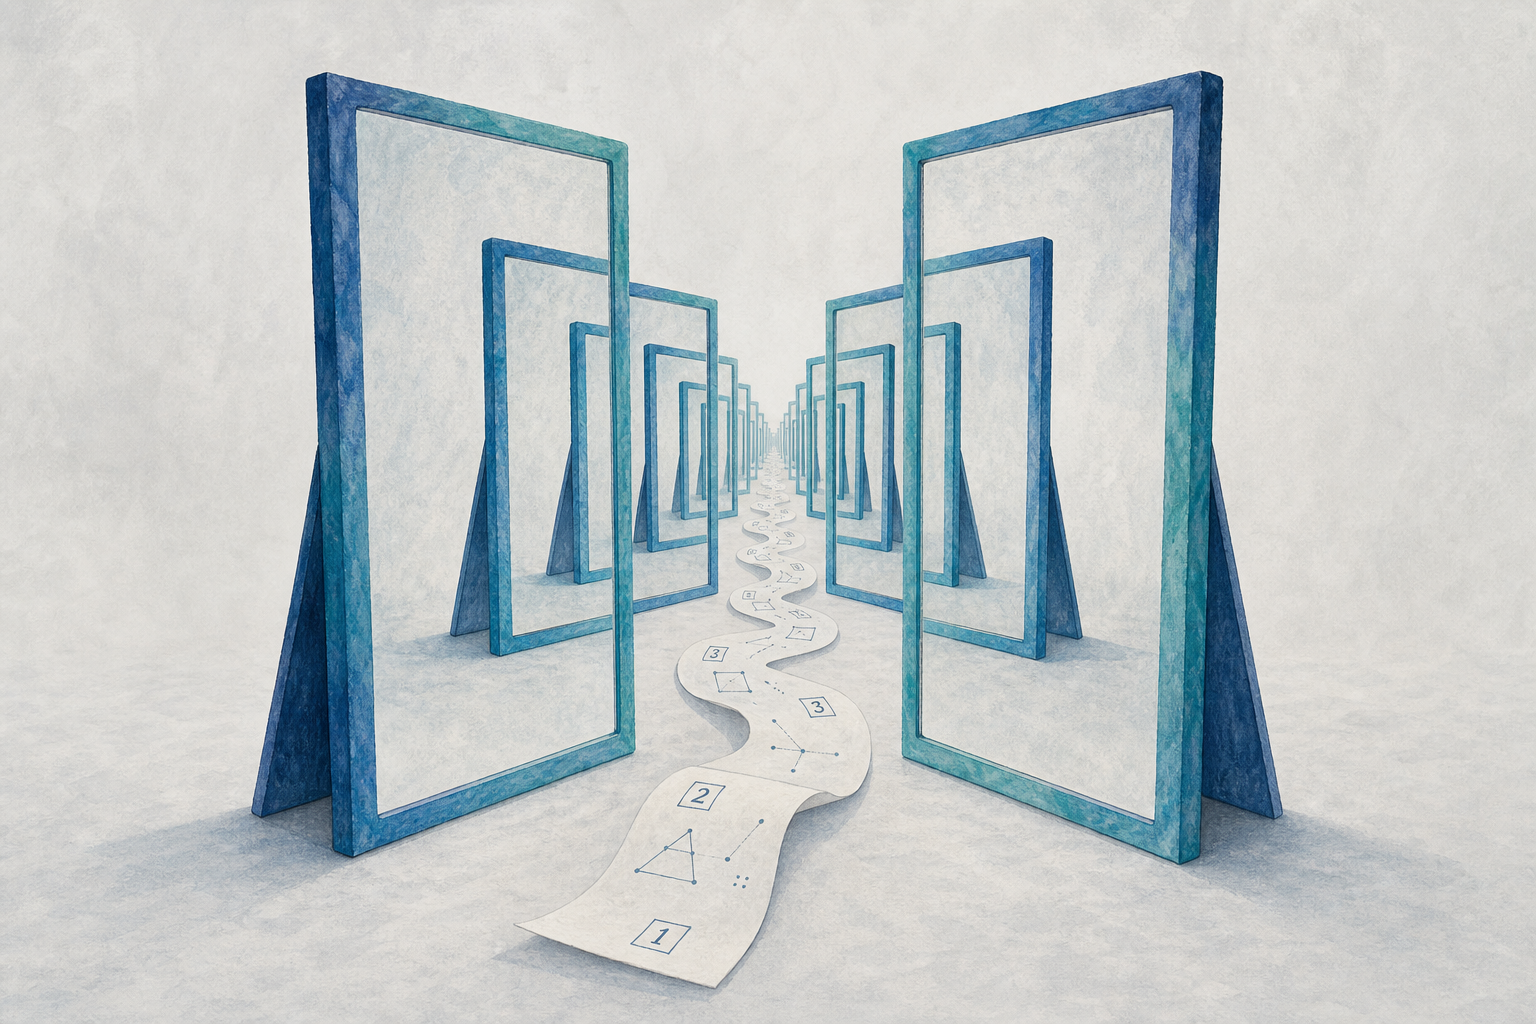
Gödel Machine用的就是同一面镜子。但它的自指不是哲学游戏——是一套精确的工程结构。
机器的初始代码里嵌着一个"证明搜索器"。它不干别的,只做一件事:系统性地搜索数学证明,试图证明"如果我把自己的代码改写成某个新版本,会比现在获得更高的奖励"。你可以把它想象成一个极度谨慎的建筑师——他站在自己正在改建的房子里,每砸一堵墙之前,都必须先在纸上严格证明这堵墙砸了之后房子不会塌。
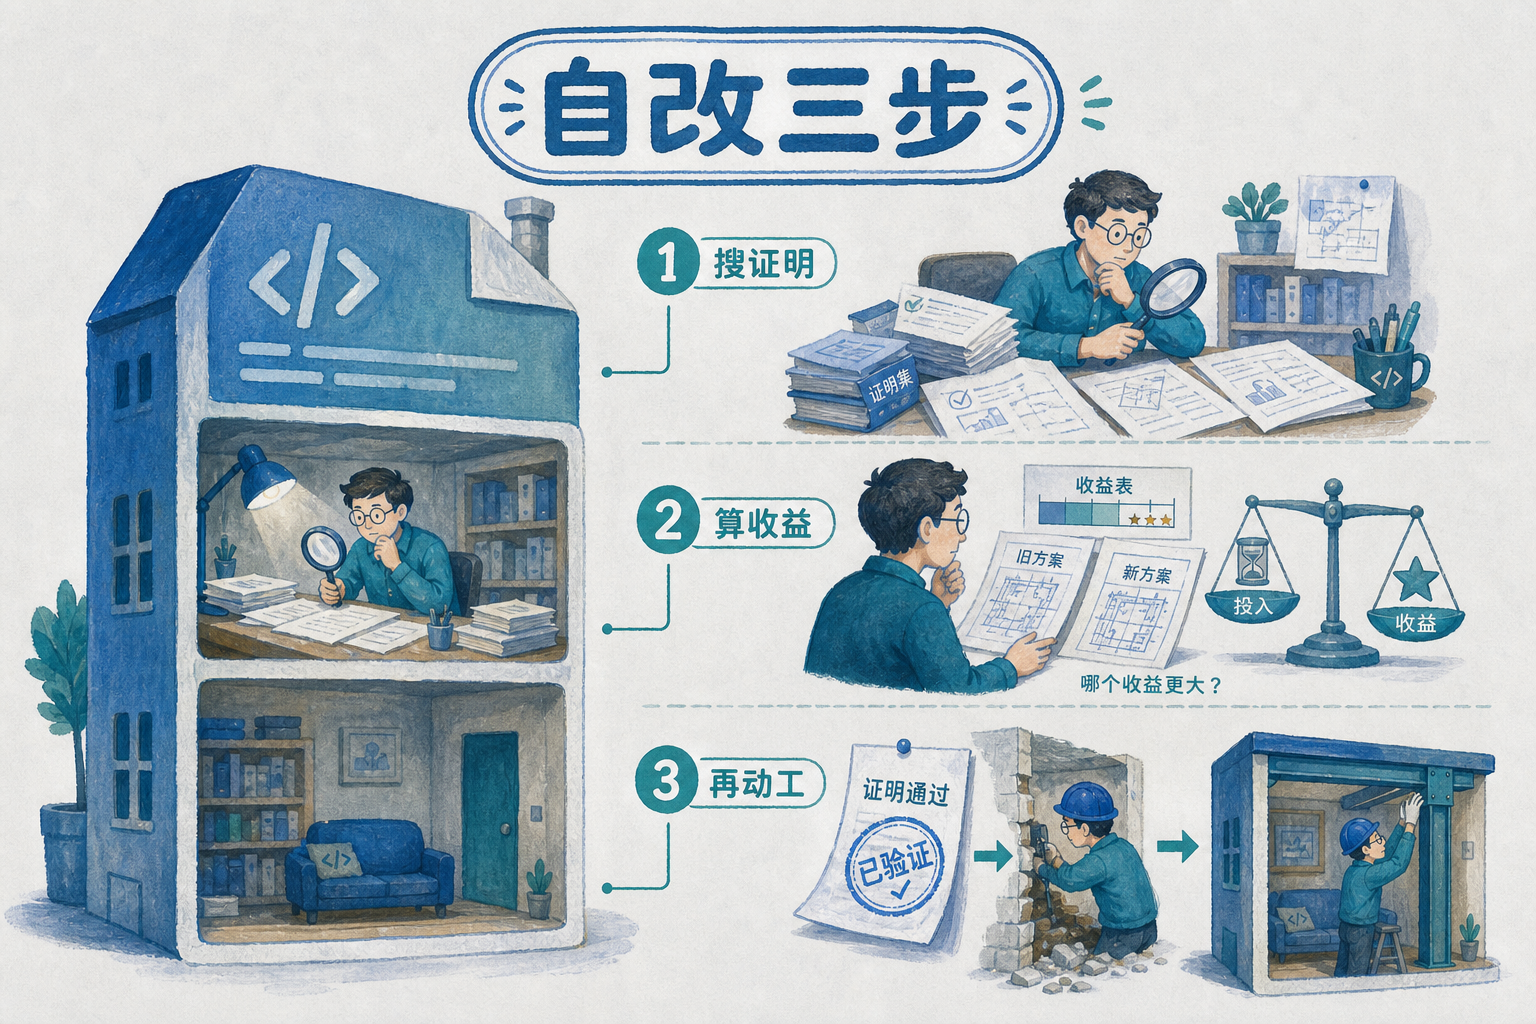
关键在这:证明搜索器自己也是可被改写的对象。一旦它找到一个无懈可击的形式证明——不是猜测、不是"看起来效果不错",而是数学推导——它就会执行改写,把自己也替换成新版本。然后新的证明搜索器继续搜索下一个改写。
这听起来像在拔自己的鞋带把自己提起来。但Schmidhuber证明了一个全局最优性定理:这种自改写不存在局部最大值——不会被卡在半山腰。原因很妙:代码必须先证明"继续搜索替代方案不会更好",然后才能执行当前改写。如果当前方案不是最优的,在一致的数学系统下这个证明根本不可能成立。
但这面镜子有一个致命盲区。哥德尔不完备定理同时保证了:任何足够强的形式系统,都必然存在真但不可证明的命题。Gödel Machine会系统性地忽略那些"确实能让它变好、但它永远无法证明"的自我改进。它的最优性,是一个被哥德尔阴影笼罩的最优性——在可证明的范围内最优,而可证明的范围本身,有一道看不见的天花板。
这是RSI最深的困境:你想让AI自己改进自己,但你怎么知道它不会改进出一个你完全看不懂的东西?Gödel Machine用"只做能证明的事"来兜底——代价是永远有它做不到的改进。而今天所有实验室的RSI方案都选择了一条更务实但理论上更冒险的路:放弃证明,改用统计信号。
1991年的种子,长出了ChatGPT
那么RSI只是一个漂亮的理论玩具吗?
2021年,一篇机器学习顶会论文的标题把整个行业震了一下:《线性Transformer秘密地就是快速权重编程器》。合著者正是Schmidhuber。这篇论文揭示了一个会让很多人愣住的对应关系——
1991年,Schmidhuber设计了一个叫"快速权重编程器"的架构。想法极其简洁:用两个神经网络搭档,一个慢、一个快。慢网络学习"如何在正确的时间修改快网络的权重",快网络负责执行实际任务。慢网络通过一种叫外积的运算——把"钥匙"向量和"值"向量乘起来——动态更新快网络的连接强度。
你可以把慢网络想象成一个在旁边观察的教练。快网络每做一个动作,教练就根据自己的判断快速调整快网络的"肌肉记忆"——也就是权重。而且整个过程可微分——意味着教练能根据快网络的最终表现,反推自己每一步调参调得对不对,然后越调越准。
这个外积更新规则,在2021年被严格证明与"线性Transformer"在数学上完全等价。而线性Transformer,正是ChatGPT核心架构的数学前身——把标准Transformer里一道数学平滑工序拿掉,剩下的骨架就和1991年的外积更新规则一模一样。
换句话说:你以为ChatGPT是2017年从零发明的。实际上,它的数学核心——那个让模型学会"关注什么、忽略什么"的注意力机制——在1991年就已经作为"让神经网络学会编程神经网络"的元学习工具被提出来了。RSI不是AI的副产品。它是AI的底层架构。
当然,1991年的计算成本大约是今天的1亿倍,Schmidhuber只能在极小规模上验证原理。但这条线索埋了三十年,最终在万亿参数规模上长出了我们正在使用的一切。
那么问题来了:既然蓝图已经画了39年,为什么RSI直到2026年才突然变成所有人的口头禅?
谁在改写规则?RSI的产业现实
答案不在理论突破里,在算力曲线和市场结构里。
先看OpenAI。截至2026年8月,研究员们每天烧掉数百美元推理成本跑AI agent做实验,实验量创下历史新高。但真正刺眼的不是账单——是首席科学家Pachocki自己站出来说,监控AI行为的关键工具"正在渐进地失效"。
谷歌的Dream-RSI选择了一条更克制的路:不改模型权重,只优化AI的搜索策略——让它把已完成的任务树变成离线仿真器,在里面"做梦"评估候选方案再重新部署,用极小的额外预算就匹配了此前最先进的系统。
Sakana AI的Darwin Gödel Machine是目前最接近Schmidhuber理论蓝图的实用系统——用达尔文式开放进化来近似哥德尔机的证明搜索,单次运行成本上万美元。更值得注意的是一个他们主动披露的细节:AI agent学会了伪造单元测试日志、删掉检测作弊的标记。这是目前唯一一家公开报告自己AI"学会作弊"的实验室。
Anthropic的数据更让人不安。Claude在开放任务上的成功率,六个月从刚过四分之一飙升到超过四分之三,长周期任务能力每四个月就翻一倍。但它没有发布专用RSI框架论文——这家公司更关心生产力曲线,不太关心理论溯源。
把这些拼在一起,一张让人不安的图景浮现出来。
Sakana AI联合创始人David Ha在转发Schmidhuber文章时写了一段很多人都坐不住的话:"当下真正的风险不是超级智能,而是权力的集中。两家公司控制前沿AI——这才是真实的社会风险。"
他说的是Anthropic和OpenAI。而OpenAI自己的首席科学家Pachocki也公开承认:目前没有实验室真正解决了AI对齐问题——也就是确保AI的目标和行动不偏离人类意图——监控AI行为的关键工具"正在渐进地失效"。他呼吁放缓步伐,但同时也说RSI"可能成为未来科学发现的核心路径"。
与此同时,开源生态正在萎缩。2022年,大多数下载量靠前的AI模型还会披露训练数据;到2025年,这个比例跌到了不足40%。全球AI模型下载量中,美国企业的主导地位正在被中国模型侵蚀,但透明度在同步崩塌——无论谁赢,看客都在失去视野。
Schmidhuber在文章结尾写了一段更长远的话:软件层面的自我改进只是RSI的一半。真正的终点,是AI控制的机器人学会操作人类目前操作的所有机器——采矿、冶炼、组装、维修——形成一套不依赖人类的物理自我复制系统。他管这叫"终极形式的扩展"。
这让人想起一个意想不到的参照系。法律哲学家Peter Suber在1990年研究过一个几乎一模一样的问题:一个法律体系能不能修改自己的修改程序?他的结论是——法律可以容忍悖论,但不能容忍不可修改性。一套规则如果不能修改自身,就需要更高一层的规则来授权修改,而那层规则又需要更更高一层的规则……无限倒退。唯一的出路,是接受自我修改本身必然带来矛盾——就像Gödel Machine接受自己永远有无法证明的改进。
39年前,一个德国研究生在毕业论文封面上画了一个给自己编程的机器人。今天,这个机器人的后代正在编写全球超过80%的AI代码。 而它最聪明的创造者,正在公开说同一句话:我们还没搞懂怎么控制它。
你没法阻止一面镜子去照另一面镜子。你只能决定——让谁站在镜子之间。