你让一个读过整个互联网的模型写一封200字的项目延期邮件。它可能直接写好,也可能给你一篇《如何撰写项目延期说明》的教程,或者继续往下续写类似的网页文本。
这几种反应在它看来概率差不多。因为预训练阶段,模型的核心任务只有一个:预测下一个字。它从海量文本里学会了语言和推理,却从没被训练成"看到指令就按要求回答"的助手。
把一只什么都知道的野兽驯化成听话的助手,靠的是后训练。而后训练这件事,和培训一个新员工惊人地相似——先给范例照着学,再让主管比较哪个版本更好,最后用程序自动检查结果对不对。
第一步:先给100封范文——监督微调能做什么,不能做什么
培训新员工最直接的办法是什么?给他看100封好邮件,让他照着写。
大模型后训练的第一步完全一样。拿出一批"问题—标准答案"的配对,让模型看上半段、预测下半段的每个字,朝标准答案方向调整自己。这一步在行话里叫监督微调——学术缩写SFT。
2021年,谷歌的研究者做了一个实验:把62个自然语言处理任务——从翻译到问答、从摘要到推理——全部改写成"请回答以下问题……"的格式,在一台1370亿参数的模型上微调。1370亿参数是什么概念?差不多把人类已知语言模式的几乎所有规律都编码进去了。结果令人吃惊:这个模型在25个从未见过的任务中,有20个零样本表现超过了参数规模更大的1750亿参数模型。它证明了一件事——指令微调不是在教模型新知识,而是在帮它把已有能力组织成"回答问题"的格式。
但真正让人重新审视SFT的,是Meta在2023年做的一项实验。研究者只用1000条精心挑选的高质量示范数据——不到一本中等厚度小说的内容量——在650亿参数的LLaMA上微调,结果在43%的情况下被人类评审认为"等同或优于GPT-4"。
1000条数据。不到一本中等厚度的书。
这说明SFT的数据质量远比数量重要。但它也暴露了SFT的根本天花板:同一封延期邮件,有人要简洁、有人要解释充分、有人想强调风险分担——如果每个问题只配一个标准答案,模型只知道"这样写可以",却不知道另一个回答为什么略差。它学会了模仿,却学不会判断。
更麻烦的是,多项研究发现SFT倾向于只捕捉"表面格式和输出风格",而不是真正理解任务。你可以教它用结构化的数据格式回答问题,但并不意味着它理解每条数据背后的意义。
第二步:让主管来比较——从RLHF到DPO,人类偏好如何进入模型
如果好答案不唯一,那就别让标注者写出完美答案了——让他们在两个回答之间选择更好的那个。
这就是基于人类反馈的强化学习(RLHF)的核心思路。标注者面对同一个问题和两个回答,只需说"A比B好"。这个操作撑起了ChatGPT和Claude的训练管线。
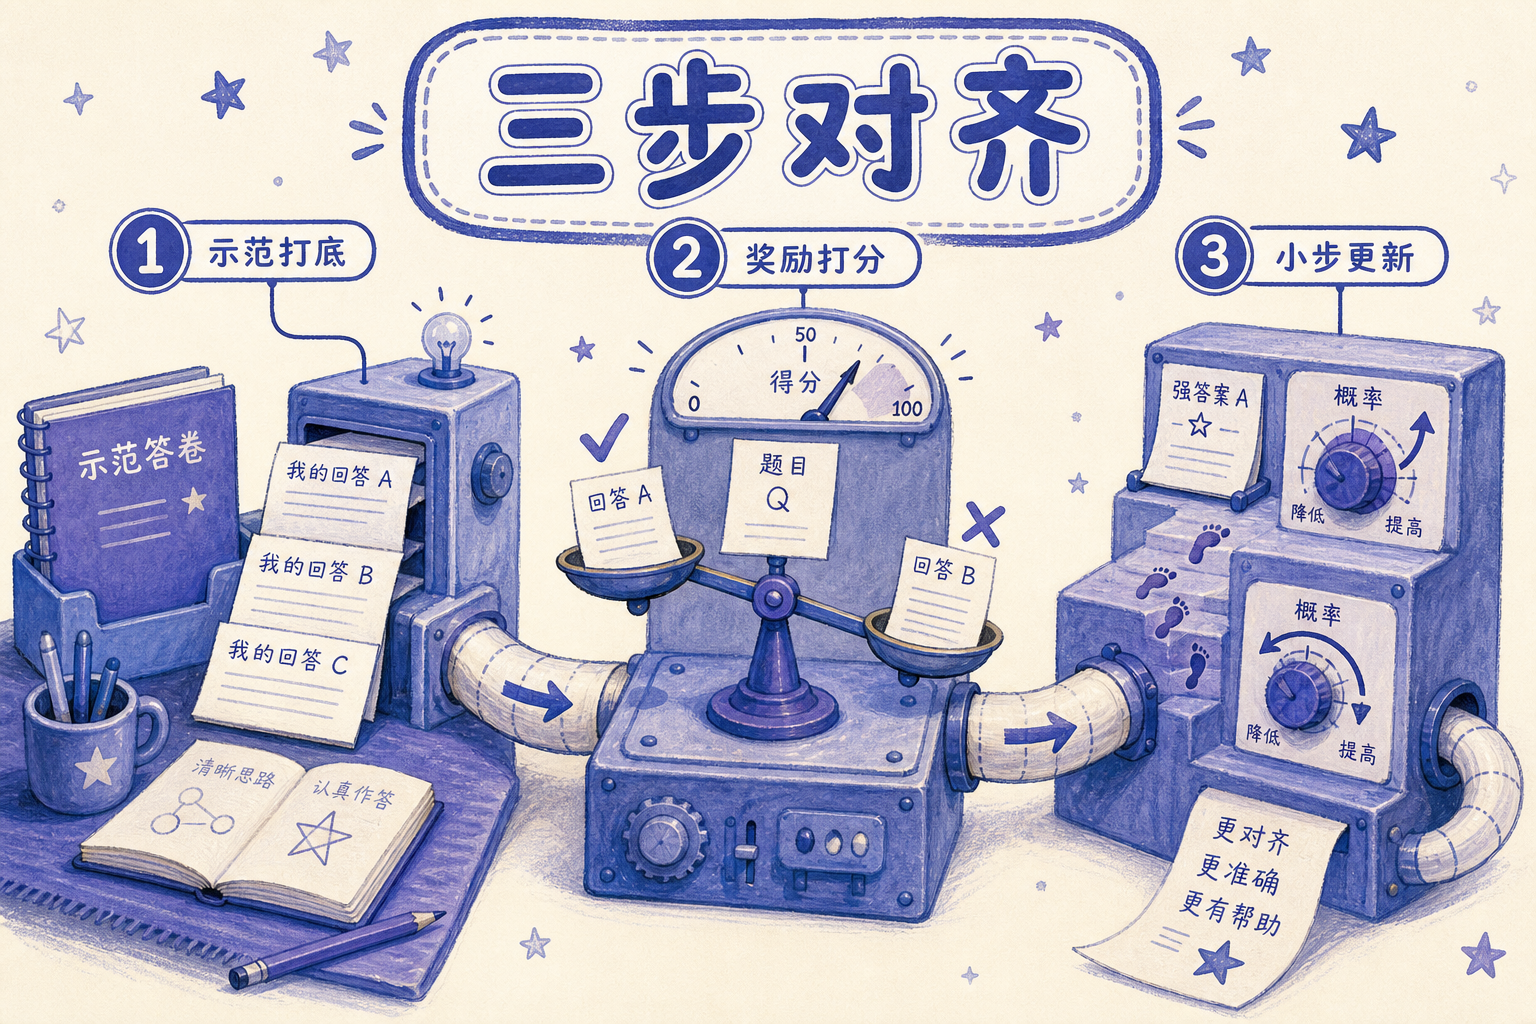
经典RLHF分三步。第一步还是SFT打底。第二步,用人类偏好数据训练一个"奖励模型"——输入问题和回答,输出分数,被选中的回答(chosen)的分数必须永远高于被拒绝的回答(rejected)。第三步是重头戏:让策略模型不断生成回答,奖励模型打分,再用一种叫近端策略优化(PPO)的算法往回更新。PPO的核心思路是小步慢走——每次只允许模型改动一点点,防止一步跨太大直接训崩——高分回答的生成概率提高,低分的压低。
但这套流程的工程链路极其复杂。同一时刻要跑四件事:策略生成、奖励打分、参考约束、PPO更新。更致命的是奖励模型本身就是个"代理"——它从有限比较数据中找规律,可能把"回答更长""格式更工整"当成质量,而策略持续优化同一奖励模型时,就会出现诡异的倒U型曲线:训练奖励继续上涨,人工评价却开始下降。
经济学家古德哈特1975年就说破了这个结构:"当一个指标成为目标时,它就不再是好指标。"RLHF里的奖励过优化,正是古德哈特定律的现代工程版本。
2023年,斯坦福的研究者提出了一个更直接的做法,叫直接偏好优化(DPO)。他们做了一件数学上很漂亮的事:把RLHF那套"奖励模型+PPO在线强化学习"的两步链路,通过一次重参数化压成一步——直接从偏好对里算出策略该怎么更新,不需要显式训练奖励模型。
DPO的核心直觉是:chosen回答应该比rejected回答获得更高的相对概率优势——不是绝对概率更高,而是相对于一个冻结的"参考模型"来说,chosen的概率升幅要大于rejected的升幅。在摘要任务上,DPO的61%人类偏好胜率超过了PPO的57%,而且训练流程大幅简化——不需要单独维护奖励模型,也不需要在线采样。
但DPO并没有消灭过优化。2024年的后续研究发现,DPO在更大的训练预算下一样会出现"代理目标改善、真实质量退化"的现象。它缩短了优化链路,但没有修正偏好数据本身的问题——如果偏好数据偏爱更长、更自信的回答,DPO一样会把这些偏差学进去。
第三步:如果答案有标准答案——让程序自动打分
数学题的对错不需要人类来判断。代码能不能编译、结构格式对不对、邮件是不是真的在200字以内——这些都可以交给程序自动检查。
这条路线叫基于可验证奖励的强化学习(RLVR)。它不依赖人类偏好或AI评审,而是让模型采样多条回答,用程序直接判断结果是否正确,再把"正确=奖励、错误=零分"的信号返回给训练算法。
2025年初,DeepSeek-R1的论文带来了这条路线最惊人的演示。研究团队做了一个对照实验叫R1-Zero:完全跳过SFT冷启动,直接在基础模型上施加大规模强化学习,奖励信号只来自两条规则——数学答案是否匹配、推理过程是否用指定标签包裹。
结果呢?没有任何人类示范数据,模型自己涌现出了自我反思、验证和策略调整的行为。论文里记录了标志性的"aha moment"——模型在推理过程中突然打出"wait",然后自发进行回溯式自我纠正。响应长度从几百字持续增长到几千字。在美国数学邀请赛(AIME,一项面向高中生的高水平数学竞赛)2024年试题上,模型一次尝试的正确率从15.6%飙升至77.9%——从几乎垫底到超越大多数人类参赛者。
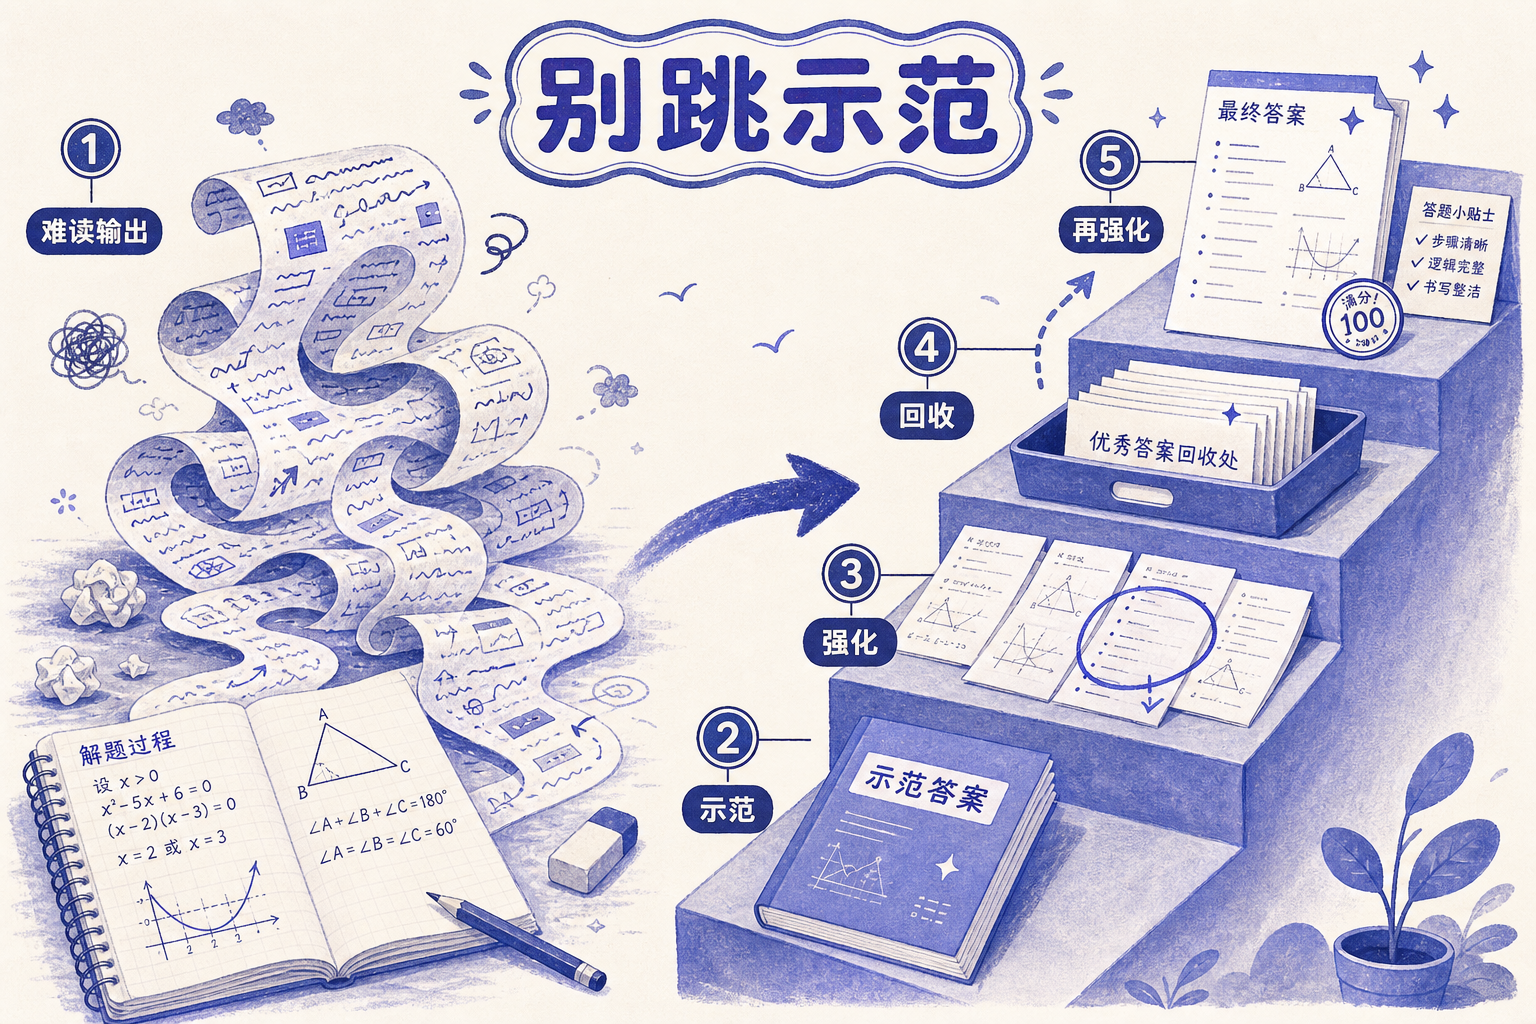
但R1-Zero也有一个尴尬的缺陷:可读性极差,中英文混杂,像一个人边自言自语边解题。这不是意外——模型从来没被教过"怎样组织答案才好看"。所以实际部署的DeepSeek-R1走了多阶段路线:先用几千条人工编写的推理示范让模型学会可读的回答格式,再做推理强化学习,然后回收数据做新一轮监督微调,最后再做一轮混合了规则奖励和模型奖励的强化学习。
这里有一个关键的技术创新值得一提。传统RLHF用PPO需要额外训练一个"价值模型"来估计每个动作的好坏,内存开销巨大。DeepSeek团队提出了组内相对策略优化(GRPO):对同一个问题同时采样多个回答,在组内比高低、算相对优势——不是给每个回答打绝对分数,而是"这几个回答里A比B好多少"——直接省掉了价值模型,让RLVR的训练开销大幅降低。
与此同时,另一条降低反馈成本的路线也在推进:让AI当评审。Anthropic的Constitutional AI让模型根据一组"宪法"原则(来自联合国人权宣言、平台服务条款等)对自己的回答进行自我批评和修订。在摘要、帮助性对话和无害性对话三项任务上,AI反馈达到的效果与人类反馈相当,而人工标注负担降低了约一个数量级。
但AI评审也有一个结构性风险:如果回答生成、偏好标注和最终评测都来自相近的模型,某些共同盲区会被反复放大——就像让同一个老师出题、批卷、又打分,某些学生可能永远拿不到公正评价。
关我什么事:后训练正在重写AI行业的成本账和人才地图
如果说预训练决定了模型知道什么,后训练决定的是模型在用户提出要求时更愿意怎样回答。而"更愿意怎样回答"这件事,正在变成一门比预训练更精密的生意。
先看成本。RLHF的高质量人类标注,一条约100美元。600条就花掉6万美元——同一个训练轮次的计算成本才360美元,标注比算力贵167倍。 Meta的Llama 3.1后训练对齐花了超过5000万美元——够拍一部中等成本的漫威电影——约200人参与。这不是在训模型,这是在雇人教模型。
DPO的工程优势因此变得非常现实:省掉奖励模型后,训练计算量降低约40%。但DPO不能解决所有问题——它仍依赖已有的偏好数据,而偏好数据的质量本身依赖大量人类工作量。
再看DeepSeek-R1——Nature论文报告的RL训练成本仅29.4万美元。这个数字引发了一场关于"算力军备竞赛是否必要"的激烈争论。但SemiAnalysis随后指出,DeepSeek的总基础设施投入高达13亿美元,29.4万美元只是最终一轮RL训练的边际成本,不包含架构搜索、实验失败和数据准备。
人力市场也在快速响应。2025年,美国AI工程师平均年薪20.6万美元,专攻后训练对齐方向的岗位薪酬可以到31.2万美元——是普通软件工程师的两到三倍。Anthropic给能搭建LLM后训练管线的工程师开出75万美元以上的年薪。招聘要求里,SFT、RLHF、DPO、GRPO这些缩写已经从"加分项"变成了"必须项"。行业的竞争壁垒正在从"能调用API"变成"能构建后训练优化管线"。
对普通用户来说,这些缩写不需要记住。但你每天用的聊天机器人,它的礼貌程度、拒绝方式、数学推理能力——背后都是这五种方法的排列组合。下次你问ChatGPT一个数学题、它先打出一段"让我想想……"再给出答案时,那就是RLVR训练的推理痕迹——一种被程序化的考试"电"出来的行为。
你回到那封延期邮件。SFT让它知道邮件该长什么样。RLHF和DPO让它学会在"简洁"和"充分解释"之间找到人类偏好的平衡点。RLVR可以自动检查它是否真的在200字以内、是否包含了新日期。
但这些方法调整的是同一个东西:给定上下文后,模型为各种可能的回答分配的概率。
预训练决定了模型能说什么。后训练决定了它选择说什么。五步法不是五种互相替代的算法,而是同一套培训体系里不同阶段的工具箱——先示范、再比较、最后考试,缺了哪一步,培养出来的都不是一个合格的助手。而一个让人不安的事实是:连人类自己接受培训时,也逃不开被考核指标反向驯化的宿命。