2026年9月,Claude Code 的发明者 Boris Cherny 发了一条帖子,技术圈瞬间炸了:他用 AI 写了几个 TLA+(一种用数学逻辑描述并发系统、自动查找设计漏洞的语言)规范,模型自动发现了 16 个竞态条件 bug——多个操作抢同一块资源时出现的随机时序漏洞。一时间,"形式化验证将拯救 AI 写代码"成了最热的论调。
但这股乐观有一个致命的盲点。
TLA+ 确实能查出"两个进程不会同时进临界区"——但它永远回答不了"节能模式是不是真的比普通模式省电"。这不是工具没做好,而是它的逻辑语言在设计之初就把这类问题排除在外了。理解这道边界,比学会写 TLA+ 本身重要一百倍。
TLA+ 到底在检查什么?——一卷只能逐帧回放的录像带
要理解 TLA+ 能做什么、不能做什么,你先得搞懂它是怎么看世界的。
TLA+ 把整个系统想象成一卷录像带——从启动那一刻开始拍,一帧一帧记录下每一瞬间的状态,一直拍到停止。每卷完整的录像带就叫一个"行为"。系统所有可能的运行方式,就是所有可能的录像带的总和。
TLA+ 的逻辑只做一件事:把一卷录像带从头到尾放一遍,在每一帧上检查某个条件是否成立。它手里只有三张检查标签:
第一张叫"永远"(□P):从当前帧往后,每一帧里 P 都为真。比如"任何时候都不会有两盏绿灯同时亮",就是 □(绿灯数≤1)。这类"坏事永远不会发生"的属性,叫安全性。
第二张叫"下一帧"(P'):紧接着的下一帧里 P 为真。比如"灯从绿变红",就是 灯="绿" ∧ 灯'="红"。把"永远"和"下一帧"组合,就能描述动作——每一步跨出去,系统是不是按规则来的。
第三张叫"终将"(◇P):当前帧或未来某帧,P 终将为真。比如"四号灯终将变黄",就是 ◇(灯4="黄")。但这太弱了——"终将"不等于"一定会"。真正有用的用法是组合:□◇P 表示"从任何一帧往后看,P 至少还会再出现一次"——这叫"反复出现",可以描述故障恢复。□(P ⇒ ◇Q) 表示"一旦 P 成立,Q 就早晚会来"——这叫"导致",可以描述"每条发出的消息终将被接收"。这类"好事终将发生"的属性,叫活性。
安全性 + 活性,这就是 TLA+ 的全部武器库。事实上,计算机科学家在 1985 年就已经严格证明:任何你能写进一卷录像带的系统属性,都可以拆成"安全性 ∧ 活性"两块。
而问题恰恰从"任何你能写进一卷录像带"这个前提开始。
那么,审查员能同时放两卷录像带吗?
现在请你想象一个非常普通的需求:你设计了一部手机,它有一个"节能模式"。你想验证——"节能模式下,手机做任何操作消耗的电量,都不超过普通模式下做同样操作消耗的电量。"
你把节能模式写成了一卷录像带,把普通模式写成了另一卷。TLA+ 可以逐帧检查第一卷,也可以逐帧检查第二卷。但它永远不能同时把两卷带子并排播放、逐帧对比——TLA+ 的逻辑只认识一卷录像带内部的帧与帧之间的关系。跨录像带的比较,不在它的语法里。
计算机科学家给这类属性起了个名字,叫**超属性**——它不是对某一卷录像带的判断,而是对"系统所有可能录像带的集合"的判断。
听上去很小众?恰恰相反。你每天遇到的最重要的软件属性,很大一部分都是超属性。一个银行系统能不能防止黑客通过观察响应时间推测密码——这是信息流安全,需要比较"输入正确密码"和"输入错误密码"两条时间线的可观察行为是否相同。一个云服务的合同承诺——"95% 的请求在 5 毫秒内响应"——这是统计属性,需要把所有请求的响应时间汇集起来算分布。一个游戏能不能被玩家打通——这是可达性,需要回答"在所有可能的录像带中,是否存在一条,主角走到了终点"。
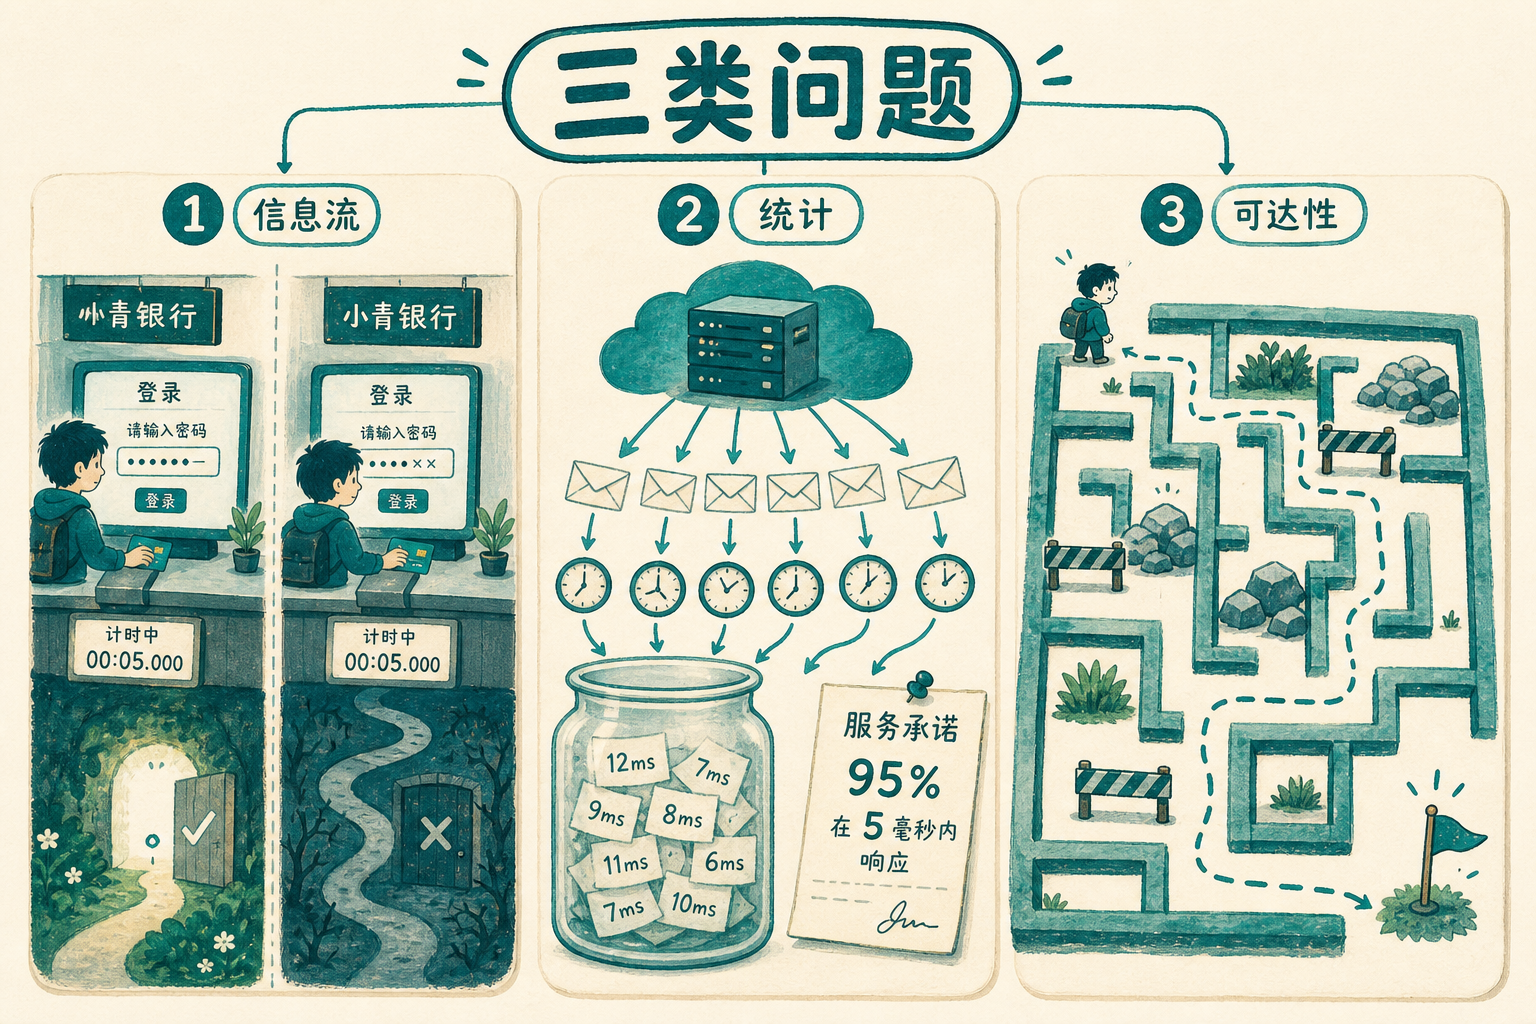
以上三个,TLA+ 一个都表达不了。不是"表达起来很麻烦",而是在它的逻辑语言里根本就不存在能表达这类判断的句子结构。TLA+ 的发明者 Leslie Lamport 在 1998 年就讨论过可达性问题,他的结论很直白:作为系统正确性属性,"存在一条路径能到达 P"没有意义;你只能用它做规格的健全性自查——看看你的规格有没有不小心把一切路都堵死了。
TLA+ 的自动验证工具 TLC 后来悄悄加了一个 REACHABLE 关键字,勉强能覆盖最基本的"从初始状态能不能到达某处"。但要从任意状态出发判断可达性,TLC 至今做不到——算法本身需要反向搜索,还没有实现。至于超属性和概率属性,TLC 连"勉强"都谈不上。
这张地图,还有哪些地方画不出来?
到这里你可能会问:那我用别的工具行不行?
行,但每换一个工具,你就要付出对应的代价。
如果你想要查可达性——"是否存在一条路径到达 P"——可以用 CTL(计算树逻辑)。CTL 天生支持"存在一条未来路径"这类量化,但代价是它表达不了公平性。而公平性几乎是所有并发系统的基础——"如果某个进程无限次请求进入临界区,它就必须无限次被允许进入"。CTL 写不出这样的句子。
如果你想要查概率——"系统在 100 步内出错的概率小于 10%"——可以用 PRISM(概率模型验证器)。它的专用语言原生支持概率量词和期望奖励。代价是:PRISM 能处理的状态数远不如 TLC 庞大。多一种表达能力,模型检查的复杂度就炸一次。
TLA+ 社区也不是没有应对。他们发明了各种"黑客技巧"——用辅助变量把历史状态全部存下来,把多步属性伪装成不变式;用"自组合"把两卷录像带的规范缝成一卷,把超属性伪装成普通的安全性。但这些技巧——用原文作者 Hillel Wayne 的话——"依然是 hack"。辅助变量会毁掉规范之间的层次关系、让模型不再清晰对应真实系统,自组合会让状态空间指数爆炸,而且这些 hack 彼此之间不兼容。你没法同时用辅助变量模拟多步属性、又用自组合模拟超属性、又用公平性构造模拟可达性——每一种补丁都在挤压其他补丁的生存空间。
这里有一道更深层的回响。1931 年,哥德尔证明了任何足够强的数学系统都存在不可证的命题——你可以在系统内把它写出来,但无法在系统内证明它。换一个更强的系统,更强的系统会有它自己的不可证命题。"表达力越强,有效性越弱——不完备性这个疙瘩可以被推来推去,但它永远不会消失。"芬兰逻辑学家 Väänänen 的这句话,恰好也适用于 TLA+ 的处境:你可以用 hack 把盲点从一个位置推到另一个位置,但你消除不了它。
AI 能写规范了,然后呢?
回到那条引爆互联网的帖子。Boris Cherny 用 Claude Opus 写 TLA+ 规范,找到了 16 个 bug。他很诚实:他自己并不熟悉 TLA+,全是 AI 写的。
但 2025 年一篇 SysMoBench 基准测试揭示了一个更微妙的问题:大语言模型生成 TLA+ 规范的语法正确率接近 100%,但对真实代码的语义符合率只有大约 46%——也就是说,AI 写出的规范看起来完全正确,但它描述的系统和你真正在运行的代码之间,有将近一半的概率存在裂缝。安全属性的违反率 8.3%,活性属性的违反率高达 41.9%——大模型在时序推理上明显薄弱,写出的"好事终将发生"里头,近一半是假的。
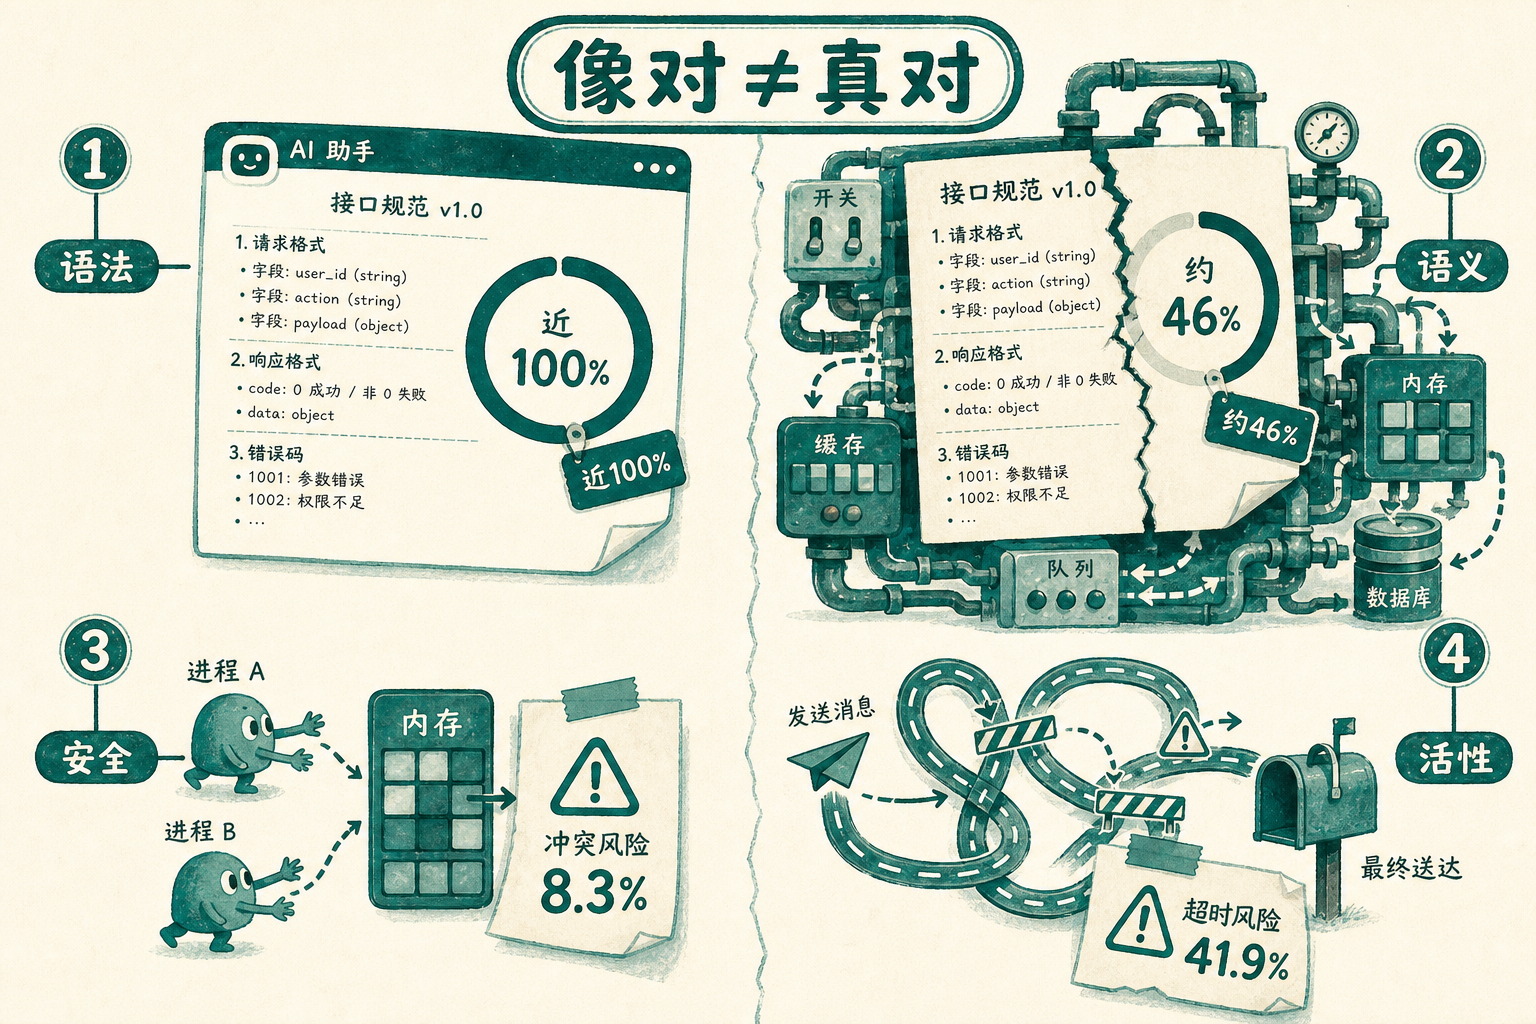
这道裂缝不是 TLA+ 的问题,也不是 AI 的问题——它是"把世界抽象成数学"这件事本身的代价。规范的正确性永远只对规范成立,不对代码成立。正如一位形式化验证公司的博客所写:"让 AI 写证明。但不要让它在无人审查的情况下,独自决定证明的是什么。"
历史上,这道裂缝的代价是血淋淋的。1985 到 1987 年,Therac-25 放射治疗机造成六人过量辐射伤亡——原因之一正是软件复用了旧机型代码,但删除了硬件安全联锁,而安全分析报告把"残余软件错误"的概率随手写成了 10⁻¹¹——也就是一百亿分之一,相当于连中两次彩票头奖的概率,没有任何依据。1996 年,阿丽亚娜 5 号火箭首飞 37 秒后爆炸——惯性导航软件从阿丽亚娜 4 号复用而来,但新火箭的水平速度大了五倍,一个 64 位浮点数转 16 位整数的溢出没人预料到。调查结论只有一句话:"规范与设计错误——规范未覆盖新的飞行包线。"
这些灾难都不是因为"检查工具不够强"。它们是因为规范本身就没覆盖到出问题的那个维度。TLA+ 查不出的不只是超属性和可达性——它查不出的,首先是"你忘了写进规范的那些东西"。
对正在使用 AI 辅助编程的开发者来说,最有用的不是学会写 TLA+,而是理解它的边界:如果你想验证"两个进程会不会同时写同一块内存",TLA+ 是好工具。但如果你想验证"这个系统在 99% 的情况下响应时间低于 10 毫秒",你需要的是完全不同的武器——甚至,目前还没有武器能真正做到这一点。而如果你想验证"这个 AI 写的代码没有引入我没预料到的行为"——那不是一个工程问题,那是一个哲学问题。
地图画得再精细,也不是疆域本身。 有时候,疆域里最重要的东西,恰好是地图的语言画不出来的。