你写了一个计算器语法。1 + 2 + 3——三个数字、两个加号。解析器跑完,你想让它在打印"开始加法"之后,再逐个打印每个数字。听起来再合理不过:先宣布"要算加法了",再处理每个操作数。
但如果你用的是 Bison 或 Yacc——这些统治了编译器世界半个世纪的 LALR(1) 解析器生成器——你做不到。
它们的规定很死:每个语法规则的语义动作(也就是你写的代码),只能在该规则被完全匹配、子规则全部执行完之后才运行。翻译成人话:孩子永远比父亲先开口。想先让父规则说句话?抱歉,算法从根本上就不允许。
这不是设计疏忽,而是 LALR(1) 自底向上解析的物理规律。
为什么传统解析器里,"父亲"永远后开口?
LALR(1) 这个名字看起来像密码,拆开就清楚了。L 是从左到右读输入。R 是从语法树的最右侧开始"归约"。1 是只往后看一个词(行话叫 token)就做决定。核心动作只有两个:移进和归约。
可以把解析器想象成一个建筑工人。他从地基开始,每看到一个砖块(token),就往脚手架上码——这就是移进;码到某一块,发现"这组砖恰好构成一个完整的语法单元"——比如一个数字、一个表达式——就把这组砖拆下来,换成一块更大的预制板——这就是归约。预制板本身又可以和别的砖一起,再次被归约成更大的单元。就这样从下往上、从小往大,最终把所有砖块归约成一整栋楼。
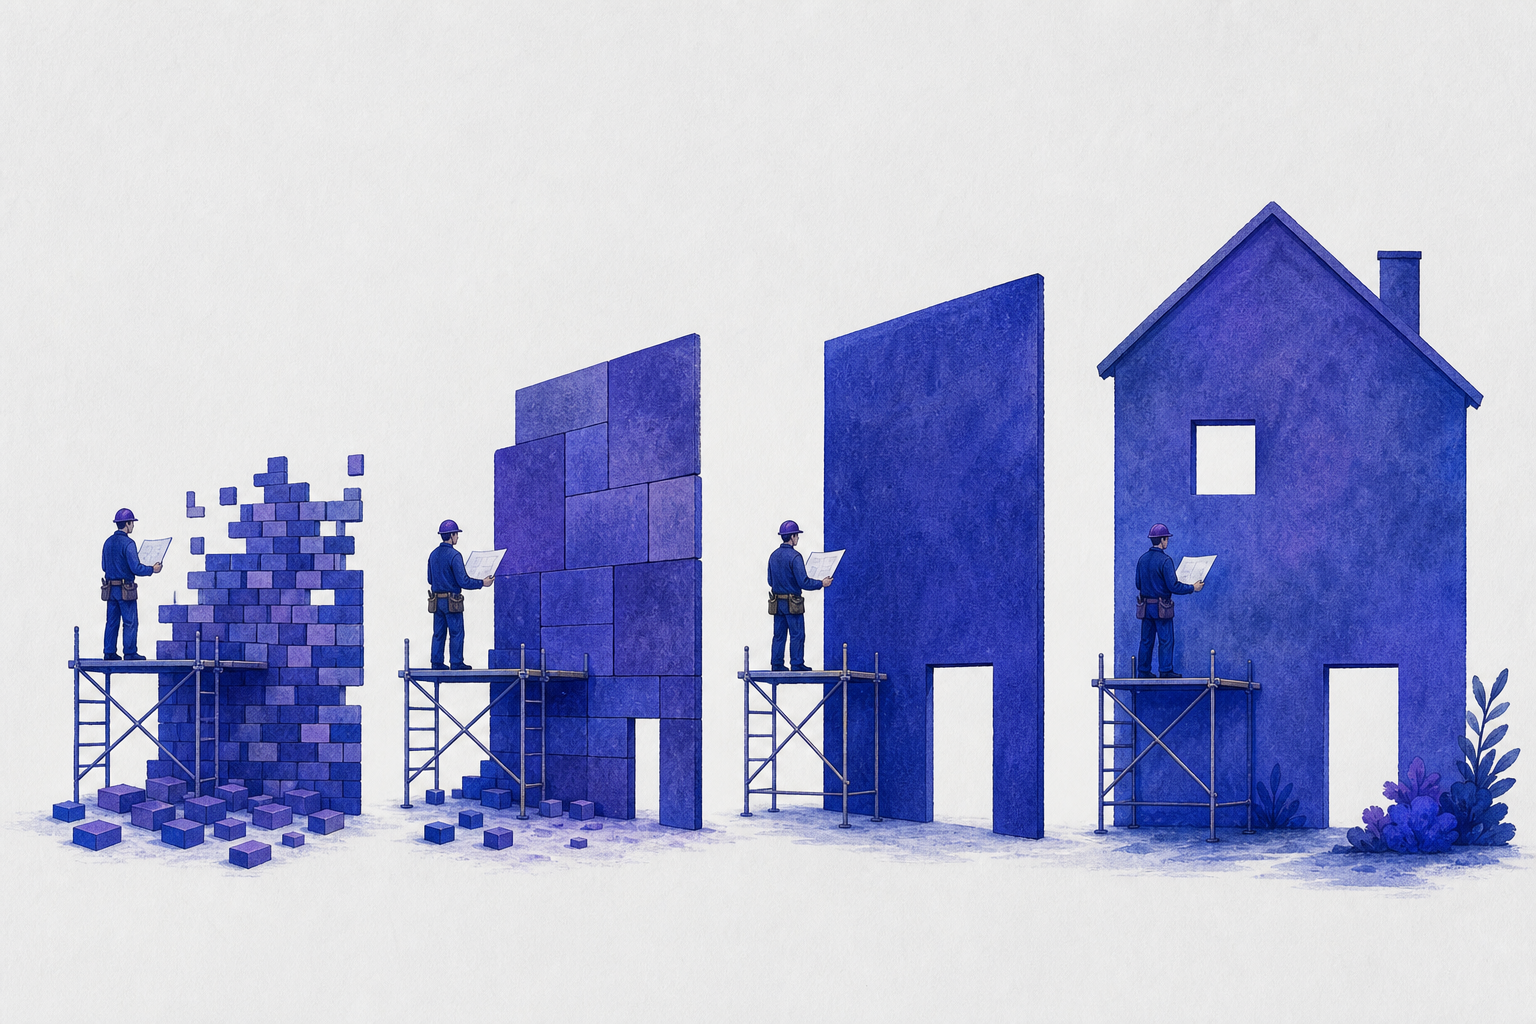
问题在于,Bison 和 Yacc 把语义动作绑死在了归约这一步。归约的瞬间,那组砖刚变成预制板,你的代码就得立刻跑——计算语义值、存入解析栈,供上层归约使用。子规则全跑完,父规则才归约;父规则归约时,父动作才执行。父子顺序就这样被算法锁死了。
这正是 Yacc 作者 Stephen C. Johnson 在 1975 年的原论文里承认的限制:想要"父先于子"的顺序,只能手工建一棵抽象语法树(AST)——也就是把源代码结构化之后形成的那棵"楼"——再写一个独立的遍历器,分两趟完成。几十年来,编译器工程师用 mid-rule action——在规则匹配到一半时强行插入一段代码,本质是偷偷塞进一个匹配空串的虚拟规则——来勉强绕过。Bison 手册自己都警告:"在规则完全识别前采取动作,常常引发冲突。"
先把整栋毛坯房盖好,再从上往下装修
Yantra 的做法简单到让人觉得"为什么不早这么做"——它把 LALR(1) 的解析过程拆成了两趟。
第一趟:照常用自底向上的移进-归约算法解析整个输入,但它不执行任何语义动作。它只是安安静静地把整棵 AST 建好——每个节点、每条边、完整地放在内存里。
第二趟:AST 建完之后,Yantra 启动一个自顶向下的遍历器(walker),从根节点出发,逐层向下访问。语义动作挂在这个遍历器上——于是父规则的动作天然就在子节点之前执行了。
这就像建筑里"先盖毛坯房、再统一装修"。传统 Bison 系工具是盖一层装修一层——砌到三楼时,三楼的电线已经埋好了,但你还不知道四楼会是什么,也改不了一楼的布线。Yantra 等整栋楼的框架全部立起来,再从顶层逐层往下规划:先决定"这层是主卧区",再分配每间房的功能。
从算法角度看,这是一个"借力打力"的设计。ANTLR——目前最流行的解析器生成器之一——也能做到先父后子,但那是 LL(*) 自顶向下解析算法天然附赠的:它从根向叶子逐层展开,父节点本来就在子节点之前创建。ANTLR 的代价是算法在最坏情况下可能退化到 O(n⁴)——输入长度翻倍,运行时间暴涨 16 倍——且生成器本体需要 Java 运行时,C++ 项目用它会拖进一个 Java 虚拟机(JVM)依赖。
Yantra 用 LALR(1)——一种严格线性时间的解析算法——却获得了 LL 系才有的自顶向下遍历体验。官方文档的总结很精准:"keeping LALR(1)'s bottom-up construction, and all the time and space efficiency that comes with it, while still giving you a top-down walking experience."更妙的是,同一棵 AST 可以挂多个 walker。一份语法文件声明 %walkers CppWalker JavaWalker;,就能用同一棵解析树分别生成 C++ 和 Java 代码——这在 Bison 系里需要手写 AST 类和每种目标语言的遍历器。
"先父后子"到底能做什么?
这个问题不是学术洁癖。真正需要父先于子的场景贯穿编译器前端到后端。
最典型的是符号表构建。编译器在分析代码时,需要一张表来记录"当前作用域里有哪些变量"。传统 LALR 工具处理嵌套作用域时非常尴尬:子语句体解析完了,才能执行外层语句块的语义动作来声明作用域——但子语句解析时早就需要查符号表了。Yantra 让外层先跑:先创建一个新作用域、压入符号表栈,然后子节点遍历时就能正常查表。
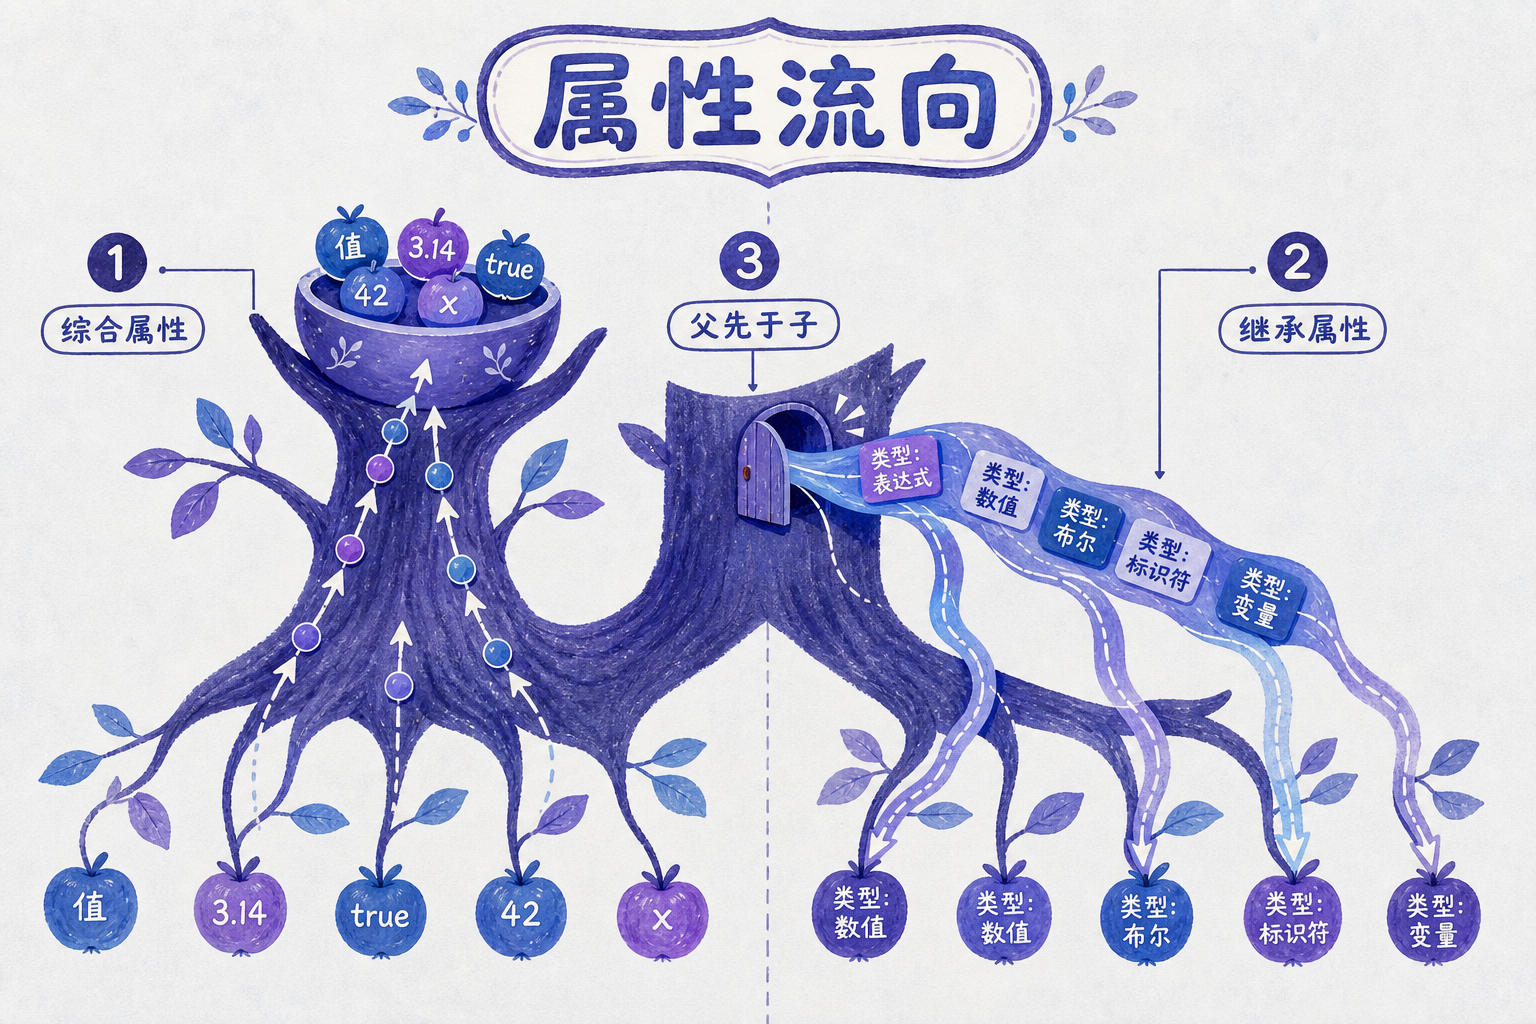
更深一层的原因藏在属性文法里。计算机科学先驱 Donald Knuth 在 1968 年定义了两种属性:从子节点汇总给父节点的叫综合属性——比如表达式的值,只能等子节点都算完才能汇总;从父节点传给子节点的叫**继承属性**——比如某个变量在当前作用域下的类型,必须由父节点先告诉子节点。LALR 归约时执行动作天然只支持综合属性,因为归约时所有子节点已经求值完毕。继承属性需要一个父先于子的信息流,这正是 Yantra 的遍历顺序所解锁的。
在实际代码生成中,这个顺序也省去了大量样板代码。ANTLR 的 listener 模式提供了 enter 和 exit 两个回调——本质也是先父后子——让你在进入一个函数节点时先发函数头,遍历完所有语句退出时再发函数尾。Yantra 用一个更干净的方式做到了同样的事:父规则的动作运行完毕,再自动调用各子节点的遍历。
还有一个更隐蔽的价值:同一棵 AST 可以给不同后端用。设想你在写一个领域特定语言(DSL)的编译器,需要同时输出 C++、WebAssembly(WASM)和文档。传统工具里,你得在归约时一次性决定所有输出;Yantra 里,三个独立的 walker 共享一棵 AST,各自按自己的节奏遍历和输出。SQLite 的作者 D. Richard Hipp 对此心知肚明——他写的 Lemon(Yantra 自称的直接灵感来源)同样使用 LALR(1) 并在归约时执行动作。SQLite 内部的 SQL 解析产出的 AST 立刻被扔掉,换成一套字节码程序通过独立的虚拟机来执行——本质上也是"解析和执行拆成两趟",只不过拆在两个不同的子系统里,而 Yantra 把它内建在了解析器生成器本身。
代价:整栋楼的钢筋都得留在工地上
先建完整 AST 再遍历不是免费的午餐。
第一个代价是内存。Bison 式的归约即执行可以在解析过程中丢弃不需要的子树——归约完一个子表达式,语义值算出来压入栈,中间节点就可以释放了。Yantra 必须把整棵 AST 完整地保留在内存里直到遍历结束。一个已知案例:一种常见实现中,36.8 MB 的 C++ 源码生成的 AST 膨胀到了 785 MB——大约 20 倍的内存开销,相当于一本薄册子被撑成了一整面墙的档案柜。虽然实际比例因实现而异,但"整棵树常驻"的物理约束是绕不开的。
第二个代价是错误处理。Yantra 目前遇到语法错误直接终止——没有错误恢复、没有增量重解析。相比之下,tree-sitter 专为编辑器打造的增量解析可以在你每敲一个字符时只重解析受影响的最小区域。Yantra 明确表示这不是它的赛道,但对于需要流式处理长输入(比如 socket 数据)的场景,"先建完整 AST"的假设本身就变得脆弱。
第三个代价是成熟度。Yantra 是一个 pre-1.0 的单人项目,和 ANTLR 二十年的社区积累、Bison/Yacc 半个世纪的检验相比,它还没经过大规模工程的捶打。官方文档坦率地列出了已知限制——没有错误恢复、没有增量重解析。
但或许最值得注意的,不是 Yantra 现在缺什么,而是它证明了什么:LALR(1) 的线性效率,和"先父后子"的遍历自由,从来就不矛盾——只是之前没人把它们装进同一个工具里。对写编译器、解释器、或者哪怕只是"需要一个可靠解析器"的 C++ 开发者来说,Yantra 用一个 CMake、零外部依赖、二十行语法文件,就能拿到一棵完整 AST 和一个可自定义遍历顺序的 walker。它还远不是成熟的生产力工具——但它把"解析和行动分离"这条已被数据库、编译器、图形学反复验证过的工程原则,第一次干净地带进了 LALR(1) 的世界。
把树先种好,再决定怎么爬——这个顺序,晚了五十年,但总算来了。