七个芯片,花不了几个钱,接上几根导线。
然后你给它一段话,它真的会接下去写——每个字要等九秒钟,写出来的东西有时前言不搭后语,但它确实在"思考"。
这不是科幻。一位开发者用七个ESP32-S3微控制器——就是智能灯泡和温湿度传感器里常见的那种几美元芯片——搭了一个集群,跑通了一个5亿参数的大语言模型。项目完全开源,任何人照着接线图和烧录指南都能复现。
在硅谷技术社区Hacker News上,这条消息炸了锅。
人们兴奋的不是它快——它慢到令人发指——而是"居然能跑"这四个字捅破了一层窗户纸:大语言模型的推理,原来不一定需要英伟达的显卡。
两个关键突破撑起了这个项目:把权重压到只取-1、0、+1的极致"减肥手术",和把模型切成薄片、让七个芯片接力的"工厂流水线"。缺一个都不行。
为什么把权重砍到只剩-1、0、+1,模型居然没傻?
要理解这件事为什么不可思议,先要知道大语言模型怎么做计算。
一个5亿参数的Transformer模型——就是ChatGPT背后那种神经网络架构——内部塞满了矩阵乘法:把输入的数字和模型里存着的海量权重数字两两相乘再加起来。一次推理要做的乘法,数以亿计。英伟达的显卡就是为这种浮点乘法而生的。但ESP32-S3呢?它的片上高速内存只有512KB——连模型文件的一个零头都装不下。给它扔一个标准半精度浮点(FP16)格式的0.5B模型,别说跑起来,连门都进不去。
所以第一刀,砍在权重本身上。
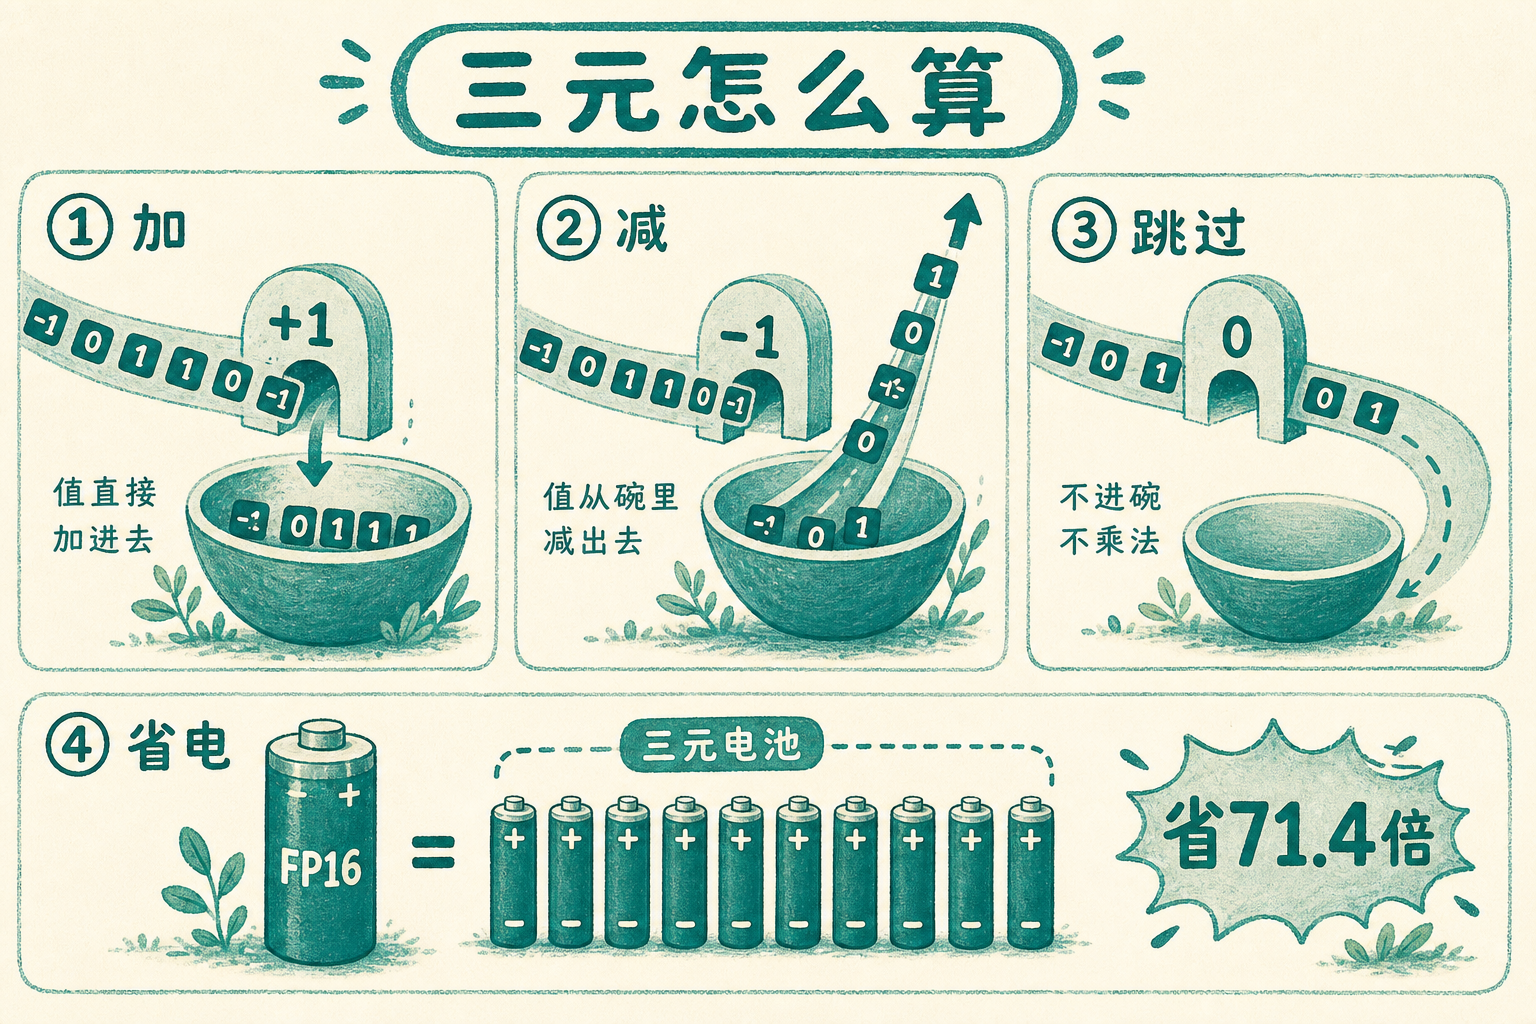
2024年2月,微软研究院发表了一篇论文,标题大胆得不像学术文章:《1-bit大语言模型时代:所有大语言模型都在1.58比特》。核心思想简单到令人不安:把每个权重压缩成只有三种状态——-1、+1,或者0。
矩阵乘法,这个深度学习最核心的计算,突然退化成了一道加减法题。权重是+1?把对应的输入数字加进来。权重是-1?减出去。权重是0?跳过不看,连算都不用算。浮点乘法被彻底消灭了。论文数据显示,在7纳米芯片上,同样的矩阵运算,三元权重比半精度浮点省了71.4倍的能量——相当于原来跑一次的电,现在能跑七十多次。
但压缩得这么狠,模型不会变笨吗?
这里藏着一个反直觉的事实。传统的模型量化——把训练好的高精度模型压成低精度整数格式(比如INT8、INT4)——是"事后减肥":模型本来在浮点世界里学会了走路,你突然把它的腿锯短,它当然踉跄。但三元量的做法不一样:模型从训练第一天起,就知道自己的权重只能取-1、0、+1。它在三元世界里出生、长大、学会了所有的语言能力。这不是压缩,而是把游戏规则从一开始就改了——相当于让一个孩子生下来就只用三条指令学说话,而不是先学会钢琴再砍掉琴键。
当然,"天性三元"有一个现实门槛:参数规模在30亿以下时,三元模型的性能会明显弱于同规模的浮点模型。直到30亿以上才能追平甚至反超——这套方案叫BitNet。而这个ESP32集群跑的5亿参数模型,恰好落在"吃亏区间"里——这也是它输出内容经常像胡言乱语的原因。
但性能缺口是训练规模的问题,不是原理的问题。原理上,这门"减肥手术"已经证明了:大语言模型不需要浮点精度也能学会说话。
那么问题来了:就算权重压缩了,一个5亿参数的模型仍要占近100MB的存储。一颗ESP32-S3的片外扩展内存,满打满算才16MB——六分之一都装不下。怎么办?
七个芯片首尾相接,把模型变成一条"流水线"
答案是把模型切成薄片,让多个芯片像工厂流水线一样接力工作。
七个ESP32-S3芯片的排布是这样的:一个当"总控",另外六个当"工人"。总控负责接收用户输入、把文字切成最小单元——专业上叫分词——然后查一张14MB的嵌入表(相当于一本把每个词元翻译成数字向量的字典),把每个词元变成一个896维的数字向量。这个向量,就是流水线上的"第一件半成品"。
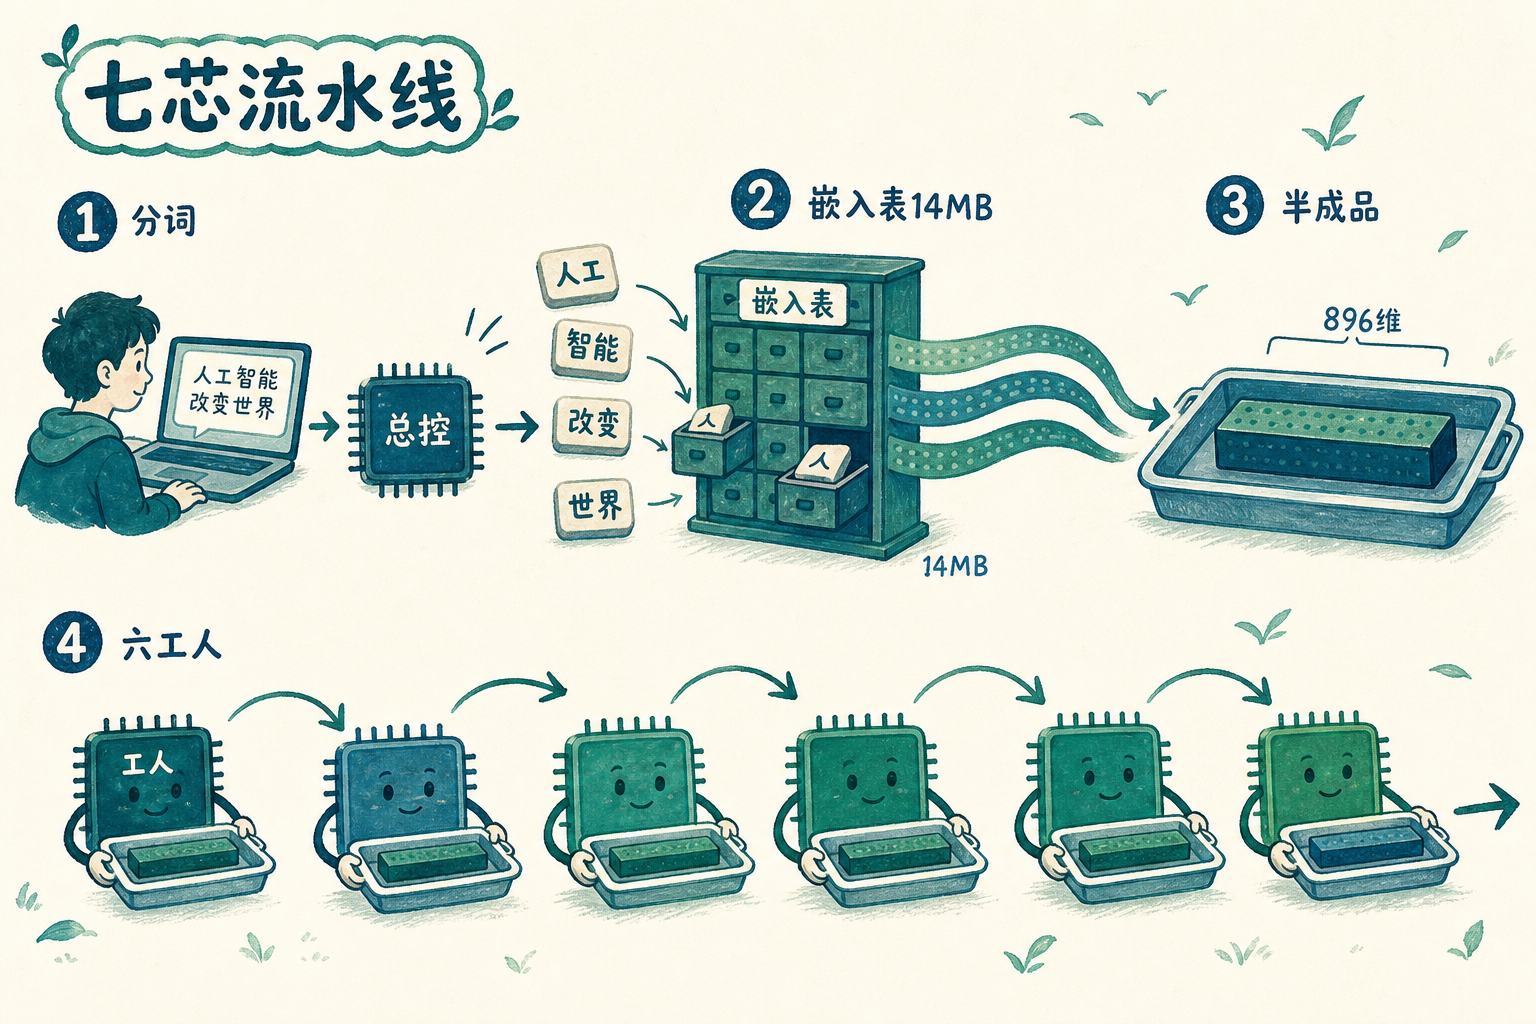
半成品通过一根高速串行通信线——以每秒约10兆比特的速度——传给第一个工人节点。工人节点上烧录了4层Transformer的参数,大约15MB,恰好塞进一颗芯片的闪存里。它在这四层里做完注意力计算、前馈网络推演、再加上旋转位置编码——总之,把半成品加工得更"懂了上下文"一点——然后传给下一个工人。
第二个工人接着做接下来的4层。第三个再做4层。一直传到第六个工人,做完第20到23层。
最后,加工完成的向量沿同一条线原路返回总控。总控做最后的归一化,再把它映射回词表里的某个词元。一个词元(token)就这样被吐出来了。
整个过程,像极了一条微型汽车装配线:第一个工位装底盘,第二个工位装发动机,第三个装车身——每个工位只负责自己那段工序,做完就推给下一站。
但装配线快,是因为每个工位同时在干活。而这条芯片流水线,同一时刻只有一个工位在工作——数据必须从头传到尾,上一个工位算完,下一个工位才能开始。这就是流水线并行的天然软肋:吞吐量受制于最慢的那一环。
在这个项目里,每颗芯片处理4层Transformer大约需要1.3秒,整条链七个节点首尾串联,一个token走完全程大约9秒。如果你问它一个问题,等它回复两个字的时间,足够你去泡一杯手冲咖啡。
9秒一个字。这是事实,也是这个项目最诚实的注脚。
从云端坠落到芯片级,谁会先吃到甜头?
这件事离普通人的生活,比你以为的更近。
苹果、高通、Arm的最新芯片都已经支持在手机甚至微控制器上本地跑小型语言模型——这不是未来,是正在发生的事。一个更直观的数字:据行业预测,到2030年,在传感器、手表、耳塞里的微型芯片上跑AI的TinyML设备,年出货量将达25亿台。你身边每多一个"智能"设备,背后就可能多一颗在本地默默推理的小芯片。
这些数字背后的推手不是"更快",而是三个更朴素的需求:隐私、离线、零延迟。高通的官方博客有一句话切中要害:"端侧AI天然保护用户隐私,因为你的提问和个人信息自始至终都留在设备上。"
ESP32集群这种级别的东西当然不会出现在手机或手表里——它的性能差了三个数量级。但它指向一个方向:当模型的"体重"可以被打包到极致时,AI推理就不再是云端GPU的专利。一个智能门锁可以本地理解你的语音指令,一个农业传感器可以在离线状态下回答农民的问题——微软已经在印度用Phi-3(一个为手机和边缘设备优化的小模型)做了类似的农业助手App。
更值得关注的是,这个方向上的核心突破——原生三元训练——目前还停留在学术和开源社区层面。微软发了论文之后,除了实验室复现,至今没有出现可比的公开顶尖水平(SOTA)模型。Reddit社区里质疑声不断:"小模型本来就塞得进现有的GPU和内存里。大模型要是能用1.58比特训练当然好,但那需要几百万美元的投入。"
这可能是技术方向上的一个岔路口:原生三元模型需要从头训练,等于放弃了过去几年全球砸了数百亿美元训出来的浮点模型"遗产"。是继承遗产继续优化事后量化,还是另起炉灶从头训三元——这条路目前还没有大厂站出来选。
9秒一个字——这条路能走多远?
我们必须诚实面对这个项目的局限。
作者自己在GitHub上坦言,模型只经过了部分训练,损失函数还停留在8.0左右——这个数值高得离谱,意味着模型的输出质量近乎随机。你让它续写一句话,它确实能蹦出几个看起来像人类语言的词,但连起来往往不知所云。
更根本的瓶颈在那条通信线上。SPI——就是前面说的那条高速串行通信线——是同步协议:主节点必须主动发出一个空帧,从节点才能把结果传回来。节点越多,链式延迟就线性增长。有评论一针见血:"瓶颈不在权重,在线。"
而且这些芯片的内存是真正的"一锤子买卖"——512KB的片上高速内存,加16MB的片外廉价扩展内存,没有虚拟内存,没有操作系统帮你Swap。所有东西都必须提前算好、精确对齐、烧录进闪存的固定分区。一个地址错了,整条链的输出就变成乱码。
这让人想起阿波罗登月舱的导航计算机——只有2K内存、36K只读存储,却能把人类送上月球,靠的也是这种"软件提前固化进硬件"的极端设计。但阿波罗导航计算机的全部存储不过36K——而一个5亿参数的语言模型,哪怕压到极致,其规模和复杂度也远超当年的想象。
所以当人们说"ESP32集群跑大模型"时,最诚实的描述是:它在用"登月计算机"的思路,挑战一个规模和复杂度远超出当年太阳系导航的问题。能跑是一回事,跑得好是另一回事。
但别急着关掉这个窗口。九秒一个token,输出经常语无伦次——这些都不是秘密,作者把它们写在了项目首页上。而这个项目之所以值得被认真对待,恰恰不是因为它成功了,而是因为它把"极限在哪里"画了出来:当一个模型能被压缩到只剩加减法、当七个IoT芯片能通过接力完成一次完整的推理——大语言模型就不再是云计算中心的专属奢侈品。
过去治大模型的"富贵病"靠堆GPU,现在有人在试另一种方子:把模型瘦到只剩骨架,让一堆廉价芯片抬着它走。这条路可能走不通。但如果走通了——"跑AI"这个词,就要重新定义了。