你此刻能读到这句话,靠的是一个叫 Redis 的数据库在背后毫秒级地存取数据——从 Twitter 的时间线到 GitHub 的代码仓库,Redis 几乎无处不在。而写出这个数据库的人,叫 Salvatore Sanfilippo,圈内叫他 antirez,一个西西里程序员,2020 年从自己创建的项目退休时留下一句话:"我宁愿被记住是一个糟糕的艺术家,而不是优秀的程序员。"
六年后的今天,他又写了一个程序。这次不是数据库。
他花了一周、每天 14 小时,手搓出一个叫 DS4 的推理引擎——它能在你的 Mac 笔记本上,本地运行一个 2840 亿参数的 AI 模型。这个模型叫 DeepSeek V4 Flash,正常情况下,它需要一整个服务器集群来伺候。
他的理由只有一句话:"AI 太关键了,不能只是一种被提供的服务。"
这句话背后藏着一个反直觉的技术难题,和一个巧妙到让人想拍桌子的解决方案。
2840亿参数,为什么每次只用13亿?
要理解 antirez 做了什么,得先搞懂一件事:为什么一个模型可以有 2840 亿参数,听起来大到离谱,但实际运行时反而不那么"重"?
答案藏在一种叫"混合专家"的架构里。这个名字听起来像智库,实际工作原理也像智库。
想象一座巨大的工厂调度中心。里面驻扎着 256 个专业工位,每个工位擅长处理某一类任务——有的擅长语法分析,有的擅长事实检索,有的擅长逻辑推理。当一份工作单(在大模型语言里叫一个 token——你可以理解成模型读入文本的最小语义单元)进入系统,首先经过调度员——它扫一眼任务内容,判断"这个活儿需要第 3、17、89、142、201、233 号工位",然后只把这 6 个工位叫起来干活。剩下 250 个工位继续待机。
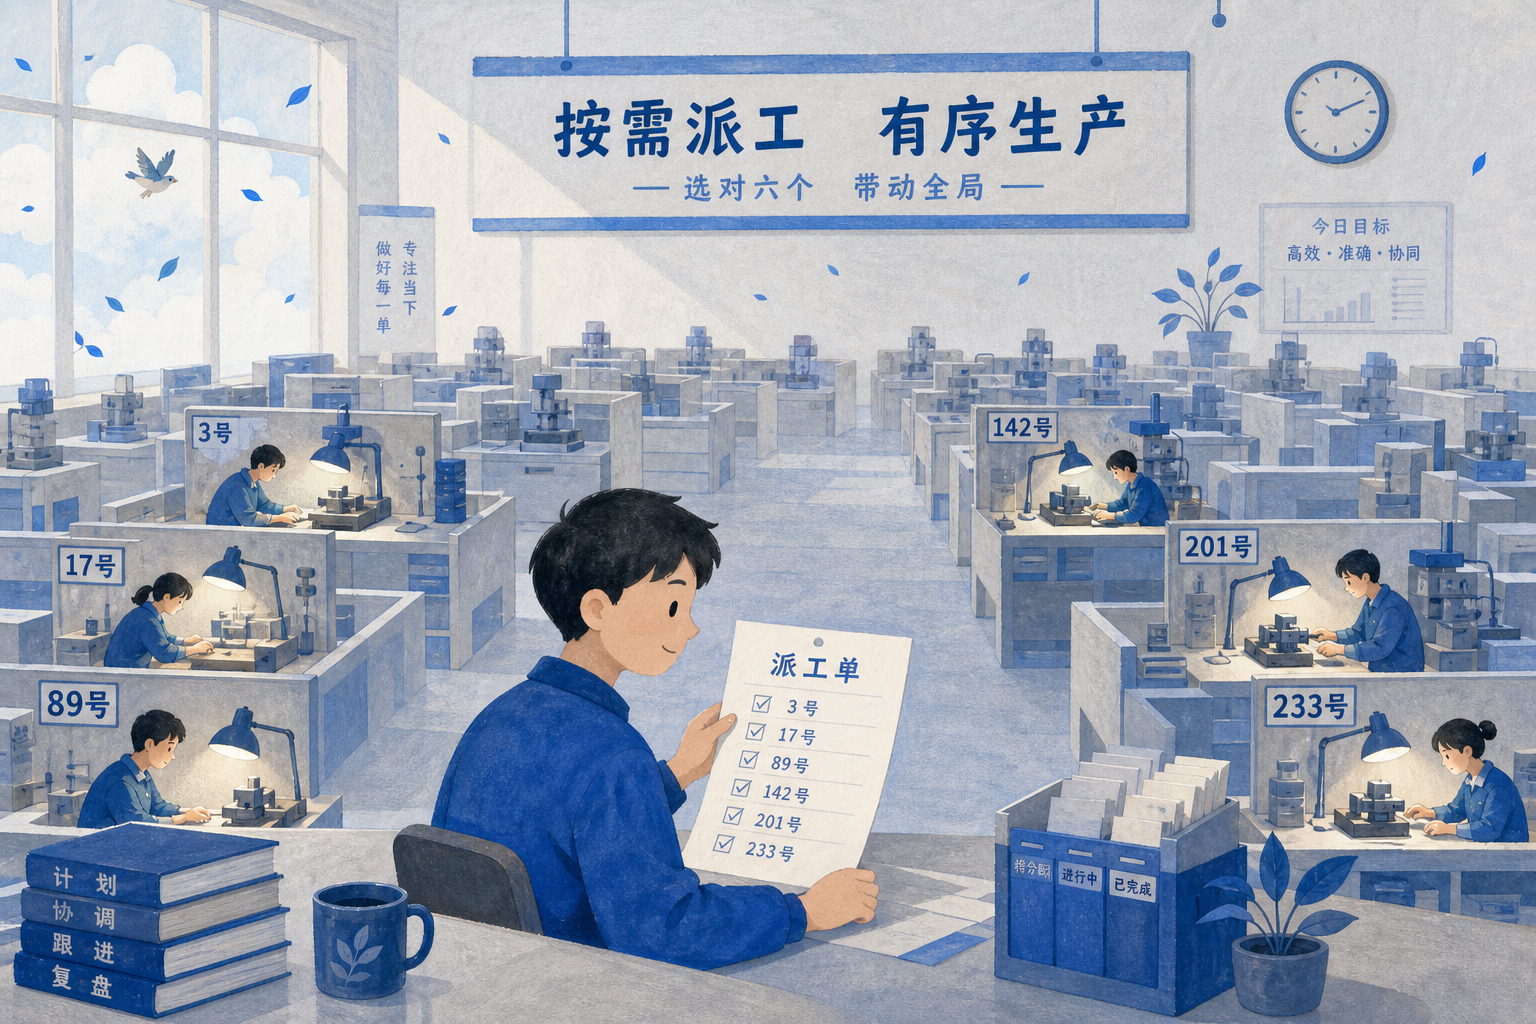
这就是混合专家架构的核心:总参数量巨大,但每次推理只激活极少一部分。DeepSeek V4 Flash 有 2840 亿总参数,但每处理一个 token,实际干活的只有约 130 亿。计算量被压到了传统架构(所有参数每次计算都被激活)的几分之一——训练成本也因此大幅降低。
但这里有一个被几乎所有宣传稿略过的关键矛盾。
虽然每次只叫 6 个工位干活,但这 256 个工位必须全部留在厂房里——你不能把不干活的设备搬走,因为下一个 token 可能恰好需要它们。所有专家权重必须常驻内存。换句话说,混合专家架构把"计算量"和"内存量"解耦了:计算很省,内存很费。
这就是为什么混合专家模型在云端跑得好好的,一搬到本地就抓瞎——你的 Mac 有很强的 CPU 和 GPU,但它的内存就那么点。DeepSeek V4 Flash 的原始权重高达数百 GB,什么 Mac 都塞不下。
那么问题来了:antirez 是怎么把它塞进去的?
只压缩"临时工",不碰"常驻员工"
他的答案可以用一个词概括:区别对待。
学术上叫"非对称量化"。但理解它,不需要先理解量化是什么。我们回到那个工厂。
256 个工位的操作手册,能不能印成简写版?仔细想想:每个工位只处理大约 2% 的工作单(6/256),而且它的输出会被和其他 5 个工位的输出混合在一起。如果你把第 89 号工位的操作手册印得潦草一点——偶尔看错一两个数字——这个错误被稀释到 6 个工位的总分里,很可能察觉不到。
但调度员的工作手册绝不能潦草。调度员经手每一张工作单。如果它把"应该派第 89 号"看成了"派第 98 号",整个推理链条从根上就歪了,后面再精确也白搭。同理,质检台——那个每张工作单都必须经过的共享专家——也必须保留全精度。还有内部通讯系统(注意力机制),每一条信息都经过它传递,一旦模糊,全局污染。
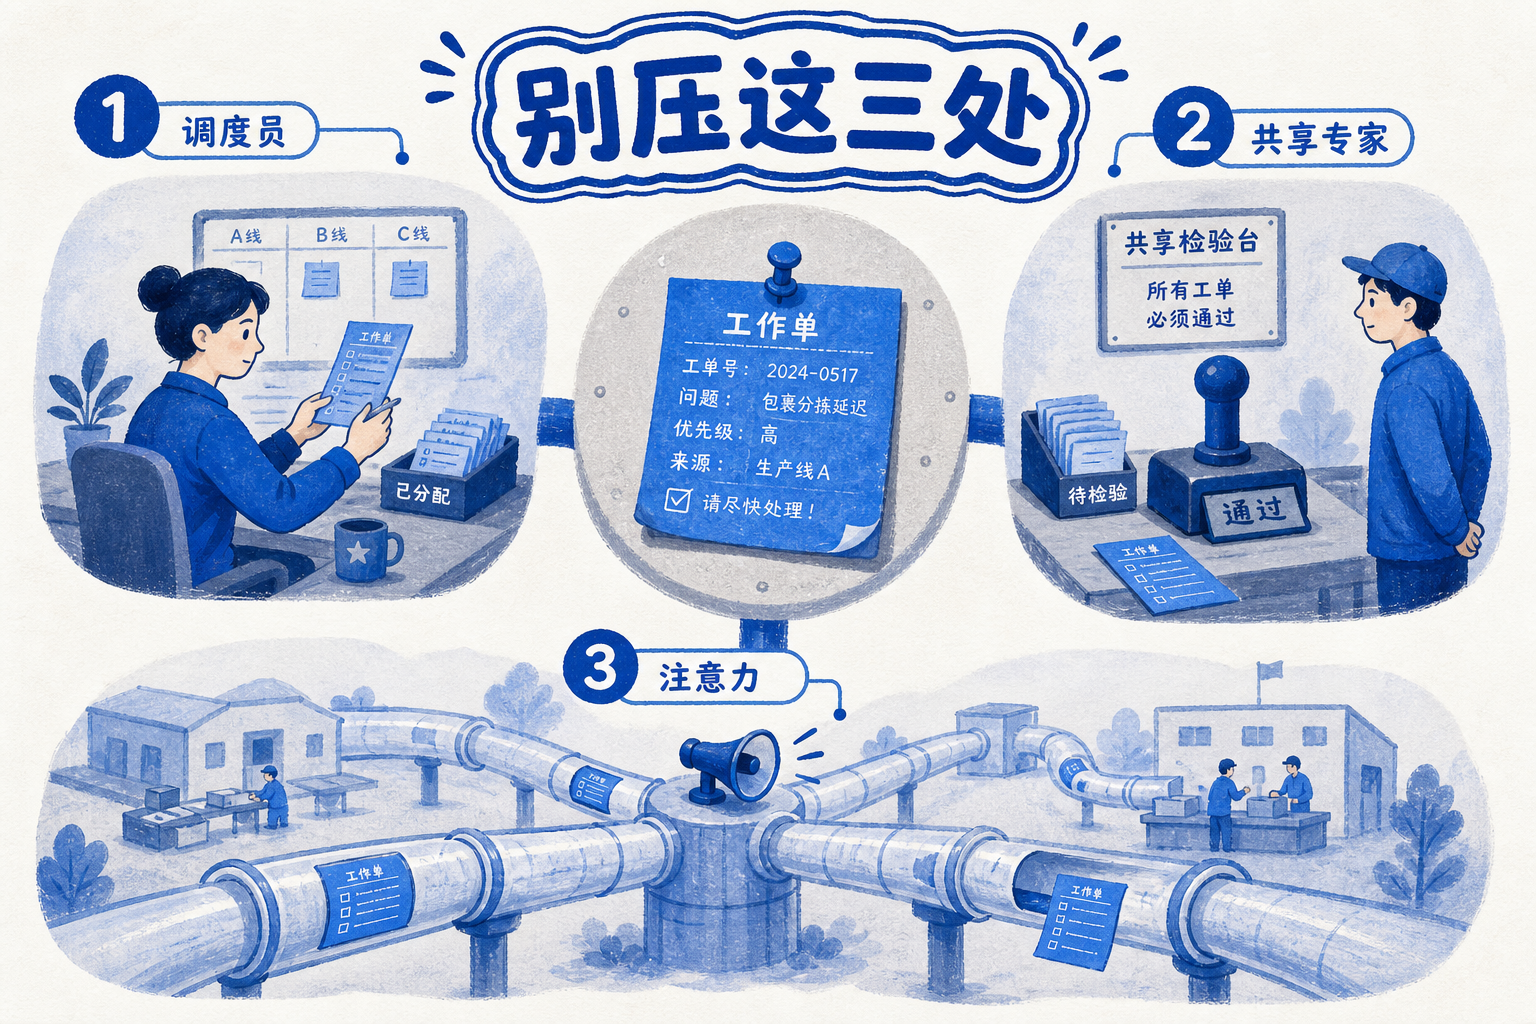
antirez 的策略精确地建立在这个直觉上:路由专家(那 256 个工位)压到极致——每个参数只用约 2 个比特来表示,精度损失巨大但影响分散;共享专家、注意力投影、路由器、输出头——这些"常驻员工"——保留 8 比特甚至全精度。整条因果链不容有一环松动。
这不是他凭空想出来的。DeepSeek 官方发布的 V4 Flash 本身就是混合精度的——专家参数用 4 比特存储、其余部分用 8 比特。antirez 把这个原则推到了更极端的 2/8 比特配比。结果呢?模型从数百 GB 被压到了约 81 GB,刚好能塞进一台 96 GB 内存的 Mac。
这种"只压可重建组件、保真不可重建锚点"的策略,在工程史上反复出现过。你每次看视频拖进度条时就在用它——视频编码里的 I 帧是完整画面、几乎不压缩,是随机访问的锚点;P 帧和 B 帧只记录和前一帧的差异、压缩到极致,因为即使丢了几帧差异数据,下一个 I 帧一来就能"修复"。还有数据库的预写日志——关键操作记录保持全精度、优先落盘,海量数据页则可以延后压缩。同一条古老智慧:把精度花在错误比特会改变全局轨迹的地方。
现在来看实际效果。在一台 M5 Max、128 GB 内存的 Mac 上,DS4 跑 DeepSeek V4 Flash 的量化版,能在 2048 token 的上下文里达到每秒 790 个 token 的预处理速度,生成速度每秒 39 个 token——大概是一秒打出两行字的节奏,基本可用了。在一台 DGX Spark 上,预填充速度甚至更快,每秒 826 个 token。要知道,这两个数字在 antirez 重写底层 GPU 代码之前,分别只有 344 和 13.8。
但这里需要一次诚实的停顿。每秒 39 个 token,是"能用",不是"畅快"。云端 API 的同等模型大概快 3 到 5 倍。本地推理和省钱、隐私之间,从来有一个速度换自由的等式。
当 AI 不再需要联网,谁赢了,谁慌了?
这个等式正在改变。
MIT 的一项研究算了一笔账:开放模型在自有硬件上推理的成本大约是每百万 token 0.23 美元,而闭源 API——OpenAI、Anthropic 的云端服务——是 1.86 美元,差了 8 倍。一家叫 EdgeRunner 的公司实测发现,用本地模型做代码助手,每个开发者每月省下约 9000 美元。这不是零钱。
但钱只是故事的一半。更重要的变量是"谁能跑"。
2025 年初,美国海军以安全为由禁止使用 DeepSeek 的云端服务。意大利、澳大利亚政府也相继跟进。禁令之下,本地部署成了唯一合法的替代路径——数据不出机器,监管就无从插手。对医疗、法律、金融这些受严格合规约束的行业,本地推理不是"更便宜的选择",而是"唯一的选择"。
被挤压的那一方显而易见:闭源 API 供应商。MIT 的数据显示,在 AI 模型调用平台 OpenRouter 上,96% 的收入流向闭源模型。这个数字随着本地推理门槛的每一次下降,都在被蚕食。市场研究机构 Gartner 甚至预测,到 2028 年,企业的 token 支出将追平员工薪资。
但别急着宣布"本地推理时代到来"。DS4 面向的是 128 GB 内存的机器——M5 Max 的起步价不便宜,DGX Spark 更是专业级设备。这不是人手一台的东西。真正能用上本地前沿模型的人,在今天仍然是一小撮:有高配硬件的开发者、有合规刚需的机构、有隐私偏执的研究者。
Vitalik Buterin——以太坊的创始人,也是个本地推理的狂热实践者——在搭建自己的本地 AI 环境后写下一句警告:本地不等于隐私。恶意技能指令、软件悄悄回传的遥测数据、模型后门——数据不出机器只是隐私架构的一环,不是全部。
但量化不是免费的午餐
还有一层更根本的限制。
把专家权重压到 2 比特,真的"几乎无损"吗?答案是:看情况。
一项研究测试了量化对数学推理的影响,发现在 MATH 基准(一套标准数学推理测试)上,低比特量化最高能让准确率跌掉 32 个百分点。更麻烦的是,题目越难,掉点越多——竞赛级难题的退化幅度是简单题的四倍。还有混合专家模型特有的问题:量化会扰动路由决策——调度员拿到的工位能力报告变模糊了,就可能把任务派给错误的对象。
但这里有一个关键的分岔。Red Hat 做了 50 万次评测后发现,4 比特量化在大多数通用基准上能恢复 99% 的精度,超大模型(700 亿参数以上)几乎无损。而 antirez 的非对称策略恰好把精度花在了刀刃上——路由器和共享路径保持高精度,被压到 2 比特的只有那些"出错也不致命"的专家。这不等同于"均匀地把整个模型压到 2 比特"。后者的确会崩——有人测试过,把 DeepSeek-R1 全部压到 1.58 比特,结果是无限循环乱码、评测零分。
非对称量化踩住了一条钢丝:够激进以塞进消费级硬件,够保守以保住推理质量。但它不是魔法。多步数学推理、高可靠性代码生成、需要精确校准的领域——本地 2 比特模型还不适合。
适合什么?适合日常问答、代码辅助、文档分析、本地 agent 长期运行——那些占了 AI 日常使用的绝大多数场景,不再需要把数据送到别人的服务器上。
antirez 用一周时间和一个 MIT 开源许可证,把"前沿模型只能活在云端"的默认假设撕开了一道口子。这道口子不会一夜之间改变所有人的 AI 使用方式,但它改变了方向:以前是"模型越大越离不开云",现在是"架构选对了、精度分配对了,192 GB 的统一内存就是一台微型服务器"。
过去 AI 的默认路径是远程,DS4 从相反的约束出发,走到了同一个终点。区别在于,这一次,终点停在了你的桌面上。